Todas las sesiones se congelan a la vez y el log queda impoluto: Hermes retira del event loop ocho bloqueos medidos
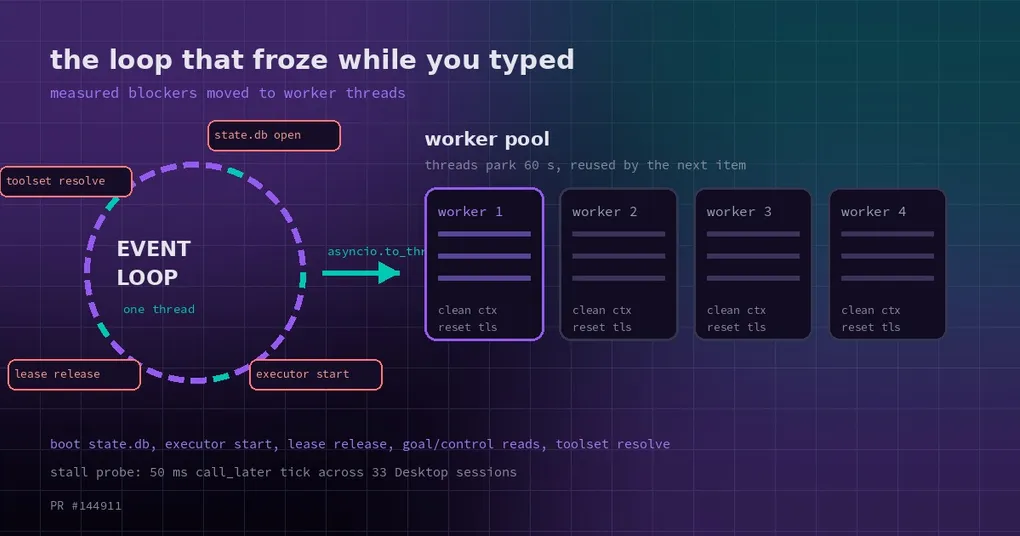
Es miércoles por la tarde y estás a mitad de una frase en Desktop cuando la ventana deja de responder: el cursor sigue parpadeando, pero no entra nada, y la lista de sesiones de la barra lateral se ha quedado congelada a medio scroll. Esperas treinta segundos y vuelve sola, o reinicias y vuelve igual. Luego abres el log para ver qué ha pasado y no hay nada: ni un aviso, ni una sola línea. No era el modelo ni la red: el backend de Desktop, el gateway, corre sobre un event loop de asyncio en un único hilo, y todo lo que espera al disco en ese hilo hace que todas las sesiones esperen con él.
El event loop es un solo cajero con todas las sesiones en la cola
El gateway es el proceso que hay detrás de Desktop. Gestiona el almacenamiento de sesiones, las llamadas a herramientas, el cron y el state.db de cada profile. No lanza un hilo por tarea: usa asyncio para turnarse en un solo hilo — leer un frame de WebSocket, empujar un token, escribir una sesión, ejecutar una herramienta — de uno en uno, cada paso lo bastante rápido como para que parezca concurrente.
Ese modelo se sostiene sobre una suposición: cada uno de esos turnos tiene que ser rápido. En el momento en que uno se queda esperando al disco — abrir una base de datos, tomar un file lock, reescribir un bloque JSON — el hilo se detiene y no ocurre nada más. Tus pulsaciones dejan de reflejarse, una respuesta en streaming muere a mitad de frase, un cron job que ya tocaba no se dispara. El cajero está en el almacén buscando stock. Y el I/O bloqueante no lanza ninguna excepción: simplemente es lento. Por eso el log está limpio, y por eso este tipo de parón es tan difícil de demostrar.
Para la otra mitad de la historia — qué detecta un loop que ya se ha atascado — tienes el artículo sobre el watchdog del loop del gateway. Este va de por qué se atasca.
Ocho bloqueos, todos medidos
El PR #144911 (mergeado el 2026-10-27, merge commit b63fbbac4d27d1e4b8585ff7065e6dceb6207394) no fue a ciegas. Cada uno de los ocho corresponde a una ruta que alguien podía reproducir, y entre todos cierran los issues #141966, #142085 y #142061.
-
Las lecturas de sesión esperaban hasta 5 segundos al escritor de tokens (#141966).
get_session,list_sessions_rich,get_recent_session_model_routeylist_gateway_sessionsson lecturas puras, pero se quedaban esperando a un escritor que estaba en mitad de persistir un token — cinco segundos en el peor caso. El arreglo da a las lecturas su propio modo de flush: en el hilo del loop nunca espera, y fuera del hilo del loop espera como antes. Solo una espera en el hilo del loop gasta el tiempo de todos los demás para ahorrarse el suyo. -
La sonda de liveness retenía el GIL en Windows (#142085, del contribuidor de la comunidad @zwmaupin). Una sonda de psutil en Windows puede retener el lock del intérprete el tiempo suficiente para que el hilo del loop no lo consiga, y eso es una parada en seco del event loop. Esta se recuperó del fork de @zwmaupin, manteniendo la autoría.
-
El arranque abría el
state.dbde cada profile en el loop. Cada apertura construye el esquema y el índice FTS — más o menos un segundo por store — y antes ocurría en el hilo del loop, así que cuantos más profiles, más largo era el tramo muerto al arrancar. Ahoraopen_profile_storeabre dentro de un hilo con el ámbito del profile ligado a ese hilo, los profiles secundarios se precalientan en paralelo, y el store que el arranque necesita de verdad queda fijado por un worker alrededor deGatewayRunner(), de modo que la apertura propia del store pasa a ser un hit del registro y no toca el fichero. -
Cada submit al executor arrancaba un hilo nuevo en el loop (#142061).
Thread.start()espera al GIL, lo que significa que el propio acto de delegar trabajo consumía tiempo del loop. Es el más interesante de los ocho y tiene su propia sección más abajo. -
La carga del gestor de goals/loops y el snapshot de la control card después de cada turno leían ambos
state.db, ambos en el loop. -
La resolución de display/toolset por turno tomaba el file lock del auth store. Ahora pasa por
asyncio.to_thread, con el contexto copiado llevando el ámbito de profile de ese turno. -
restore_local_sessionesperaba astore._lockpor sesiones vivas. Un worker que escribe enstate.dbmantiene ese lock, así que restaurar una sesión podía colgar todo el loop detrás. El arreglo encontró un hueco preciso: cuando la ruta ya nombra un destino y ese destino está en el linaje, la rama bloqueada no hace absolutamente nada — ese caso ahora retorna sin tomar el lock. -
La liberación del lease de sesión activa al final de cada turno hacía un file lock más una reescritura de JSON. También se movió fuera del loop.
Seis de los ocho eran «tocar disco en el loop», uno era «pelearse por el GIL en el loop» y uno era «arrancar un hilo en el loop». Si te quedas con una sola regla: nada que pueda esperar tiene nada que hacer en el hilo del loop.
Aparcar un hilo durante 60 segundos
El punto 4 merece lectura atenta, porque no reubica una llamada: cambia el comportamiento de un pool.
El executor era sencillo: llega una tarea, arranca un hilo, el hilo termina y muere. El pool no tiene límite por diseño (ese contrato y el tope de hilos del sistema no cambian), así que bajo carga estaba creando y enterrando hilos de forma continua, y cada Thread.start() hacía cola detrás del GIL en el hilo del loop.
Ahora un worker que termina no muere: queda aparcado 60 segundos (_IDLE_TIMEOUT_S = 60.0 en el código). El siguiente submit le pasa la tarea a un worker aparcado a través de una cola, y solo se crea un hilo cuando no hay ningún worker aparcado. El pool sigue sin límite, el contrato se mantiene y, en régimen estable, casi no se crean hilos.
El peligro de reutilizar un hilo es el estado residual: un contextvar, un flag de interrupción, un thread-local del trabajo anterior guiando en silencio el siguiente. Ahí se fue la mayor parte del cuidado de este cambio. Cada tarea corre en un contextvars.Context vacío, y gateway/turn_thread_reset.py limpia los residuos de ese hilo:
- el bit
tools.interruptdel hilo; - el motivo y el yield del turno;
- el ámbito de hilo de la caché de sudo;
- el namespace de
threading.localpor turno.
Un worker que no consigue resetearse se retira en lugar de aceptar más trabajo: mejor quedarse corto de un hilo que dejar que el estado sucio se filtre al turno siguiente. _threads sigue listando solo los hilos ocupados, así que el conteo del drain al apagar queda intacto.
Llegar tarde vale. Llegar desordenado, no.
El coste que se olvida al mover trabajo a hilos es el orden. Aquí se diseñaron tres puntos alrededor de eso.
Números de ticket para los snapshots. El snapshot de la control card ahora se lee en un worker y se publica de forma asíncrona, pero publish_async toma un ticket en el loop primero. Un snapshot que llega tarde y ya ha sido sustituido por una publicación posterior se descarta, así que la UI nunca ve datos viejos pintados encima de los nuevos. La republicación por herramienta sigue siendo síncrona, porque test_session_viewer_automation exige que se complete dentro de un único paso del loop.
Un solo worker ordenado para liberar leases. Cada liberación (file lock más reescritura de JSON) va al mismo worker ordenado. Si una liberación llega después del siguiente acquire sobre la misma sesión, no hace nada: las entradas se descartan por lease id, así que una liberación tardía no puede pisar el turno que acaba de ocupar el hueco. El docstring del módulo en gateway/active_lease_io.py es explícito sobre el límite: solo se difiere la escritura del fichero, el lease ya está liberado desde el punto de vista de este proceso cuando release_soon retorna, así que la siguiente reserva sigue viendo el hueco libre; enrutar todas las liberaciones por un mismo worker es lo que mantiene el descarte persistido en orden de finalización de turno; y la ruta del registro queda fijada en el momento del acquire, así que el worker no necesita ámbito de profile.
Los contextos copiados llevan el ámbito de profile. El to_thread del punto 6 no es una llamada pelada: el contexto que copia lleva el ámbito de profile de ese turno, o la resolución de display/toolset dentro del hilo caería al profile por defecto.
El hilo común: diferir solo es seguro cuando el resultado converge al mismo estado. Donde el orden significa algo, toma un ticket o ponte en la cola.
Cómo comprobarlo: mide cuánto tiempo estuvo parado el loop, no cuánto tardó una petición
Este tipo de bug no se encuentra con latencia por petición. Bajo carga todas las peticiones parecen simplemente lentas, mientras lo que vive el usuario es que todo se para a la vez. La configuración de medición del PR merece copiarse:
Un gateway run --force real en modo multiplex, 11 profiles, 33 sesiones WebSocket concurrentes con la forma de Desktop, un cron job por profile por minuto y un provider de tool-calls en loopback. Dos sondas inyectadas vía sitecustomize: una sonda de latencia del loop con call_later de 50 ms, y un sampler de parones que captura stacks cuando el loop deja de girar, para que puedas ver quién está esperando. Cada ronda dura 90 segundos, con PYTHONPATH fijando el árbol de código para que estés midiendo el código que querías medir. Segundos de parón = muestras de parón del loop principal × 20 ms.
Lo importante de esa configuración no son los números: es que mide cuánto tiempo estuvo el loop sin girar, que es exactamente lo que sienten tus dedos.
Haz el triaje igual. Si solo tartamudea el tecleo mientras las respuestas siguen llegando, eso es la ruta de renderizado — mira por qué el tecleo se degrada en sesiones largas. Si el tecleo y las respuestas se paran juntos, se recuperan solos a los pocos segundos y dejan un log limpio, el loop estaba ocupado. Y si lo lento es el momento de lanzar la app, eso es un tercer problema distinto, tratado en latencia de arranque y limpieza de scratch.
Qué versiones, y qué hacer ahora
El arreglo entró en main el 2026-10-27. Si sigues el canal estable, te llegará en la próxima release que lo incluya; si lo quieres ya, pásate a seguir main. De los tres issues, #142085 es el que los usuarios de Windows reconocerán al instante: una tool call que empieza y toda la interfaz que se queda de madera es esa firma.
Mientras tanto, unas cuantas cosas le dan más aire al loop: menos ventanas de Desktop abiertas durante horas (cada una es una sesión WebSocket empujando mensajes de forma continua), desactivar el cron en los profiles que no uses y no apilar docenas de sesiones concurrentes sobre un mismo gateway. El entorno de pruebas de este PR eran 11 profiles con 3 sesiones cada uno: eso ya es el caso de estrés.
La huella dactilar de este tipo de parón
Un modelo lento y un loop atascado no se parecen en nada, y distinguirlos es la mayor parte del debugging. Modelo lento: los tokens llegan de uno en uno, la UI sigue respondiendo, puedes escribir y cambiar de sesión. Loop atascado: todas las sesiones se congelan simultáneamente, incluidas las que no están llamando a ningún modelo; el log no tiene errores, porque bloquear no es una excepción; y se recupera solo, porque la operación de disco acabó por terminar.
El tercer caso es el peor, porque no está lento: está parado. Y un event loop parado se parece exactamente a una máquina rota, cuando lo único que hacía era esperar a una escritura de fichero. Lo que hace este cambio es mandar esa escritura a esperar a otro sitio.