Toutes les sessions se figent en même temps, le journal reste vide : Hermes sort huit blocages mesurés de l’event loop
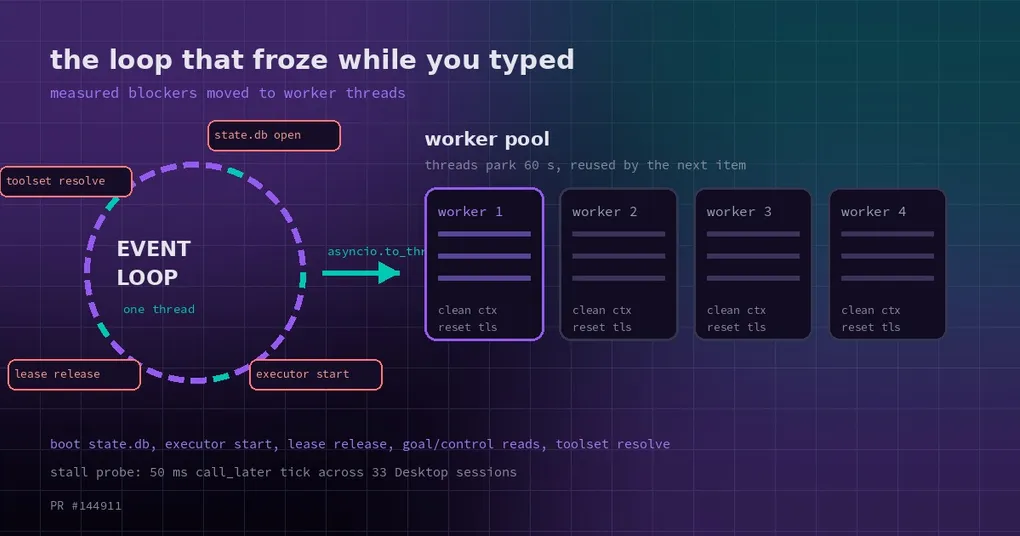
Un mercredi après-midi, vous êtes au milieu d’une phrase dans Desktop quand la fenêtre cesse de répondre : le curseur clignote encore, mais rien n’arrive, et la liste des sessions dans la barre latérale reste figée en pleine glissade. Vous attendez trente secondes et tout revient tout seul — ou vous redémarrez, et ça revient pareil. Puis vous ouvrez le journal pour voir ce qui s’est passé : rien. Pas un avertissement, pas une ligne. Ce n’était ni le modèle ni le réseau : le backend de Desktop, le gateway, tourne sur une event loop asyncio mono-thread, et tout ce qui attend le disque sur ce thread fait attendre toutes les sessions avec lui.
L’event loop, c’est un seul caissier avec toutes les sessions en file
Le gateway est le processus derrière Desktop. Il possède le stockage des sessions, les appels d’outils, le cron et le state.db de chaque profile. Il ne lance pas un thread par tâche. Il utilise asyncio pour prendre les tours sur un seul thread — lire une frame WebSocket, pousser un token, écrire une session, exécuter un outil — une chose à la fois, chacune assez rapide pour donner l’illusion du parallélisme.
Ce modèle repose sur une hypothèse : chacun de ces tours doit être rapide. Dès que l’un d’eux attend le disque — ouvrir une base de données, prendre un verrou de fichier, réécrire un blob JSON — le thread s’immobilise et plus rien d’autre ne se produit. Vos frappes cessent de s’afficher, une réponse en streaming meurt en pleine phrase, un job cron arrivé à échéance ne se déclenche pas. Le caissier est à l’arrière en train de chercher du stock. Et l’I/O bloquant ne lève rien : il est simplement lent. D’où le journal impeccable, et d’où la difficulté à démontrer ce genre de blocage.
Pour l’autre moitié du tableau — ce qui rattrape une boucle déjà bloquée — voyez le watchdog de la boucle gateway. Ici, il s’agit de la cause du blocage.
Huit blocages, tous mesurés
La PR #144911 (fusionnée le 2026-10-27, commit de merge b63fbbac4d27d1e4b8585ff7065e6dceb6207394) n’a rien deviné. Chacun des huit correspond à un chemin que quelqu’un pouvait reproduire, et ensemble ils ferment #141966, #142085 et #142061.
-
Les lectures de session attendaient jusqu’à 5 secondes le writer de tokens (#141966).
get_session,list_sessions_rich,get_recent_session_model_routeetlist_gateway_sessionssont de pures lectures, mais elles attendaient un writer en train de persister un token — cinq secondes dans le pire des cas. Le correctif donne aux lectures leur propre mode de flush : sur le thread de la boucle, elles n’attendent jamais ; hors de ce thread, elles attendent comme avant. Seule une attente sur le thread de la boucle fait payer aux autres le temps qu’elle s’épargne. -
La sonde de liveness tenait le GIL sous Windows (#142085, du contributeur @zwmaupin). Une sonde psutil sous Windows peut tenir le verrou de l’interpréteur assez longtemps pour que le thread de la boucle ne parvienne plus à l’obtenir — arrêt complet de l’event loop. Ce correctif est récupéré du fork de @zwmaupin, avec la paternité conservée.
-
Le démarrage ouvrait le
state.dbde chaque profile sur la boucle. Chaque ouverture construit le schéma et l’index FTS — environ une seconde par store — et cela se faisait sur le thread de la boucle : plus de profils, donc un trou plus long au démarrage. Désormaisopen_profile_storeouvre dans un thread avec le scope du profil lié dans ce thread, les profils secondaires se préchauffent en parallèle, et le store dont le démarrage a réellement besoin est épinglé par un worker autour deGatewayRunner(), si bien que l’ouverture du store devient un simple hit de registre et ne touche jamais le fichier. -
Chaque submit de l’executor lançait un nouveau thread sur la boucle (#142061).
Thread.start()attend le GIL : le simple fait de passer du travail coûtait donc du temps de boucle. C’est le plus intéressant des huit, et il a sa propre section plus bas. -
Le chargement du gestionnaire goal/loop et le snapshot de la control card après chaque tour lisaient tous deux
state.db, tous deux sur la boucle. -
La résolution affichage/toolset à chaque tour prenait le verrou de fichier de l’auth store. Elle passe maintenant par
asyncio.to_thread, le contexte copié portant le scope de profil de ce tour. -
restore_local_sessionattendaitstore._lockpour les sessions live. Un worker qui écrit dansstate.dbdétient ce verrou, donc restaurer une session pouvait suspendre toute la boucle derrière lui. Le correctif a trouvé un trou précis : quand la route désigne déjà une cible et que cette cible figure dans la lignée, la branche verrouillée ne fait strictement rien — ce cas retourne désormais sans prendre le verrou. -
La libération du lease de session active en fin de tour faisait un verrou de fichier plus une réécriture JSON. Déplacée hors de la boucle, elle aussi.
Six des huit consistaient à « toucher le disque sur la boucle », un à « se battre pour le GIL sur la boucle », un à « démarrer un thread sur la boucle ». S’il ne fallait retenir qu’une règle : rien de ce qui peut attendre n’a sa place sur le thread de la boucle.
Parquer un thread pendant 60 secondes
L’item 4 mérite une lecture attentive, parce qu’il ne déplace pas un appel : il change le comportement d’un pool.
L’executor était simple : une tâche arrive, un thread démarre, le thread finit et meurt. Le pool est non borné par conception (ce contrat, comme le plafond de threads de l’OS, sont inchangés), donc sous charge il démarrait et enterrait des threads en continu, et chaque Thread.start() faisait la queue derrière le GIL sur le thread de la boucle.
Désormais, un worker qui termine ne meurt pas. Il se parque 60 secondes (_IDLE_TIMEOUT_S = 60.0 dans le code). Le submit suivant confie sa tâche à un worker parqué via une queue ; un thread n’est créé que si aucun worker n’est parqué. Le pool reste non borné, le contrat tient, et en régime stable presque aucun thread n’est créé.
Le danger, quand on réutilise un thread, c’est l’état résiduel : un contextvar, un flag d’interruption, un thread-local du job précédent qui oriente discrètement le suivant. C’est là qu’est allé l’essentiel du soin apporté à ce changement. Chaque tâche s’exécute dans un contextvars.Context vide, et gateway/turn_thread_reset.py efface les résidus du thread :
- le bit
tools.interruptdu thread ; - la raison et le yield du tour ;
- le scope thread du cache sudo ;
- l’espace de noms
threading.localpropre au tour.
Un worker qui échoue à se réinitialiser prend sa retraite au lieu de reprendre du travail — mieux vaut un thread de moins qu’un état sale qui fuit dans le tour suivant. _threads ne liste toujours que les threads occupés, donc le comptage de drain à l’arrêt n’est pas touché.
En retard, soit. Dans le désordre, non.
Le coût qu’on oublie quand on déplace du travail vers des threads, c’est l’ordre. Trois endroits ont été conçus autour de ça ici.
Des tickets pour les snapshots. Le snapshot de la control card est désormais lu dans un worker et publié de façon asynchrone, mais publish_async prend d’abord un ticket sur la boucle. Un snapshot qui arrive en retard et a déjà été supplanté par une publication plus récente est jeté : l’UI ne voit jamais de vieilles données repeintes par-dessus des neuves. La republication par outil reste synchrone, car test_session_viewer_automation exige qu’elle s’achève en une seule étape de boucle.
Un worker ordonné unique pour la libération des leases. Chaque libération (verrou de fichier plus réécriture JSON) part vers le même worker ordonné. Si une libération arrive après la prise suivante sur la même session, elle ne fait rien — les entrées sont écartées par lease id, donc une libération tardive ne peut pas écraser le tour qui vient de reprendre le créneau. La docstring du module gateway/active_lease_io.py est explicite sur la frontière : seule l’écriture fichier est différée ; du point de vue de ce processus, le lease est déjà libéré quand release_soon rend la main, donc la prise suivante voit toujours le créneau libre ; router toutes les libérations vers un worker unique, c’est ce qui préserve l’ordre de fin de tour pour la mise à l’écart persistée ; et le chemin du registre est figé au moment de l’acquisition, si bien que le worker n’a pas besoin du scope de profil.
Les contextes copiés portent le scope de profil. Le to_thread de l’item 6 n’est pas un appel nu : le contexte qu’il copie porte le scope de profil du tour, sinon la résolution affichage/toolset à l’intérieur du thread retomberait sur le profil par défaut.
Le fil conducteur : différer n’est sûr que si le résultat converge vers le même état. Là où l’ordre fait sens, on prend un ticket ou on fait la queue.
Comment le vérifier : mesurer la durée d’arrêt de la boucle, pas la lenteur d’une requête
On ne trouve pas cette classe de bug avec la latence par requête. Sous charge, chaque requête paraît simplement lente, alors que ce que vit l’utilisateur, c’est un arrêt simultané de tout. Le dispositif de mesure de la PR mérite d’être copié :
Un vrai gateway run --force en mode multiplex, 11 profils, 33 sessions WebSocket concurrentes de forme Desktop, un job cron par profil et par minute, et un provider d’appels d’outils en loopback. Deux sondes injectées via sitecustomize : une sonde de latence de boucle call_later à 50 ms, et un échantillonneur de blocages qui capture les stacks quand la boucle cesse de tourner, pour voir qui attend. Chaque round dure 90 secondes, avec PYTHONPATH épinglant l’arbre de code pour mesurer le code voulu. Secondes de blocage = échantillons de blocage de la boucle principale × 20 ms.
Ce dispositif ne vaut pas pour ses chiffres. Il vaut parce qu’il mesure combien de temps la boucle est restée sans tourner — exactement ce que vos doigts ressentent.
Le tri se fait de la même manière. Si seule la frappe saccade pendant que les réponses continuent d’arriver, c’est le chemin de rendu — voyez pourquoi la frappe se dégrade dans les longues sessions. Si la frappe et les réponses s’arrêtent ensemble, repartent seules après des dizaines de secondes et laissent un journal propre, la boucle était occupée. Et si ce qui est lent, c’est le moment du lancement, c’est un troisième problème, traité dans latence au démarrage et nettoyage du scratch.
Quelles versions, et que faire maintenant
Le correctif a été fusionné dans main le 2026-10-27. Si vous suivez le canal stable, il vous parviendra dans la prochaine release qui l’embarque ; si vous le voulez aujourd’hui, suivez main. Des trois issues, #142085 est celle que les utilisateurs Windows reconnaîtront immédiatement — un appel d’outil qui démarre et toute l’UI qui se fige d’un coup : c’est la signature.
En attendant, quelques réglages donnent de l’air à la boucle : moins de fenêtres Desktop gardées ouvertes longtemps (chacune est une session WebSocket qui pousse des messages en continu), couper le cron pour les profils que vous n’utilisez pas, et éviter d’empiler des dizaines de sessions concurrentes sur un seul gateway. L’environnement de test de cette PR, c’était 11 profils à 3 sessions chacun — déjà le cas de charge.
La signature de ce type de blocage
Un modèle lent et une boucle bloquée ne se ressemblent pas du tout, et les distinguer, c’est l’essentiel du débogage. Modèle lent : les tokens arrivent un par un, l’UI reste réactive, vous pouvez taper et changer de session. Boucle bloquée : toutes les sessions se figent simultanément, y compris celles qui n’appellent aucun modèle ; le journal ne contient aucune erreur, parce que bloquer n’est pas une exception ; et ça repart tout seul, parce que l’opération disque a fini par aboutir.
Le troisième cas est le plus vicieux, parce qu’il n’est pas lent : il est arrêté. Et une event loop arrêtée ressemble exactement à une machine en panne, alors qu’elle n’attendait qu’une écriture de fichier. Ce que fait ce changement, c’est envoyer cette écriture attendre ailleurs.