Por qué escribir va más lento cuanto más dura la sesión, y cómo Hermes Desktop recortó el coste a un tercio
Son las tres de la tarde y estás subiendo por una sesión que lleva abierta desde ayer, buscando las conclusiones a las que llegaste esta mañana. Llegas arriba, vuelves al cuadro de texto y empiezas a escribir; entonces te detienes. Los caracteres aparecen de uno en uno. Borrar un carácter tarda medio segundo. El cursor va un paso por detrás de tus dedos. Pruebas con otra máquina y la lentitud es la misma. Das por hecho que el modelo está ocupado en segundo plano, salvo que el modelo lleva un buen rato esperando a que termines la frase.
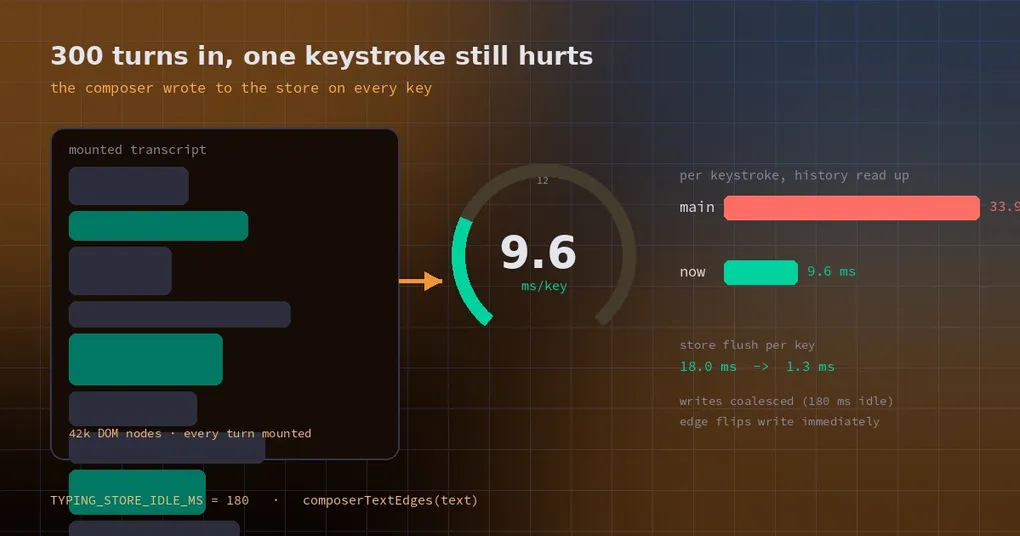
El problema estaba en la propia caja de entrada. Un cambio de rendimiento fusionado en Hermes Desktop el 26 de octubre (PR #144903) deja el mecanismo a la vista: cuanta más historia hay cargada, más lenta es la escritura, porque cada pulsación volvía a renderizar toda la transcripción. Después del arreglo, esa misma sesión de 300 turnos cuesta 9,6 ms de tiempo de hilo principal por tecla en lugar de 33,9 ms.
Una pulsación, un re-render completo
La superficie de chat del Desktop se apoya en assistant-ui, una librería de componentes para interfaces conversacionales. El texto de tu cuadro de entrada no vive tranquilo dentro del cuadro: es un valor de un store compartido, y una cantidad sorprendente de cosas están suscritas a él:
- si el botón de enviar está habilitado o en gris;
- si un
?suelto debe mostrar la pista de ayuda; - si la línea es un comando de barra (
/modely compañía) o un mensaje normal; - si se muestra el placeholder vacío;
- con qué criterio se maquetan los saltos de línea.
La sutileza es que comprobar esas suscripciones no se queda dentro del cuadro de entrada. Una escritura en el store vuelve a renderizar los recursos cliente del hilo y reevalúa los selectores de todos los mensajes montados. Más transcripción, más turnos montados, factura más alta. El comentario del código nuevo le pone cifra: aproximadamente 0,5 ms por pulsación en una sesión corta, y hasta 19 ms en cuanto la historia de una sesión larga está en pantalla; y eso es solo una parte del coste.
Lo cual explica la sensación tan poco intuitiva: la escritura no se degrada tanto según envejece la sesión como según subes hacia atrás. Es el scroll hacia arriba lo que de verdad monta la historia.
El arreglo: escribir en el store solo cuando cambia algo visible
El cambio no es un debounce pegado al cuadro de entrada. Convierte «¿cuándo tiene que llegar esta pulsación al store?» en lógica explícita. Un módulo nuevo, composer-store-writer.ts, deriva una firma del texto con composerTextEdges(text), exactamente los hechos que importan a los suscriptores:
text.length === 0                          // empty vs not
trimmed.length > 0                         // has real content
text === '?'                               // a lone question mark
trimmed.length > 0 && !SLASH_COMMAND_RE    // ordinary text, not a slash command
text.trimEnd().includes('\n')              // multi-line layout
Si una pulsación deja esa firma intacta, todos los suscriptores observarían el mismo estado, así que la escritura puede esperar. ¿Cuánto? TYPING_STORE_IDLE_MS = 180: una pausa de 180 ms escribiendo y el texto arrastrado aterriza en el store, donde lo leen la persistencia de borradores y el espejo del runtime.
Diferir escrituras exige cubrir los bordes, o cambias un retraso por un bug:
flush(): dejar el texto pendiente en su sitio antes de cualquier lectura que necesite el store al día;cancel(): descartar el texto pendiente al desmontar en vez de dejar estado obsoleto;observed(): adoptar como nueva base un cambio hecho en otro sitio del store (la suscripción del runtime), para que un valor viejo no pueda pisar uno nuevo.
La franja del prompt fijado (el cuadro de entrada replicado y anclado sobre una transcripción larga) también ha dejado de recalcular estilos para cada turno visible en cada frame; ahora registra una variable CSS una sola vez.
Las mediciones
El PR incluye un montaje reproducible: una sesión de 300 turnos y 1800 mensajes, recorrida con 2500 frames de rueda para que toda la historia quede montada (unos 42 000 elementos DOM), y después 60 caracteres escritos.
| Medida | Antes | Después |
|---|---|---|
| Tiempo de hilo principal por pulsación, historia leída hacia arriba | 33,9 ms | 9,6 ms |
| Tiempo de hilo principal por pulsación, apertura limpia | 12,1 ms | 6,0 ms |
| Flush del store por pulsación | 18,0 ms | 1,3 ms |
El autor es cuidadoso con lo que significan esos números, y su honestidad merece repetirse: ejecuciones sueltas en un host compartido, donde una segunda pasada previa al arreglo midió 49,3 ms por tecla. En esa máquina de 20 núcleos, el tiempo de entrada a pintado se quedó cerca de un frame en ambos casos, así que la diferencia entre 33,9 y 9,6 se nota sobre todo en hardware más lento, donde el tiempo de hilo principal es el recurso escaso. Esto no es «todo va tres veces más rápido»; es «tu portátil deja de pagar un impuesto por pulsación sobre una historia que ya renderizó».
Qué hacer con esto
El cambio está solo en main por ahora. La v0.22.5 salió el 23 de octubre y este PR se fusionó el 26, así que ni siquiera los tags canary de ese día lo contienen. Tres caminos:
- esperar a la próxima release y lanzar
hermes update, que es lo que menos trabajo da; - seguir
mainsi lo quieres hoy mismo (el cambio de canal se explica en la guía de canales de actualización); - aliviarlo ahora manteniendo sesiones más cortas: el coste del cuadro de entrada escala con la historia montada, así que abrir una sesión nueva o poner orden en los límites de sesión ayuda más que cualquier ajuste.
Si tu queja era en realidad «el Desktop tarda en arrancar», ese es otro problema, tratado en el análisis de la latencia de arranque. Este cambio no hace nada por él.
Por qué conviene recordar este caso
Por defecto culpamos al modelo cuando un agente se siente lento: demasiados tokens, demasiado contexto, un proveedor encolando peticiones. Este bug recuerda que la capa de interfaz genera su propia deuda de rendimiento, y que esa deuda es especialmente invisible: nunca aparece en un log ni en una traza, solo entre tus dedos y la pantalla.
Así que la próxima vez que algo vaya lento, pregúntate qué mitad va lenta. Escribir lento mientras las respuestas llegan con normalidad es un problema de renderizado. Si ambas cosas van lentas, es cuando toca mirar el modelo y la red. Dividir esa pregunta en dos ahorra la mayor parte del trabajo de depuración.