Por que digitar fica mais lento quanto mais a sessão dura — e como o Hermes Desktop cortou o custo em dois terços
São três da tarde e você está rolando de volta por uma sessão que roda desde ontem, procurando as conclusões a que chegou hoje de manhã. Chega ao topo, volta para o campo de texto e começa a digitar — e para. Os caracteres chegam um por um. Apagar um caractere leva meio segundo. O cursor fica um tempo atrás dos seus dedos. Você testa outra máquina; a mesma lentidão. Você presume que o modelo está ocupado em segundo plano, só que o modelo está ali, parado, esperando você terminar a frase.
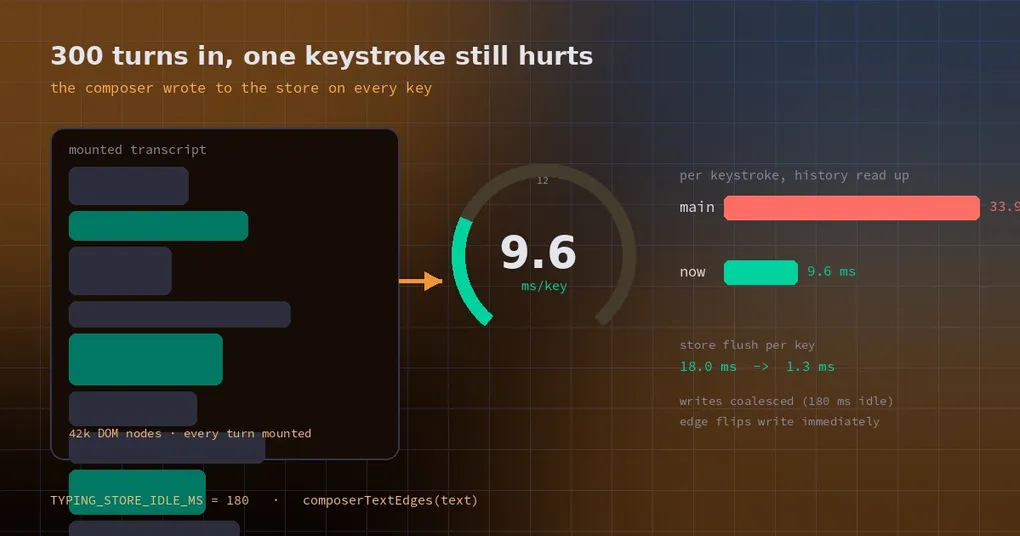
O problema era a própria caixa de entrada. Uma mudança de performance que entrou no Hermes Desktop em 26 de outubro (PR #144903) deixa o mecanismo explícito: quanto mais histórico carregado, mais lenta fica a digitação, porque cada tecla re-renderizava a transcrição inteira. Depois da correção, a mesma sessão de 300 turnos custa 9.6 ms de main thread por tecla em vez de 33.9 ms.
Uma tecla, um re-render completo
A superfície de chat do Desktop é construída sobre o assistant-ui, uma biblioteca de componentes para interfaces de conversa. O texto no seu campo de entrada não fica quieto lá dentro: ele é um valor num store compartilhado, e um número surpreendente de coisas assina esse valor —
- se o botão de enviar está habilitado ou apagado;
- se um
?sozinho deve fazer aparecer a dica de ajuda; - se a linha é um slash command (
/modele companhia) ou uma mensagem comum; - se o placeholder de vazio é exibido;
- como as quebras de linha são calculadas no layout.
A sutileza é que checar essas assinaturas não fica restrito ao campo de entrada. Uma escrita no store re-renderiza os client resources da thread e re-verifica os seletores de todas as mensagens montadas. Transcrição maior, mais turnos montados, conta maior. O comentário no código novo põe número nisso: mais ou menos 0.5 ms por tecla numa sessão curta, chegando a 19 ms quando o histórico de uma sessão longa está na tela — e isso é só uma parte do custo.
O que explica a sensação contraintuitiva: a digitação não piora conforme a sessão envelhece, e sim conforme você rola para trás. É rolar para cima que de fato monta o histórico.
A correção: escrever no store só quando algo visível muda
A mudança não é um debounce pregado no campo de entrada. Ela transforma “quando essa tecla precisa chegar ao store?” em lógica explícita. Um módulo novo, composer-store-writer.ts, deriva do texto uma assinatura com composerTextEdges(text) — exatamente os fatos com que os assinantes se importam:
text.length === 0                          // empty vs not
trimmed.length > 0                         // has real content
text === '?'                               // a lone question mark
trimmed.length > 0 && !SLASH_COMMAND_RE    // ordinary text, not a slash command
text.trimEnd().includes('\n')              // multi-line layout
Se uma tecla não mexe nessa assinatura, todo assinante veria o mesmo estado, então a escrita pode esperar. Esperar quanto? TYPING_STORE_IDLE_MS = 180 — uma pausa de 180 ms na digitação e o texto pendente cai no store, de onde a persistência de rascunho e o espelho do runtime o leem.
Adiar escritas exige cobrir as bordas, senão você troca lentidão por bug:
flush()— entregar o texto pendente antes de qualquer leitura que precise do store atualizado;cancel()— descartar o texto pendente no unmount em vez de deixar estado velho para trás;observed()— adotar como nova base uma mudança feita em outro lugar (a assinatura do runtime), para que um valor antigo não sobrescreva um novo.
A faixa de sticky prompt (o campo espelhado fixado acima de uma transcrição longa) também parou de recalcular estilos de todos os turnos visíveis a cada frame; agora ela registra uma variável CSS uma única vez.
As medições
O PR traz um setup reproduzível: uma sessão de 300 turnos / 1800 mensagens, percorrida com 2500 frames de scroll de roda para montar todo o histórico (mais ou menos 42k elementos DOM), e então 60 caracteres digitados.
| Medida | Antes | Depois |
|---|---|---|
| Tempo de main thread por tecla, histórico lido até o topo | 33.9 ms | 9.6 ms |
| Tempo de main thread por tecla, aberto do zero | 12.1 ms | 6.0 ms |
| Flush no store por tecla | 18.0 ms | 1.3 ms |
O autor é cuidadoso sobre o que esses números significam, e a honestidade vale repetir: execuções únicas num host compartilhado, onde uma segunda rodada antes da correção mediu 49.3 ms por tecla. Naquela máquina de 20 núcleos, o caminho de input até paint ficou perto de um frame nos dois casos — então a diferença entre 33.9 e 9.6 é sentida principalmente em hardware mais lento, onde o tempo de main thread é o recurso escasso. Isso não é “tudo ficou três vezes mais rápido”; é “seu notebook deixa de pagar um pedágio por tecla sobre um histórico que já foi renderizado”.
O que fazer com isso
A mudança está só na main por enquanto. A v0.22.5 saiu em 23 de outubro; este PR entrou em 26 de outubro, então nem as tags de canary daquele dia o contêm. Três caminhos:
- esperar o próximo release e rodar
hermes update— o menor esforço; - acompanhar a
mainse você quiser isso hoje (a troca de canal está em o guia de canais de atualização); - aliviar agora mantendo as sessões mais curtas — o custo do campo de entrada escala com o histórico montado, então começar uma sessão nova ou arrumar as fronteiras de sessão ajuda mais que qualquer configuração.
Se a sua queixa era na verdade “o Desktop demora a abrir”, esse é outro problema, tratado em o texto sobre latência de inicialização. Esta mudança não faz nada por ele.
Por que vale lembrar deste caso
Costumamos culpar o modelo quando um agente parece lento: tokens demais, contexto demais, um provider enfileirando requisições. Este bug é um lembrete de que a camada de UI acumula dívida de performance própria, e de que esse tipo de dívida é especialmente invisível — nunca aparece num log ou num trace, só entre os seus dedos e a tela.
Então, da próxima vez que parecer lento, pergunte qual metade está lenta. Digitação lenta com respostas chegando normalmente é problema de renderização. As duas lentas é quando você vai olhar o modelo e a rede. Separar essa pergunta em duas economiza a maior parte do debugging.