流一直在吐字,却永远不结束:给单个流式回复加上总时长上限
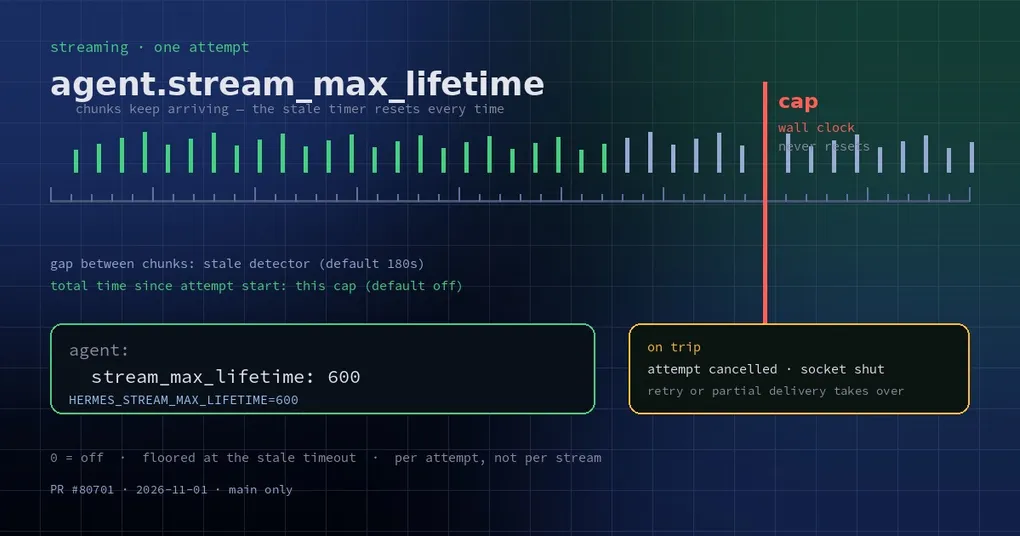
晚上十点,你发出一个请求,屏幕上开始出现文字。它一个字一个字地往外冒,看起来很努力,但就是不结束。二十分钟过去,光标还在闪,进度还在动——你既不敢按 Ctrl-C(怕丢掉已经生成的部分),也不知道它到底是在算,还是在原地转圈。
这种“永远差一点”的卡死,比彻底无响应更难受。而无响应至少有专门的看门狗处理:超过一定时间没有任何数据,就判定连接死了,重连或重试。可这条流每隔几秒就吐一点东西,看门狗每次都被喂饱,于是永远不触发。
两种卡死,只有一种被覆盖
Hermes 的流式超时是一层一层的。跟这件事直接相关的有两层:
- socket 读超时(默认 120 秒):多久收不到任何字节就认为连接异常;
- stale 流检测(默认 180 秒):多久没收到新 chunk 就判定这条流“僵住了”,掐掉重连。
关键在于后半句:stale 检测计的是两个 chunk 之间的间隔,而且每来一个 chunk 就重置计时。设计意图很合理——大模型在长时间思考时可能几十秒不吐字,不能因为“安静”就杀掉它。但它留下了一个明显的盲区:
| 失败形态 | 表现 | 旧机制是否处理 |
|---|---|---|
| 彻底静默 | 一个 chunk 都不来 | 会,stale 检测 180 秒后掐断 |
| 慢慢吐字但永不结束 | 每几秒来一点,永远不收尾 | 不会,每次都被重置 |
第二种在现实里并不少见:中继网关把响应切得极碎、上游在生成中途进入某种循环、某个代理层一直发 keep-alive 心跳却不再推进内容。你的这一轮就一直坐着,占着会话、占着 token 预算,什么也没交付。
新开关:给“一次尝试”加总时限
新合并的改动加了一个 opt-in 的配置项:agent.stream_max_lifetime,也可以用环境变量 HERMES_STREAM_MAX_LIFETIME。它计的不是间隔,而是从这次流式尝试开始到现在的总时长,永远不会因为收到 chunk 而重置。
agent:
  stream_max_lifetime: 600   # 单位:秒;0 = 关闭(默认)
或者临时用环境变量:
HERMES_STREAM_MAX_LIFETIME=600 hermes gateway默认值是 0,也就是关闭。这个默认是刻意的:长时间推理的模型合法地流几十分钟是正常的,不能被一刀切。
它的几个行为细节(都写在实现里,值得了解):
- 按“尝试”计时:每次重试都是新的一次尝试,从零开始计时,不会把上一次的时间累计进来;
- 有下限:这个上限会被抬到“当前生效的 stale 超时”之上,所以它永远不会比 stale 检测更早开火,不会误伤本来正常的流;
- 掐断方式与 stale 一致:取消这次尝试、中止请求本地的客户端、关掉 socket,并在跨轮次的 stale 熔断器里记一次;
- 后续照常接管:重试循环会重连,或者已经交付的部分走“部分交付续写”,不会白丢你已经读到的内容。
真的触发时,报错会点名这个配置,而不是含糊地说“上游超时”:
Response still streaming after 612s, cut by agent.stream_max_lifetime (600s).
Raise agent.stream_max_lifetime, or set it to 0 to turn the cap off,
if this model legitimately streams this long.
和其它几层超时怎么配合
Hermes 的流式超时是分层的,别把它们混成一个数字:
| 层 | 默认值 | 作用 | 配置 |
|---|---|---|---|
| socket 读超时 | 120 秒 | 收不到任何字节就认为连接坏了 | HERMES_STREAM_READ_TIMEOUT |
| stale 流检测 | 180 秒 | 两个 chunk 之间隔太久就掐断重连 | HERMES_STREAM_STALE_TIMEOUT |
| 流总时长上限 | 关闭(0) | 一次尝试的总墙钟时间上限 | agent.stream_max_lifetime 或 HERMES_STREAM_MAX_LIFETIME |
| 重连次数 | 3 次 | 流中断后重连几次 | HERMES_STREAM_RETRIES |
| stale 熔断 | 连续 5 次 | 连续被掐且没有一次完成,就直接报错,不再干等 | HERMES_STREAM_STALE_GIVEUP |
组合起来的直觉是:读超时管“完全没动静”,stale 管“安静太久”,总时长上限管“一直在动但永远不结束”,熔断器管“反复失败别硬撑”。
该设多少
- 本地跑长推理、跑大上下文预填充:保持
0。这类流慢但合法,硬设上限只会在正常生成时把你打断。 - 网关/机器人场景:中继质量不可控,建议设一个你觉得“再久也没意义”的值,比如 300–900 秒。超过这个时间还没结束,重连一次通常比继续等更有价值。
- 给自动化任务兜底:cron、无人值守的批处理,设一个明确上限,比事后从日志里猜“它为什么挂了三小时”要省事。
- 别设得比 stale 超时还小:设了也会被抬到 stale 超时之上,等于白设。想更激进就同时调低
HERMES_STREAM_STALE_TIMEOUT。
另外有个已知边界:Bedrock 的轮询式流(chat_completion_helpers.py 那条路径)没有接这个上限,因为那个文件不允许再长大。用 Bedrock 的话,这一层保护暂时不生效。
还有一个值得知道的兜底细节:如果同一个尝试被掐了三次仍然没有退出(worker 卡在不响应取消的地方),监控会放弃这个 worker,并回报“请求已放弃”,而不是每隔一个窗口再掐一次把整轮拖死。
状态与相关阅读
这个上限于 2026-11-01 合并(PR #80701),并已随 v0.22.6(2026-11-02 发布) 进入正式发行版——升级后就有;v0.22.5 及更早版本里没有。
顺带说一句:它解决的是“永远不结束”,不是“已经读到的内容被丢掉”——后者是交付层的问题,之前整理过一批 流式交付的坑。如果你的卡顿发生在本地模型服务器上(比如服务器本身僵住),先看 本地模型服务器失联;想了解整体超时配置的全貌,config 命令参考 和 网关的 loop watchdog 是接下来的两篇。