O stream continua pingando e nunca termina: um limite opcional de tempo total para uma resposta
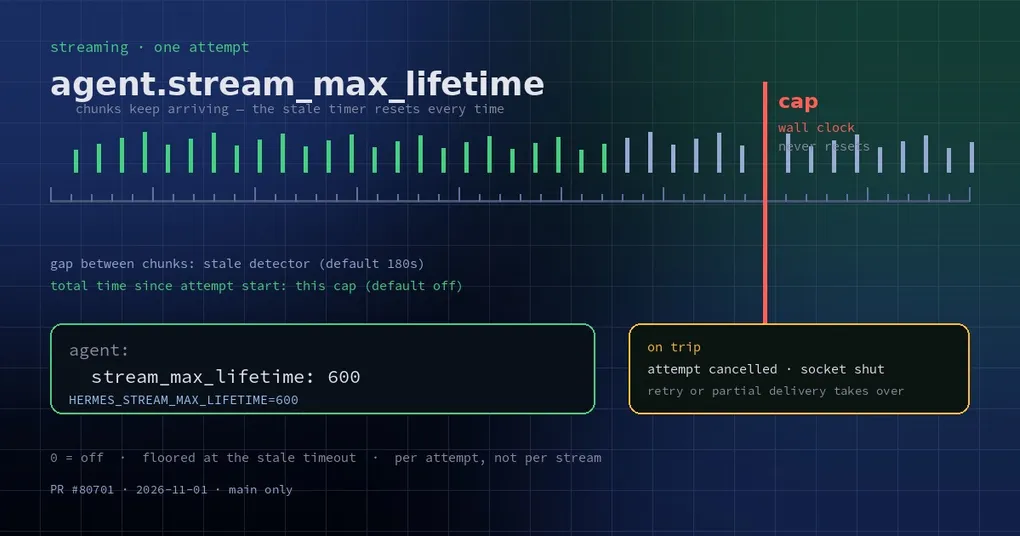
São 22h. Você envia uma requisição e o texto começa a aparecer. Uma palavra por vez, diligentemente, e nunca acaba. Vinte minutos depois o cursor ainda pisca e o spinner continua girando — você não ousa apertar Ctrl-C (perderia o que já foi gerado) e não tem como saber se o modelo está processando ou apenas girando em falso.
Esse travamento do tipo “sempre quase pronto” é pior do que uma falha limpa. Uma falha limpa pelo menos tem um watchdog: se nenhum dado chega por tempo suficiente, a conexão é declarada morta e a tentativa é repetida. Mas este stream pinga um pouquinho a cada poucos segundos, então o watchdog é alimentado toda vez e nunca dispara.
Duas formas de um stream travar, e só uma era coberta
O Hermes tem camadas de timeout para streaming. Duas importam aqui:
- Timeout de leitura do socket (padrão 120s): quanto tempo sem nenhum byte antes de a conexão ser considerada quebrada.
- Detecção de stream travado (padrão 180s): quanto tempo sem um novo chunk antes de o stream ser declarado travado e morto para reconectar.
O detalhe importante está na definição da segunda: ela mede o intervalo entre chunks e reinicia a cada chunk. Esse design é intencional — um modelo pensando com esforço pode legitimamente ficar quieto por dezenas de segundos, e matá-lo por silêncio seria errado. Mas isso deixa um ponto cego:
| Modo de falha | Como aparece | A lógica antiga pegava |
|---|---|---|
| Silêncio total | Nenhum chunk | Sim — a detecção de travamento mata após 180s |
| Pinga mas nunca termina | Um pouco de dados a cada poucos segundos, sem finalizar | Não — cada chunk reinicia o relógio |
O segundo modo acontece no mundo real: um gateway de relay picando a resposta em pedacinhos, um upstream que entra em algum loop no meio da geração, uma camada de proxy que segue enviando heartbeats de keep-alive sem avançar o conteúdo. Seu turno fica ali, segurando a sessão e o orçamento de tokens, sem entregar nada.
O novo botão: um teto por tentativa
A mudança recém-integrada adiciona uma configuração opcional: agent.stream_max_lifetime, ou a variável de ambiente HERMES_STREAM_MAX_LIFETIME. Ela mede o tempo de relógio desde o início da tentativa de streaming atual e nunca reinicia quando um chunk chega.
agent:
  stream_max_lifetime: 600   # segundos; 0 = desligado (padrão)
Ou por processo:
HERMES_STREAM_MAX_LIFETIME=600 hermes gatewayO padrão é 0, ou seja, desligado — e esse padrão é intencional: um modelo de raciocínio longo que legitimamente faz streaming por dezenas de minutos não pode ser cortado por um número único para todo mundo.
Os detalhes de comportamento valem a leitura, porque eles decidem se o limite dispara quando você quer:
- Cobrado por tentativa: cada retry é uma tentativa nova com orçamento completo; o tempo da tentativa anterior não é transportado.
- Elevado ao timeout de travamento: o teto é aumentado até o timeout efetivo de stream travado, então ele nunca dispara antes do detector que já estava esperando, e não corta um stream que está apenas quieto.
- Morto como um stream travado: a tentativa é cancelada, o cliente local da requisição é abortado, seu socket é encerrado e o disjuntor de travamento entre turnos conta a ocorrência uma vez.
- A recuperação continua acontecendo: o laço de retry reconecta, ou a entrega parcial continua a partir do que já foi gerado — o texto que você já leu não é descartado.
Quando ele dispara, o erro nomeia a configuração em vez de culpar o endpoint de forma vaga:
Response still streaming after 612s, cut by agent.stream_max_lifetime (600s).
Raise agent.stream_max_lifetime, or set it to 0 to turn the cap off,
if this model legitimately streams this long.
Como ele se encaixa nas outras camadas de timeout
Os timeouts de streaming no Hermes são em camadas. Não tente juntar tudo em um número só:
| Camada | Padrão | O que faz | Onde configurar |
|---|---|---|---|
| Timeout de leitura do socket | 120s | Nenhum byte significa conexão quebrada | HERMES_STREAM_READ_TIMEOUT |
| Detecção de stream travado | 180s | Intervalo longo demais entre chunks significa stream preso | HERMES_STREAM_STALE_TIMEOUT |
| Tempo máximo de stream | Desligado (0) | Teto de tempo real total por tentativa | agent.stream_max_lifetime / HERMES_STREAM_MAX_LIFETIME |
| Tentativas de reconexão | 3 | Quantas vezes reconectar no meio do stream | HERMES_STREAM_RETRIES |
| Disjuntor de travamento | 5 consecutivas | Depois de mortes repetidas sem resposta concluída, falhar rápido em vez de esperar de novo | HERMES_STREAM_STALE_GIVEUP |
O modelo mental: o timeout de leitura cobre “nada de nada”, a detecção de travamento cobre “quieto por tempo demais”, o tempo máximo cobre “sempre em movimento, nunca terminando”, e o disjuntor cobre “isso continua falhando, pare de esperar”.
Qual valor escolher
- Raciocínio local longo ou prefills enormes: deixe em
0. Esses streams são lentos mas legítimos, e um teto rígido vai cortar trabalho real. - Gateways e bots: a qualidade do relay está fora do seu controle, então defina um valor a partir do qual esperar mais não agrega nada — 300 a 900 segundos é uma faixa razoável. Passado isso, uma reconexão costuma valer mais do que mais paciência.
- Automação sem supervisão (cron, jobs em lote): defina um teto explícito em vez de reconstruir pelos logs por que um turno ficou pendurado por três horas.
- Não configure abaixo do timeout de travamento: ele é elevado até o timeout de travamento de qualquer forma, então um número menor não faz nada. Para ser mais agressivo, diminua também o
HERMES_STREAM_STALE_TIMEOUT.
Uma limitação conhecida: o stream de polling do Bedrock (o caminho de chat_completion_helpers.py) não é coberto — esse arquivo não pode crescer. No Bedrock, esta camada ainda não se aplica.
Há também uma rede de segurança que vale conhecer: se a mesma tentativa é morta três vezes e ainda não desenrola (um worker travado onde o cancelamento não alcança), o monitor abandona o worker e reporta a requisição como abandonada, em vez de matá-la de novo a cada janela e travar o turno inteiro para sempre.
Status e leitura relacionada
O limite entrou em 2026-11-01 (PR #80701) e já está no v0.22.6 (2026-11-02): basta atualizar; o v0.22.5 e anteriores não têm.
Uma ressalva: isso corrige “nunca termina”, não “texto já lido é descartado”. Essa segunda classe é um problema da camada de entrega, coberto em o panorama da entrega de streaming. Se o seu travamento acontece em um servidor de modelo local — o próprio servidor emperrado, e não o stream pingando — comece por um servidor de modelo local saindo do ar. Para o quadro mais amplo de timeouts, veja a referência do comando config e o watchdog do laço do gateway.