Hermes Honcho 记忆为什么总落在别的项目里
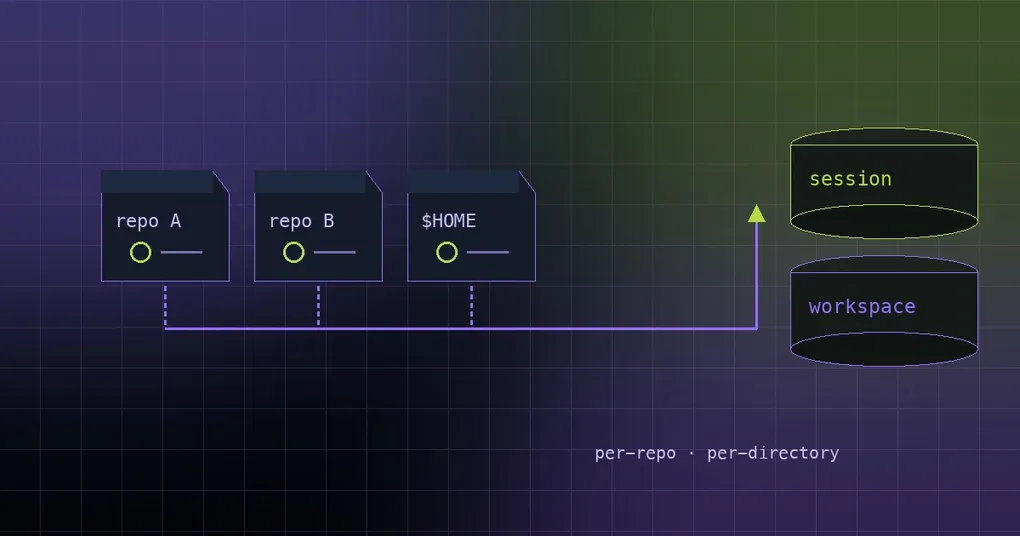
你有三个仓库:一个后端 monorepo、一个前端、还有一个放了两年多的运维脚本目录。上周你在 monorepo 里把退款流程重写了一遍,今天在运维脚本目录里打开 Hermes,随口问了一句「上次那个退款重构最后是怎么收尾的」——它答得头头是道,细节全是只存在于另一个项目里的东西。反过来也有更离谱的:刚从远端 clone 下来、还没写过一行代码的新仓库,第一次对话它就像认识你很多年。你按项目分开跑 Hermes,本来就是想让每个仓库有自己的记忆,结果 Honcho 一直在别的地方找答案。
这不是提示词写坏了,是记忆的落点错了。PR #112602(2026-09-16 合并)修掉了两条把会话路由带偏的路径,这篇把症状、原因、正确的配置方式,以及怎么确认你的记忆到底进了哪个会话讲清楚。
先把两个词说清楚
Honcho 是 Hermes 的 memory provider 之一:它跨会话长期维护「你是谁」的用户档案(user representation、peer card),而不是把一切都塞进单次对话的上下文里。
sessionStrategy 决定 Honcho 的 session(可以理解成「记忆桶」)跟你的工作怎么对应。默认值是 per-directory,一共四档:
| sessionStrategy | 含义 |
|---|---|
per-session |
每次 hermes 启动都是全新 session,记忆靠工具按需取用。文档推荐新用户从这里开始 |
per-directory |
每个工作目录一个 session,上下文跨多次运行累积(默认值) |
per-repo |
每个 git 仓库一个 session |
global |
所有目录共用一个 session |
顺带一句上下文注入:Honcho 在 hybrid / context 模式下每轮会往 system prompt 里拼两层上下文——基础层(会话摘要、用户档案、peer card、AI 自我表示)和 dialectic 补充层(针对当前状态的 LLM 推理)。contextCadence 默认 1、dialecticCadence 默认 2(文档建议 1–5),两层拼完后按 contextTokens 预算截断。记忆存取和上下文注入是两件事,混起来看会很难判断问题出在哪。
如果你不想把记忆交给托管服务,本地那套走 LanceDB 的路线可以看 Hermes 的语义记忆是怎么落地的,两者解决的是同一个问题。
症状:三个仓库,一份记忆
典型的表现有三种,而且都发生在同一个策略配置下:
- 你在 A 仓库里问 B 仓库的事,Honcho 把 B 的细节捞了出来。
- 新仓库第一次对话就带着旧项目的偏好和结论。
- 策略明明写的是
per-repo,但 agent 的行为像是global。
三条表现指向同一个事实:所有项目都落在了同一个 session 上。而那个 session 的名字不是任何一个仓库名。
原因一:自动生成的标题会顶掉你的策略
Hermes 会替你给会话自动起标题——来源是 derived 或 llm(Desktop 分支的 lineage 标题也属于这一类)。这些标题本意只是给你在会话列表里认人的显示信息。
旧逻辑里不是这样:只要一个会话有标题,标题就会参与 session 名的推导。于是一次「Refactor the billing module」的自动标题,把会话从仓库对应的 session 上拽走,改名成了 Refactor-the-billing-module。你配的 sessionStrategy 还在,只是没人听它的了。
原因二:解析用的是启动目录,不是工作区
第二条更隐蔽。旧代码里,session key 的解析走 os.getcwd()——那是后端进程的启动目录。在 Desktop 或 messaging gateway 下,这个进程往往从 $HOME 启动,于是不管你当时在哪个仓库里对话,Honcho 看到的工作目录永远是家目录,所有项目一起塌进一个叫 home 的桶。
这就是为什么很多人「明明在项目里」,记忆却是全局的。
PR #112602 改了什么
修复落在解析链路上,两条问题各改一处:
plugins/memory/honcho/client.py::_resolve_session_name_base— 标题来源是derived或llm时直接跳过标题分支,它只是显示信息;显式敲的/title(来源user)仍然覆盖策略;标题没有记录来源时保持旧行为。plugins/memory/honcho/__init__.py::_resolve_session_key— 改成对kwargs["cwd"]或resolve_agent_cwd()解析(pinned session cwd →TERMINAL_CWD→ 启动目录),也就是 system prompt 和 context file 发现一直在用的那套合同,不再用os.getcwd()。hermes_state_common.py—TITLE_SOURCE_*常量放在 cycle-safe 的兄弟模块里,SessionDB和插件读同一套词表,不会各自理解一套。agent/agent_init.py—AIAgent(cwd=...)落到agent.session_cwd;_memory_provider_init_kwargs把session_title_source和cwd一起传给 provider。tui_gateway/*— eager-resume、branch、compute-host 和延迟构建(deferred build)路径会传cwd_override:这些路径的会话记录还没进_sessions,不传就会被_set_session_context清掉 cwd。延迟构建期间发生的工作区搬动也能传到构建完成的 agent 上。
优先级这件事值得记一下:messaging gateway 的会话无论策略和标题是什么,始终用稳定的 per-chat key;其他会话按 per-session 身份 → 手动目录映射 → 显式标题 → 配置的策略 的顺序取第一个命中。
合并时用的是真实环境端到端验证(真实 SessionDB、真实 HonchoMemoryProvider,进程 cwd 设成伪造的 $HOME,会话 cwd 绑到一个叫 myapp 的 git 仓库,策略 per-repo):
| 场景 | 修复前 | 修复后 |
|---|---|---|
| 没有标题 | home |
myapp |
| LLM 标题 “Refactor the billing module” | Refactor-the-billing-module |
myapp |
显式 /title My Explicit Name |
My-Explicit-Name |
My-Explicit-Name |
第三行是本次修复刻意保留的行为:用户自己起的标题永远是有意为之的覆盖。
把 sessionStrategy 配对
装上 provider 最省事的方式还是向导,它会问你 gateway 那条分支的问题,并把 key 写进配置:
hermes memory setup # 在 provider 列表里选 "honcho"手动配置的话,config.yaml 里至少要有这一段:
# ~/.hermes/config.yaml
memory:
  provider: honcho
echo 'HONCHO_API_KEY=***' >> ~/.hermes/.envAPI key 在 honcho.dev 申请。sessionStrategy 这类设置写在 honcho provider 的设置区里——也就是 hermes memory setup 写出来的那一段;不想手写、怕拼错的,在向导的提示处按 [e] 直接进编辑器设 key。
怎么选那一档:
per-repo:一个 monorepo 加几个独立仓库,每个仓库要自己的记忆。上面那个场景就该用这个。per-directory:一个目录里长期干活,子目录之间不需要隔离。这是默认值,也是大多数人的合适选择。per-session:每次都要干净起步,记忆靠工具主动取。想做实验或者排查串味问题时,这一档最好用,因为它把「会话级记忆」和「用户级档案」分得最清楚。global:你真的想所有项目共用一份档案时才用。
其余几个设置项(多跟 gateway 相关,一起列出来方便对照):
| 设置 | 默认值 | 作用 |
|---|---|---|
sessionStrategy |
per-directory |
上面那四档;目录类策略和手动的 sessions 映射都用逻辑会话工作目录,而不是后端的启动目录 |
a2aSessions |
true |
其他 bot 发来的 DM 写进它自己按发送方区分的 session,绝不写进人类的;false 则完全跳过 bot 发起的回合 |
pinUserPeer |
false |
仅 gateway。true 时每个平台用户都塌成 peerName |
userPeerAliases |
{} |
仅 gateway。运行时 ID 到 peer 的映射({"7654321": "alice"}),多对一 |
runtimePeerPrefix |
"" |
仅 gateway。没有 alias 命中时给未知运行时 ID 加命名空间,例如 telegram_7654321 |
gateway 侧的 peer 解析顺序是自上而下、第一个命中生效:pinUserPeer → userPeerAliases[id] → runtimePeerPrefix + id → 原始运行时 ID → peerName → session-key 兜底。如果你在 Telegram 或 Discord 里发现别人的记忆粘到自己身上,看的就是这张表。顺带提醒一句文档里的警告:把 pinUserPeer 从 true 翻成 false 不会迁移数据,peerName 下面的历史留在原地。相关的命令细节可以对照 hermes memory 命令参考。
怎么确认记忆落在了哪个会话里
修复之后,session 名是可推导的,所以你可以反推:
- 看名字的形状。 目录/仓库类策略下,session 名就是那个目录或仓库的名字(验证里是
myapp);没有工作区信息时是启动目录名(home);显式标题则会被转成短横线形式(My-Explicit-Name)。如果你看到的是一个标题形状的名字,比如Refactor-the-billing-module,那就是标题接管了会话。 - 做交叉测试。 在仓库 A 里让 agent 落一条只属于 A 的结论(
honcho_conclude写的结论,或者honcho_profile里的用户卡片),再切到仓库 B 问同一件事。per-repo下 B 不应该答得出来;答得出来,说明两边进的是同一个 session。 - 确认工作目录本身。 让 agent 报出它这一次运行的工作目录,跟你想的那个仓库比一下。解析链是会话上下文 → scoped 的
terminal.cwd→ 启动目录,只要链条中间某一环给的是$HOME,落点就会跑到home桶里。 - 用
per-session做对照实验。 临时切到这一档,每个新会话都应该是空的。如果还有内容冒出来,那它来自用户级档案(user representation / peer card),不是会话级记忆——这是设计如此,不是串味。
修复前建的会话怎么办
文档把这条写得很直白:在记录标题来源之前建的会话保留旧行为。因为一条旧的自动标题和一条旧的用户标题在数据上分不出来,所以没有记录来源的标题会被当成显式覆盖。换句话说,那些老会话不会因为你升级就自动回到仓库对应的 session 上。
另外这次修复不包含一件事:把已经写进错误 session 的消息迁移回来。已经落错地方的历史留在原处。实际做法是——需要干净记忆的仓库,在正确的目录下开新会话,它会落到正确的 session 名上;显式 /title 仍然继续生效,因为那是有意为之的覆盖,本次修复不动它。
如果你习惯把结论沉淀成笔记,让 agent 在正确的项目目录里写 Obsidian 笔记 也是一种绕开串味的方式:文件系统本身就是按项目分层的。同一条记忆链路在定时任务里的表现,可以看 cron 与记忆延续。
小结
- Honcho 的记忆有明确的落点,而这个落点由
sessionStrategy加会话工作目录共同决定。 - 两个 bug 分别破坏了一半:自动标题(
derived/llm)不该覆盖策略,现在不会了;解析该用会话的工作区而不是进程的启动目录,现在也是了。显式/title依然是你手里的覆盖开关。 - 多仓库场景用
per-repo,单目录长期劳动用per-directory,要干净起步或排查串味用per-session。 - 排查时先看 session 名的形状,再做一次跨仓库的交叉提问。
- 老会话和已经落错的历史不会自动搬家,新会话从正确的目录开始建就行。