Por qué la memoria Honcho de Hermes acaba en otro proyecto
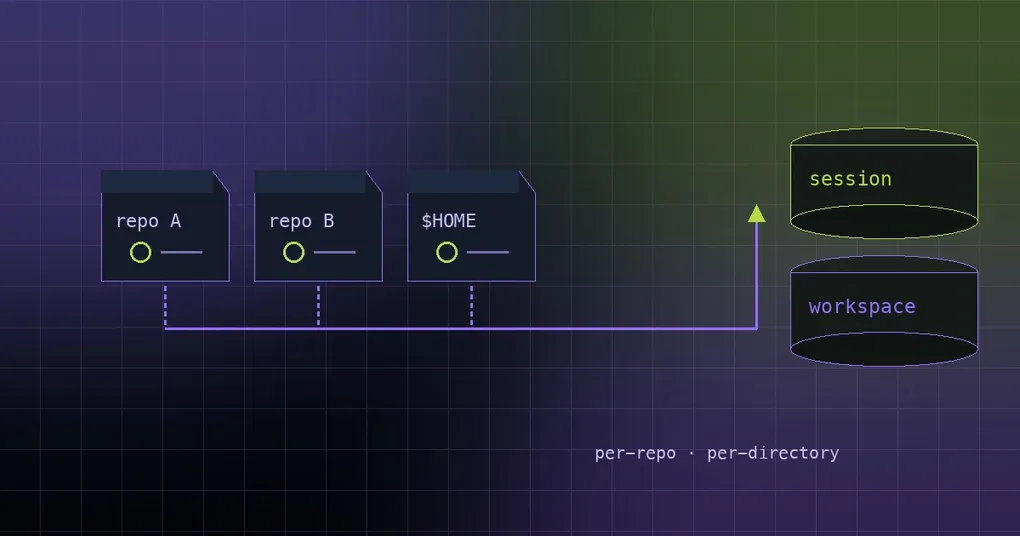
Tienes tres repositorios: un monorepo de backend, un frontend y una carpeta de scripts de operaciones que no tocas desde hace dos años. La semana pasada reescribiste el flujo de reembolsos en el monorepo. Hoy abres Hermes dentro de la carpeta de scripts, preguntas cómo quedó ese refactor y te responde con todo lujo de detalles sobre un proyecto que nunca has mencionado en ese directorio. El caso inverso da más grima: clonas un repositorio, no has escrito ni una línea y la primera conversación ya “recuerda” todo tu directorio personal. Ejecutas Hermes por proyecto justamente para que cada repositorio tenga su propia memoria. Honcho la estaba archivando en otro sitio.
Los prompts estaban bien. Lo que fallaba era el destino. El PR #112602 (fusionado el 2026-09-16) corrige las dos rutas de código que enrutaban las sesiones al lugar equivocado. Aquí tienes qué se rompió, cómo configurar sessionStrategy para que de verdad se aplique y cómo saber en qué sesión aterrizó tu memoria.
Dos términos, una frase cada uno
Honcho es uno de los memory providers de Hermes: modela al usuario como un perfil que persiste entre sesiones —user representation, peer card— en lugar de tratar cada conversación como una isla.
sessionStrategy decide cómo se mapean las sesiones de Honcho (piensa en “cubos de memoria”) sobre tu trabajo. El valor por defecto es per-directory y hay cuatro opciones:
| sessionStrategy | Qué hace |
|---|---|
per-session |
Cada ejecución de hermes estrena sesión; la memoria vuelve a través de herramientas. La documentación lo recomienda para quien empieza |
per-directory |
Una sesión por directorio de trabajo; el contexto se acumula entre ejecuciones (por defecto) |
per-repo |
Una sesión por repositorio git |
global |
Una única sesión para todos los directorios |
Un detalle que conviene separar de todo lo anterior: en modo hybrid / context Honcho inyecta dos capas de contexto en el system prompt en cada turno: una capa base (resumen de sesión, representación del usuario, peer card, autorrepresentación de la IA) y un suplemento dialéctico generado por un LLM. contextCadence vale 1 por defecto y dialecticCadence 2 (la documentación sugiere 1–5); el resultado concatenado se recorta al presupuesto de contextTokens. La memoria de sesión y el perfil de usuario son dos cosas distintas, y mezclarlas hace que estos bugs sean mucho más difíciles de diagnosticar.
Si prefieres que la memoria viva en tu propio disco, la ruta con LanceDB está en cómo implementa Hermes la memoria semántica: el mismo problema con otro almacenamiento.
El síntoma: tres repositorios, una sola memoria
Tres variantes de la misma queja, todas con la misma configuración de fondo:
- Preguntas por el repositorio B desde el A y Honcho te saca los detalles de B.
- Un repositorio recién clonado llega con preferencias y conclusiones de proyectos antiguos.
- Tu configuración dice
per-repo, pero el agente se comporta comoglobal.
Las tres significan lo mismo: todos los proyectos caen en la misma sesión, y esa sesión no lleva el nombre de ninguno de tus repositorios.
Causa uno: un título automático renombra la sesión sin avisar
Hermes escribe títulos por ti. Su procedencia es derived o llm (lo mismo ocurre con los títulos de lineage de las ramas de Desktop). Existen para que reconozcas las conversaciones en una lista: son metadatos de visualización.
El código antiguo no lo entendía así. Si una sesión tenía título, ese título participaba en la derivación del nombre de sesión. Un título automático como “Refactor the billing module” sacaba la conversación de la sesión del repositorio y la renombraba a Refactor-the-billing-module. Tu sessionStrategy seguía configurado; simplemente nadie lo consultaba.
Causa dos: la resolución usaba el directorio de arranque, no el workspace
Esta es más silenciosa. La resolución de la session key se hacía contra os.getcwd(), el directorio de arranque del proceso backend. Bajo Desktop o un messaging gateway ese proceso suele arrancar en $HOME, así que diera igual desde qué repositorio escribieras, el workspace que veía Honcho era tu directorio personal. Todos los proyectos colapsaban en un único cubo llamado home.
De ahí que tantas configuraciones parecieran global mientras el archivo de configuración decía otra cosa.
Qué cambió el PR #112602
El arreglo es deliberadamente estrecho: un cambio por bug, ambos en la ruta de resolución.
plugins/memory/honcho/client.py::_resolve_session_name_base— un título con procedenciaderivedollmes metadato de visualización y salta por completo la rama del título. Un/titleexplícito (procedenciauser) sí sigue sobrescribiendo. Un título sin fuente registrada mantiene el comportamiento antiguo.plugins/memory/honcho/__init__.py::_resolve_session_key— resuelve contrakwargs["cwd"]oresolve_agent_cwd()(pinned session cwd →TERMINAL_CWD→ directorio de arranque): el mismo contrato que ya usaban el system prompt y el descubrimiento de archivos de contexto, en lugar deos.getcwd().hermes_state_common.py— las constantesTITLE_SOURCE_*viven en el módulo hermano cycle-safe, así queSessionDBy el plugin leen el mismo vocabulario.agent/agent_init.py—AIAgent(cwd=...)grabaagent.session_cwd, y_memory_provider_init_kwargspasasession_title_sourceycwdal provider.tui_gateway/*— las rutas de eager-resume, branch, compute-host y deferred build pasancwd_override(su registro de sesión aún no está en_sessions, y_set_session_contextborraría el cwd). Un workspace que se mueve durante un deferred build también llega al agente ya construido.
Vale la pena memorizar la precedencia. Los messaging gateways mantienen su session key estable por chat, sea cual sea la estrategia o el título. Para el resto de sesiones: identidad per-session → mapeo manual de directorio → título explícito → la estrategia configurada, y gana la primera coincidencia.
La fusión se validó de extremo a extremo con imports reales (un SessionDB real, un HonchoMemoryProvider real, el cwd del proceso apuntando a un $HOME falso, el cwd de sesión ligado a un repositorio git llamado myapp y estrategia per-repo):
| Caso | Antes | Después |
|---|---|---|
| sin título | home |
myapp |
| título LLM “Refactor the billing module” | Refactor-the-billing-module |
myapp |
/title My Explicit Name explícito |
My-Explicit-Name |
My-Explicit-Name |
La tercera fila es intencionada: un título escrito por ti sigue siendo una sobrescritura.
Configurar bien sessionStrategy
El asistente sigue siendo la vía con menos errores: pregunta por tu gateway y escribe las claves por ti.
hermes memory setup # elige "honcho" en la lista de providersConfigurado a mano, config.yaml necesita al menos esto:
# ~/.hermes/config.yaml
memory:
  provider: honcho
echo 'HONCHO_API_KEY=***' >> ~/.hermes/.envLa API key se obtiene en honcho.dev. Ajustes como sessionStrategy viven en el bloque de configuración del provider Honcho, el mismo que escribe hermes memory setup. Si prefieres no editar el archivo, pulsa [e] en el prompt del asistente y define las claves en su editor.
Cómo elegir tu estrategia:
per-repo— un monorepo más varios repositorios independientes, cada uno con su memoria. Es el escenario de arriba.per-directory— trabajas en un directorio a largo plazo y no necesitas aislamiento entre subcarpetas. Es el valor por defecto por algo.per-session— cada ejecución empieza limpia y la memoria se recupera con herramientas. También es el mejor ajuste para depurar, porque separa con más nitidez la memoria de sesión del perfil de usuario.global— solo si de verdad quieres un perfil compartido entre todos los proyectos.
El resto de ajustes (casi todos de gateway, juntos para referencia):
| Ajuste | Por defecto | Qué hace |
|---|---|---|
sessionStrategy |
per-directory |
Los cuatro niveles de arriba; las estrategias por directorio y los mapeos manuales de sessions usan el directorio de trabajo lógico de la sesión, no el de arranque del backend |
a2aSessions |
true |
Los DM de otros bots se escriben en su propia sesión por bot emisor, nunca en la del humano; false omite del todo los turnos escritos por bots |
pinUserPeer |
false |
Solo gateway. Con true, todos los usuarios de la plataforma colapsan en peerName |
userPeerAliases |
{} |
Solo gateway. Mapa de IDs de runtime a peers ({"7654321": "alice"}), de varios a uno |
runtimePeerPrefix |
"" |
Solo gateway. Da espacio de nombres a los IDs de runtime desconocidos (telegram_7654321) cuando no coincide ningún alias |
La resolución de peers en el gateway prueba de arriba abajo y gana la primera: pinUserPeer → userPeerAliases[id] → runtimePeerPrefix + id → ID de runtime en bruto → peerName → fallback de session key. Si los datos de otra persona se te pegan en Telegram o Discord, esa es la tabla que hay que leer. Un aviso de la documentación: pasar pinUserPeer de true a false no migra datos; el historial bajo peerName se queda donde está. Los detalles a nivel de comando están en la referencia de hermes memory.
Cómo saber en qué sesión aterrizó la memoria
Después del arreglo el nombre de sesión es derivable, así que puedes razonar a la inversa:
- Mira la forma del nombre. Con estrategias por directorio o repositorio es el nombre del directorio o del repositorio (en la validación,
myapp); sin información de workspace es el directorio de arranque (home); un título explícito se convierte en una forma con guiones (My-Explicit-Name). Un nombre de sesión con forma de título es la firma del bug antiguo: si vesRefactor-the-billing-module, el título se apoderó de la sesión. - Haz una prueba cruzada. En el repositorio A, pide al agente que registre una conclusión que solo pertenece a A (una conclusión escrita por
honcho_conclude, o la user card que hay detrás dehoncho_profile). Luego cambia al repositorio B y pregunta por ella. Conper-repo, B debería quedarse en blanco. Si responde, los dos repositorios hablan con la misma sesión. - Confirma el propio directorio de trabajo. Pide al agente que informe el directorio de trabajo de la ejecución actual y compáralo con el repositorio en el que crees estar. La cadena es contexto de sesión →
terminal.cwdcon scope → directorio de arranque; si algún eslabón devuelve$HOME, tu memoria se va al cubohome. - Usa
per-sessioncomo control. Cámbialo temporalmente: cada sesión nueva debería arrancar vacía. Si aparecen datos, vienen del perfil de usuario (user representation / peer card), no de la memoria de sesión; eso es por diseño, no contaminación cruzada.
Sesiones creadas antes del arreglo
La documentación es tajante: las sesiones creadas antes de que se registrara la procedencia del título conservan el comportamiento antiguo. Un título automático viejo no se distingue de un título de usuario viejo, así que un título sin fuente se trata como sobrescritura explícita. Actualizar no devuelve esas sesiones a la sesión del repositorio.
Hay un segundo límite: este cambio no migra los mensajes ya escritos en sesiones mal enrutadas. El historial que cayó en el cubo equivocado se queda ahí. Lo práctico es abrir una sesión nueva en el directorio correcto —resolverá al nombre de sesión correcto— y seguir usando /title explícito cuando quieras una sobrescritura deliberada, porque ese comportamiento no se ha tocado.
Si te gusta convertir las conclusiones en notas duraderas, que el agente escriba en tu bóveda de Obsidian mientras estás en el directorio del proyecto correcto sortea todo el problema: el sistema de archivos ya está particionado por proyecto. Y si programas trabajo, la misma cadena de memoria aparece en cron y continuidad de memoria.
Conclusiones
- La memoria de Honcho tiene un destino concreto, y ese destino lo deciden
sessionStrategyy el directorio de trabajo de la sesión. - Dos bugs rompieron una mitad cada uno: los títulos automáticos (
derived/llm) ya no anulan la estrategia, y la resolución sigue el workspace de la conversación en lugar del directorio de arranque del proceso. Un/titleexplícito sigue siendo tu sobrescritura manual. - Usa
per-repocon varios repositorios,per-directorypara trabajo prolongado en un solo directorio yper-sessionpara arranques limpios o cuando persigues un bug de enrutado. - Para diagnosticar, mira primero la forma del nombre de sesión y después lanza una pregunta cruzada entre repositorios.
- Las sesiones heredadas y el historial ya mal enrutado no se mueven solos: abre sesiones nuevas desde el directorio correcto.