O seu gateway fica mudo ao fim de algumas centenas de turnos — havia dois wrappers a empilhar-se no stdout
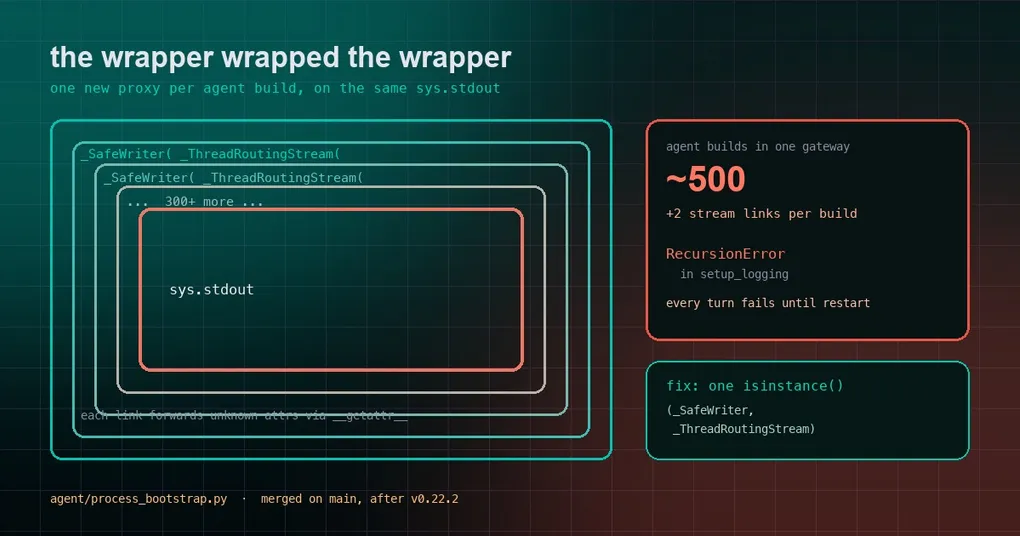
O seu bot responde o dia inteiro num chat movimentado. Depois, algures a seguir à mensagem 500, para. O processo está vivo, a porta está à escuta, hermes gateway status diz que está tudo bem — mas todas as mensagens novas falham. Abre o log e encontra uma linha que não tem nada a ver com conversa: RecursionError: maximum recursion depth exceeded, com o traceback a terminar em setup_logging. Reinicia o gateway e volta a funcionar. Amanhã à mesma hora, a mesma falha.
Isto não é uma fuga de memória, não é um modelo instável e não é nada que tenha configurado mal. É o stream de output do Python: duas camadas de proxy a empilhar-se uma em cima da outra, até que ao fim de algumas centenas de ciclos a cadeia fica profunda o suficiente para rebentar com o limite de recursão do interpretador.
O sintoma: não é lentidão — é falha
Vale a pena fixar isto antes de ir à procura, porque os sintomas apontam para o subsistema errado:
| O que vê | O que está realmente a acontecer |
|---|---|
Processo do gateway vivo, status diz running |
O processo está bem; o que rebenta é cada build de agent |
RecursionError em setup_logging, vezes sem conta |
Uma leitura de atributo percorre uma cadeia de proxies muito longa |
| Reiniciar resolve de imediato | A cadeia foi reposta — e começa a crescer outra vez |
| Mais uptime, pior | Escala com turnos e builds de agent, não com o tempo nem com a carga |
A palavra-chave é longa duração. Se reiniciar o gateway todos os dias, ou só usar o Hermes a partir de um terminal de vez em quando, provavelmente nunca vai ver isto. Se o correr como serviço com Telegram, Discord, Slack, cron jobs e revisão em background ligados, é um rastilho lento.
O que está nesse stream
Dois desenhos, cada um razoável por si.
O primeiro é _install_safe_stdio(). Cada vez que um agent é construído, envolve o sys.stdout e o sys.stderr num _SafeWriter, para que um pipe partido ou um erro de encoding ao imprimir progresso não derrube o agent inteiro. Como corre em cada build, tem de reconhecer “já está envolvido” — e a verificação antiga era estreita: se o stream já for um _SafeWriter, salta.
O segundo é o proxy de encaminhamento por thread _ThreadRoutingStream, instalado pela revisão em background quando precisa de silenciar o output durante um bocado. Quando thread_scoped_silence() termina, volta a instalar um router.
As duas verificações não concordam:
- O
_install_safe_stdio()só conhecia o_SafeWriter. Ao ver um_ThreadRoutingStreampor cima, decidiu “não é meu” e acrescentou outro_SafeWriter. - O
thread_scoped_silence()deixou então de ver um router, e instalou um novo por cima desse wrapper.
Ou seja, cada ciclo de “construir um agent, silenciar um scope” acrescentava duas ligações a cada stream:
_ThreadRoutingStream( _SafeWriter( _ThreadRoutingStream( _SafeWriter( ... ) ) ) )Cada ligação encaminha atributos desconhecidos para a seguinte através de __getattr__. Um salto não é nada. Mas com centenas de ligações, uma única leitura de atributo tem de atravessar a cadeia toda — e ao fim de cerca de 500 ciclos, a leitura de line_buffering dentro de setup_logging atinge o limite de recursão e lança RecursionError. A partir daí, todos os turnos falham até o gateway reiniciar e a cadeia cair.
Um detalhe que faz isto parecer mais pequeno do que é: o gatilho não é “muitas mensagens”. São builds de agent. Um turno que lança subagents, corre revisão em background e passa por várias iterações de tool constrói muito mais agents do que se adivinharia pela contagem de mensagens.
A correção: uma verificação isinstance
A alteração mesclada é minúscula e vive em agent/process_bootstrap.py:
def _install_safe_stdio() -> None:
    """Wrap stdout/stderr so best-effort console output cannot crash the agent."""
    for stream_name in ("stdout", "stderr"):
        stream = getattr(sys, stream_name, None)
        # The routing proxy already absorbs these errors; wrapping it stacks a new proxy per build.
        if stream is not None and not isinstance(stream, (_SafeWriter, _ThreadRoutingStream)):
            setattr(sys, stream_name, _SafeWriter(stream))
A guarda passa a reconhecer a família inteira em vez de um único membro. O router já absorve os dois erros para os quais o _SafeWriter existe (OSError e ValueError, tratados no seu próprio caminho de encaminhamento e no isatty()), por isso não precisa de uma segunda casca protetora à volta.
Não há passagem de limpeza nem protocolo de coordenação entre os dois instaladores: verifica o tipo uma vez e a cadeia fica plana para sempre. Aplica-se a todas as superfícies do gateway — Telegram, Discord, Slack, Desktop, o servidor de API — porque todas passam pelo mesmo bootstrap de agent.
O que fazer agora
1. Confirme que é este bug. Não adivinhe, conte:
hermes logs errors --since 7d | grep -c RecursionError
hermes logs errors --since 2d --level ERROR
Uma contagem que cresce ao longo dos dias, volta a zero no restart e sobe outra vez é a assinatura. Depois veja quantos gateways está a correr:
hermes gateway status
hermes gateway list
2. Ponha o serviço de volta. Reiniciar interrompe turnos em curso, mas é a única recuperação imediata:
hermes gateway restart
# vários profiles lado a lado
hermes gateway restart --all
3. Saiba quando chega a correção. A alteração foi mesclada na main a 19 de outubro de 2026 — depois de a v0.22.2 ter saído a 15 de outubro — por isso a release atual não a inclui. O seu próximo hermes update para um build que inclua o commit traz a correção; reinicie o gateway a seguir. Se correr a partir de um checkout de código que segue a main, faça pull e reinicie.
4. Trate um gateway como um serviço de longa duração. Este bug é cumulativo, não vem da carga: aparece em processos que correm durante semanas e constroem dezenas de milhares de agents. Dê ao serviço uma política de supervisão que o reinicie em caso de falha (systemd Restart=on-failure, launchd KeepAlive), para que uma classe de bug destas não o deixe em silêncio durante a noite. O Hermes tem a sua própria maquinaria de watchdog e heartbeat que vale a pena juntar a isso — veja o guia do watchdog do loop do gateway e a deteção de desconexões silenciosas por heartbeat.
Porque vale a pena guardar este caso
Duas lições, nenhuma específica do Hermes.
Wrappers num hot path têm de ser idempotentes para a família toda, não para um membro. Qualquer lógica do tipo “envolve se não estiver envolvido” com uma verificação de tipo estreita transforma-se, em silêncio, em “envolve em cada chamada”. Os testes unitários não apanham isto, porque um teste constrói um agent; só um processo de longa duração o expõe, e processos de longa duração são a coisa mais difícil de reproduzir.
As mensagens de erro mentem sobre a sua camada. RecursionError lê-se como recursão descontrolada na lógica de negócio, mas vinha de uma cadeia de encaminhamento de atributos na camada de I/O. Quando o topo do traceback não tem nada a ver com o que o código está a fazer, suspeite de estado de infraestrutura acumulado antes de começar a ler a lógica de negócio.
Se estiver a depurar o comportamento do gateway, confirme os seus comandos na referência do hermes gateway primeiro, e use o cron doctor do lado dos agendamentos — os cron jobs são normalmente a primeira coisa a queixar-se quando um gateway fica doente.
Resumo
- Sintoma: um gateway de longa duração falha em todos os turnos ao fim de algumas centenas de builds,
RecursionErrorvindo desetup_logging, o restart limpa tudo. - Causa:
_install_safe_stdio()ethread_scoped_silence()não reconheciam o proxy um do outro, por isso cada ciclo acrescentava duas ligações a cada stream; cerca de 500 ciclos depois, uma leitura de atributo passa o limite de recursão. - Correção: uma verificação
isinstanceque cobre a família toda de proxies. Mesclada namain, depois da v0.22.2. - Hoje: confirme com
hermes logs errors, recupere comhermes gateway restart, espere pela próxima atualização — e supervise o serviço.