Tu gateway se queda mudo a los pocos cientos de turnos: dos wrappers se apilaban sobre stdout
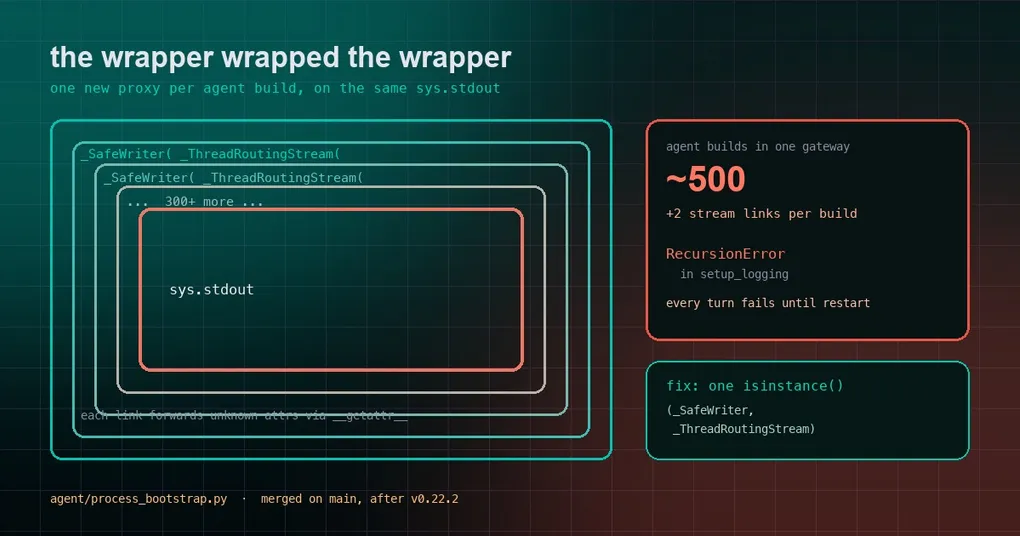
Tu bot responde todo el día en un chat con movimiento. Y entonces, en algún punto después del mensaje 500, deja de hacerlo. El proceso sigue vivo, el puerto sigue escuchando, hermes gateway status dice que todo está en orden, pero cada mensaje nuevo falla. Abres el log y encuentras una línea que no tiene nada que ver con la conversación: RecursionError: maximum recursion depth exceeded, con un traceback que termina en setup_logging. Reinicias el gateway y vuelve a funcionar. Mañana a la misma hora, el mismo fallo.
No es una fuga de memoria, ni un modelo inestable, ni algo que hayas configurado mal. Es el stream de salida de Python: dos capas de proxies apiladas una encima de otra hasta que, tras unos cientos de ciclos, la cadena es lo bastante profunda como para reventar el límite de recursión del intérprete.
El síntoma: no va lento, falla
Merece la pena fijarlo antes de ponerte a buscar, porque los síntomas apuntan al subsistema equivocado:
| Lo que ves | Lo que está pasando en realidad |
|---|---|
El proceso del gateway vivo, status dice running |
El proceso está bien; lo que revienta es cada agent build |
RecursionError en setup_logging, una y otra vez |
Una búsqueda de atributo recorre una cadena de proxies larguísima |
| Reiniciar lo arregla al instante | La cadena se reinició, y empieza a crecer otra vez |
| Cuanto más uptime, peor | Escala con los turnos y los agent builds, no con el tiempo ni la carga |
La palabra clave es larga duración. Si reinicias el gateway cada día, o solo usas Hermes desde una terminal de vez en cuando, probablemente nunca veas esto. Si lo tienes como servicio con Telegram, Discord, Slack, cron jobs y la revisión en segundo plano activadas, es una mecha lenta.
Qué hay en ese stream
Dos diseños, cada uno razonable por separado.
El primero es _install_safe_stdio(). Cada vez que se construye un agent, envuelve sys.stdout y sys.stderr en un _SafeWriter para que un pipe roto o un error de codificación al imprimir el progreso no se lleve por delante el agent entero. Como corre en cada build, tiene que reconocer lo de “ya envuelto”, y la comprobación antigua era estrecha: si el stream ya es un _SafeWriter, sáltalo.
El segundo es el proxy de enrutado por hilo _ThreadRoutingStream, que la revisión en segundo plano instala cuando necesita silenciar la salida durante un rato. Cuando thread_scoped_silence() termina, vuelve a instalar un router.
Las dos comprobaciones no coinciden:
_install_safe_stdio()solo conocía_SafeWriter. Al ver_ThreadRoutingStreamencima, decidió que “no era suyo” y añadió otro_SafeWriter.thread_scoped_silence()ya no veía un router, así que instaló uno nuevo por encima de ese wrapper.
Así que cada ciclo de “construir un agent, silenciar un ámbito” añadía dos eslabones a cada stream:
_ThreadRoutingStream( _SafeWriter( _ThreadRoutingStream( _SafeWriter( ... ) ) ) )Cada eslabón reenvía los atributos desconocidos al siguiente mediante __getattr__. Un salto no es nada. Pero con cientos de eslabones, una sola consulta de atributo tiene que recorrer la cadena entera, y tras unos 500 ciclos la consulta de line_buffering dentro de setup_logging alcanza el límite de recursión y lanza RecursionError. A partir de ahí fallan todos los turnos hasta que reinicias el gateway y la cadena desaparece.
Un detalle que hace fácil subestimar esto: el disparador no es “muchos mensajes”, sino los agent builds. Un turno que lanza subagents, ejecuta la revisión en segundo plano y pasa por varias iteraciones de tools construye muchos más agents de los que sugiere el número de mensajes.
El arreglo: una comprobación isinstance
El cambio fusionado es diminuto y vive en agent/process_bootstrap.py:
def _install_safe_stdio() -> None:
    """Wrap stdout/stderr so best-effort console output cannot crash the agent."""
    for stream_name in ("stdout", "stderr"):
        stream = getattr(sys, stream_name, None)
        # The routing proxy already absorbs these errors; wrapping it stacks a new proxy per build.
        if stream is not None and not isinstance(stream, (_SafeWriter, _ThreadRoutingStream)):
            setattr(sys, stream_name, _SafeWriter(stream))
La guarda ahora reconoce a toda la familia en lugar de a un solo miembro. El router ya absorbe los dos errores para los que existe _SafeWriter (OSError y ValueError, gestionados en su propia ruta de reenvío y en isatty()), así que no necesita una segunda coraza protectora alrededor.
Ni pasada de limpieza ni protocolo de coordinación entre los dos instaladores: se comprueba el tipo una vez y la cadena se queda plana para siempre. Aplica a todas las superficies del gateway —Telegram, Discord, Slack, Desktop, el servidor de la API— porque todas pasan por el mismo bootstrap del agent.
Qué hacer ahora
1. Confirma que es este bug. No lo adivines, cuéntalo:
hermes logs errors --since 7d | grep -c RecursionError
hermes logs errors --since 2d --level ERROR
Un recuento que crece con los días, vuelve a cero al reiniciar y sube otra vez es la firma. Después mira cuántos gateways tienes corriendo:
hermes gateway status
hermes gateway list
2. Recupera el servicio. Reiniciar interrumpe los turnos en vuelo, pero es la única recuperación inmediata:
hermes gateway restart
# varios profiles a la vez
hermes gateway restart --all
3. Entérate de cuándo llega el arreglo. El cambio se fusionó a main el 19 de octubre de 2026, después de que la v0.22.2 saliera el 15 de octubre, así que la versión actual no lo contiene. Tu próximo hermes update a una build que incluya el commit lo recoge; reinicia el gateway después. Si ejecutas desde un checkout del código siguiendo main, haz pull y reinicia.
4. Trata el gateway como un servicio de larga vida. Este bug es acumulativo, no depende de la carga: aparece en procesos que llevan semanas en marcha y construyen decenas de miles de agents. Dale al servicio una política de supervisión que lo reinicie si falla (systemd Restart=on-failure, launchd KeepAlive), para que una clase de bug así no te deje en silencio de un día para otro. Hermes tiene su propia maquinaria de watchdog y heartbeat que conviene combinar con eso: mira la guía del watchdog del bucle del gateway y la detección de heartbeats en desconexiones silenciosas.
Por qué conviene recordar este caso
Dos lecciones, ninguna específica de Hermes.
Los wrappers en una ruta caliente tienen que ser idempotentes para toda la familia, no para un solo miembro. Cualquier lógica de “envuélvelo si no está envuelto” con una comprobación de tipo estrecha se convierte en silencio en “envuélvelo en cada llamada”. Los tests unitarios no lo pillan, porque un test construye un solo agent; solo lo expone un proceso de larga duración, y los procesos de larga duración son lo más difícil de reproducir.
Los mensajes de error mienten sobre su capa. RecursionError suena a recursión desbocada en la lógica de negocio, pero venía de una cadena de reenvío de atributos en la capa de I/O. Cuando lo que hay en la cima del traceback no tiene nada que ver con lo que hace el código, sospecha del estado de infraestructura acumulado antes de ponerte a leer la lógica de negocio.
Si estás depurando el comportamiento del gateway, contrasta tus comandos con la referencia de hermes gateway primero, y usa cron doctor en el lado de las tareas programadas: los cron jobs suelen ser lo primero que se queja cuando un gateway se pone enfermo.
Resumen
- Síntoma: un gateway de larga duración falla en todos los turnos tras unos cientos de builds, con
RecursionErrordesdesetup_logging; reiniciar lo limpia. - Causa:
_install_safe_stdio()ythread_scoped_silence()no reconocían el proxy del otro, así que cada ciclo añadía dos eslabones por stream; unos 500 ciclos después, una consulta de atributo supera el límite de recursión. - Arreglo: una comprobación
isinstanceque cubre toda la familia de proxies. Fusionada amain, después de la v0.22.2. - Hoy: confírmalo con
hermes logs errors, recupérate conhermes gateway restart, espera la próxima actualización y supervisa el servicio.