Votre gateway se tait après quelques centaines de tours — deux wrappers s'empilaient sur stdout
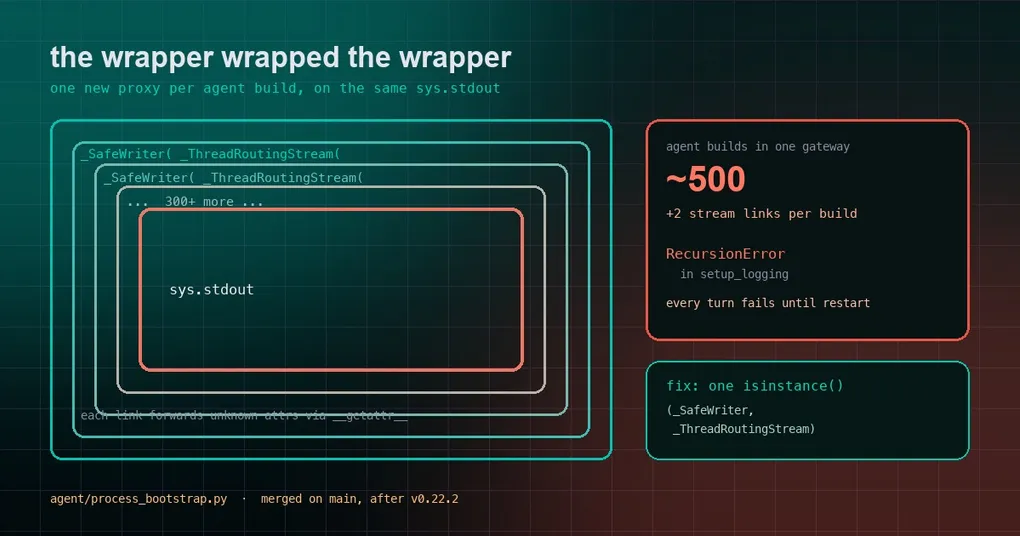
Votre bot répond toute la journée dans un chat actif. Puis, passé le message 500 environ, plus rien. Le process est vivant, le port écoute, hermes gateway status affirme que tout va bien — et pourtant chaque nouveau message échoue. Vous ouvrez le log et tombez sur une ligne qui n’a rien à voir avec la conversation : RecursionError: maximum recursion depth exceeded, avec une trace qui se termine dans setup_logging. Vous redémarrez le gateway, ça repart. Le lendemain, à la même heure, même panne.
Ce n’est ni une fuite mémoire, ni un modèle capricieux, ni une erreur de configuration de votre part. C’est le flux de sortie de Python : deux couches de proxies empilées l’une sur l’autre, jusqu’à ce qu’après quelques centaines de cycles la chaîne soit assez profonde pour dépasser la limite de récursion de l’interpréteur.
Le symptôme : pas de la lenteur, des échecs
Ça vaut la peine de cadrer le problème avant de partir en chasse, parce que les symptômes désignent le mauvais sous-système :
| Ce que vous voyez | Ce qui se passe réellement |
|---|---|
Le process du gateway est vivant, status répond running |
Le process va bien ; c’est chaque build d’agent qui lève |
RecursionError dans setup_logging, encore et encore |
Une résolution d’attribut traverse une chaîne de proxies très longue |
| Un redémarrage corrige tout instantanément | La chaîne a été remise à zéro — et recommence à grandir |
| Plus l’uptime est long, plus ça empire | Cela évolue avec les tours et les builds d’agent, pas avec le temps ni la charge |
Le mot clé, c’est longue durée. Redémarrez votre gateway tous les jours, ou n’utilisez Hermes depuis un terminal qu’occasionnellement, et vous ne verrez probablement jamais le problème. Faites-le tourner comme service avec Telegram, Discord, Slack, des cron jobs et la revue en arrière-plan activée : c’est une mèche lente.
Ce qui circule sur ce flux
Deux designs, chacun raisonnable pris isolément.
Le premier, c’est _install_safe_stdio(). À chaque construction d’agent, il enveloppe sys.stdout et sys.stderr dans un _SafeWriter, pour qu’un pipe cassé ou une erreur d’encodage pendant l’affichage de la progression ne fasse pas tomber tout l’agent. Comme il s’exécute à chaque build, il doit savoir reconnaître « déjà enveloppé » — et l’ancien test était étroit : si le flux est déjà un _SafeWriter, on passe.
Le second, c’est le proxy de routage par thread _ThreadRoutingStream, installé par la revue en arrière-plan quand elle a besoin de museler la sortie un moment. Quand thread_scoped_silence() se termine, il réinstalle un routeur.
Les deux tests ne sont pas d’accord :
_install_safe_stdio()ne connaissait que_SafeWriter. Voyant_ThreadRoutingStreampar-dessus, il concluait « pas à moi » et ajoutait un_SafeWriterde plus.thread_scoped_silence()ne voyait alors plus de routeur, et en installait un nouveau par-dessus ce wrapper.
Chaque cycle « construire un agent, museler une portée » ajoutait donc deux maillons à chaque flux :
_ThreadRoutingStream( _SafeWriter( _ThreadRoutingStream( _SafeWriter( ... ) ) ) )Chaque maillon relaie les attributs inconnus au suivant via __getattr__. Un saut, ce n’est rien. Mais avec des centaines de maillons, une seule lecture d’attribut doit traverser toute la chaîne — et au bout d’environ 500 cycles, la lecture de line_buffering dans setup_logging atteint la limite de récursion et lève RecursionError. À partir de là, chaque tour échoue jusqu’au redémarrage du gateway, qui jette la chaîne.
Un détail qui fait sous-estimer le phénomène : le déclencheur n’est pas « beaucoup de messages ». Ce sont les builds d’agent. Un tour qui lance des subagents, fait tourner la revue en arrière-plan et passe par plusieurs itérations d’outils construit bien plus d’agents que ce que le nombre de messages laisse imaginer.
Le correctif : un seul isinstance
Le changement fusionné est minuscule et vit dans agent/process_bootstrap.py :
def _install_safe_stdio() -> None:
    """Wrap stdout/stderr so best-effort console output cannot crash the agent."""
    for stream_name in ("stdout", "stderr"):
        stream = getattr(sys, stream_name, None)
        # Le proxy de routage absorbe déjà ces erreurs ; l'envelopper empile un nouveau proxy à chaque build.
        if stream is not None and not isinstance(stream, (_SafeWriter, _ThreadRoutingStream)):
            setattr(sys, stream_name, _SafeWriter(stream))
Le garde-fou reconnaît désormais toute la famille au lieu d’un seul membre. Le routeur absorbe déjà les deux erreurs pour lesquelles _SafeWriter existe (OSError et ValueError, traitées dans son propre chemin de relais et dans isatty()), il n’a donc pas besoin d’une seconde carapace protectrice.
Pas de passe de nettoyage, pas de protocole de coordination entre les deux installateurs : on vérifie le type une fois, et la chaîne reste plate pour toujours. Cela vaut pour toutes les surfaces du gateway — Telegram, Discord, Slack, Desktop, le serveur API — parce qu’elles passent toutes par le même bootstrap d’agent.
Que faire maintenant
1. Confirmez que c’est bien ce bug. Ne devinez pas, comptez :
hermes logs errors --since 7d | grep -c RecursionError
hermes logs errors --since 2d --level ERROR
Un compteur qui grimpe sur plusieurs jours, retombe à zéro au redémarrage et remonte ensuite, c’est la signature. Regardez ensuite combien de gateways tournent :
hermes gateway status
hermes gateway list
2. Rétablissez le service. Un redémarrage interrompt les tours en cours, mais c’est la seule reprise immédiate :
hermes gateway restart
# plusieurs profils côte à côte
hermes gateway restart --all
3. Sachez quand le correctif arrive. Le changement a été fusionné sur main le 19 octobre 2026 — après la sortie de la v0.22.2 le 15 octobre — donc la release actuelle ne le contient pas. Votre prochain hermes update vers une build qui inclut le commit le récupère ; redémarrez le gateway ensuite. Si vous tournez depuis un checkout source qui suit main, faites un pull et redémarrez.
4. Traitez un gateway comme un service de longue durée. Ce bug est cumulatif, pas lié à la charge : il apparaît dans des process qui tournent des semaines et construisent des dizaines de milliers d’agents. Donnez au service une politique de supervision qui le redémarre en cas d’échec (systemd Restart=on-failure, launchd KeepAlive), pour qu’une classe de bug comme celle-ci ne vous laisse pas muet pendant la nuit. Hermes a son propre watchdog et sa mécanique de heartbeat, qui valent la peine d’être combinés — voir le guide du watchdog de boucle du gateway et la détection de déconnexion silencieuse par heartbeat.
Pourquoi ce cas mérite d’être retenu
Deux leçons, aucune spécifique à Hermes.
Les wrappers sur un chemin chaud doivent être idempotents sur toute la famille, pas sur un seul membre. Toute logique du type « enveloppe si ce n’est pas déjà enveloppé » avec un test de type trop étroit devient silencieusement « enveloppe à chaque appel ». Les tests unitaires ne l’attraperont pas, parce qu’un test construit un agent ; seul un process de longue durée révèle le problème, et les process de longue durée sont ce qu’il y a de plus dur à reproduire.
Les messages d’erreur mentent sur leur couche. RecursionError se lit comme une récursion folle dans la logique métier, alors qu’il venait d’une chaîne de relais d’attributs dans la couche I/O. Quand le haut de la trace n’a rien à voir avec ce que fait le code, soupçonnez un état d’infrastructure accumulé avant de vous plonger dans la logique métier.
Si vous déboguez le comportement du gateway, vérifiez d’abord vos commandes dans la référence hermes gateway, et côté planification utilisez cron doctor — les cron jobs sont généralement les premiers à se plaindre quand un gateway va mal.
Résumé
- Symptôme : un gateway de longue durée échoue à chaque tour après quelques centaines de builds,
RecursionErrordepuissetup_logging, un redémarrage efface le problème. - Cause :
_install_safe_stdio()etthread_scoped_silence()ne reconnaissaient pas le proxy de l’autre, donc chaque cycle ajoutait deux maillons par flux ; environ 500 cycles plus tard, une lecture d’attribut dépasse la limite de récursion. - Correctif : un seul test
isinstancecouvrant toute la famille de proxies. Fusionné surmain, après la v0.22.2. - Aujourd’hui : confirmez avec
hermes logs errors, repartez avechermes gateway restart, attendez la prochaine mise à jour — et supervisez le service.