Ele disse que o job foi criado. O job nunca existiu.
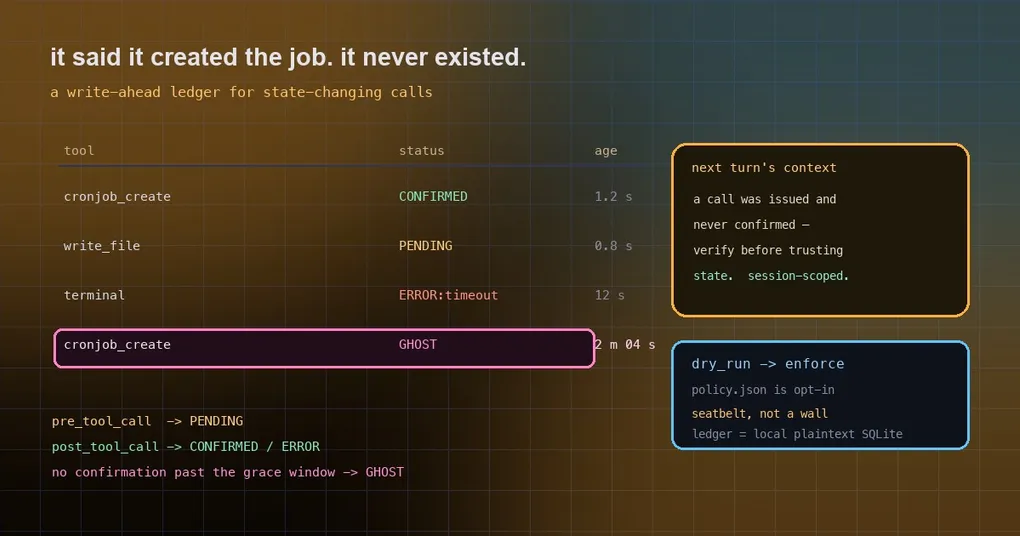
Você pede ao agente para criar um job que roda toda manhã. Ele responde: criado, começa às 8h de amanhã. Às 8h do dia seguinte, nada acontece. Você abre jobs.json — não existe esse job. Você confere os registros de execução — vazios. O log parece dizer que nada nunca aconteceu. Ele não mentiu para você: ele de fato chamou a ferramenta. O resultado simplesmente nunca chegou, porque a compactação de contexto substituiu todo aquele turno por um resumo, e com ele se foram tanto “a chamada foi emitida” quanto “o job existe”.
O que torna esse tipo de falha tão desagradável não é a operação perdida. É que ninguém sabe que ela se perdeu. O agente acredita que nunca fez a coisa, você acredita que ele nunca fez a coisa, e então ninguém volta para consertar. O plugin da comunidade agent-ledger, que entrou no catálogo oficial de plugins esta semana, vigia exatamente essa lacuna — e, de quebra, expõe uma pergunta mais geral: o que o seu agente realmente fez que mudou alguma coisa?
O que é uma chamada fantasma
Um pouco de contexto primeiro. Quando uma sessão se aproxima do seu limite de contexto, o Hermes compacta: turnos mais antigos são substituídos por um resumo para que a conversa possa continuar. Esse mecanismo é necessário, mas tem um caso de borda. Quando a compactação dispara no meio de uma chamada de ferramenta que já foi emitida mas cujo resultado ainda não foi confirmado, o turno é substituído por inteiro. As consequências:
- a operação nunca foi concluída;
- sem erro, sem retry, sem linha de log;
- o estado da sessão diz que a ferramenta nunca foi chamada.
A issue upstream #90985 documenta um caso real: um cronjob_create foi emitido às 20:39:07Z e o job não existia em lugar nenhum — nem em jobs.json, nem em executions.db, nem em cron/output/. O caminho provável descrito na issue: um turno emite várias chamadas de ferramenta, a saída delas empurra o contexto além do limite de compactação, a verificação de preflight dispara, o histórico é reescrito como um resumo, e o resultado da chamada evapora junto. Nenhum vestígio de que algo foi tentado.
Até o core fechar essa janela (e, discutivelmente, depois também), um ledger que sabe o que pode ter perdido justifica o seu lugar. Essa é a premissa do agent-ledger.
Como ele as detecta: um ledger write-ahead
O plugin se conecta a quatro hooks e registra toda chamada de ferramenta que muda estado em um ledger local:
| Hook | O que faz |
|---|---|
pre_tool_call |
escreve uma entrada PENDING (ferramenta, args, timestamp, sessão) |
post_tool_call |
muda a entrada para CONFIRMED, ou registra ERROR:<type> |
pre_llm_call |
reconcilia: um PENDING mais velho que o seu período de carência é um fantasma |
on_session_start |
acerta as contas no início da sessão |
Somente ferramentas que mudam estado são rastreadas: write_file, patch, terminal, cronjob, delegate_task, mutações de kanban, e toda ferramenta MCP (reconhecida pelo prefixo mcp__). Ferramentas somente leitura não custam nada.
Os períodos de carência são por ferramenta em vez de um número global — dois minutos por padrão, mas 30 minutos para delegate_task e 15 para terminal, para que chamadas de longa duração não sejam rotuladas errado. Uma chamada reportada por engano como fantasma que depois se confirma é revivida em vez de duplicar a sua linha. As entradas são inserções SQLite em modo WAL, abaixo de 10 ms segundo o autor, e o ledger nunca bloqueia e nunca reescreve argumentos — é um gravador de voo, não um portão.
Para olhar você mesmo:
sqlite3 ~/.hermes/plugin-data/agent-ledger/ledger.db "
  SELECT ts, tool_name, status, substr(args_json,1,60)
  FROM ledger ORDER BY id DESC LIMIT 20;"
Existem quatro status: PENDING, CONFIRMED, ERROR:<type>, e GHOST_REPORTED (já apresentado ao agente).
Por que ele avisa o agente no turno seguinte em vez de parar a chamada
Esta é a decisão de design que vale a pena copiar.
Quando um fantasma é detectado, aquele turno já acabou — não dá para voltar e refazê-lo. Então o plugin empurra o fato para o turno seguinte: o hook pre_llm_call pode retornar um valor context, que é injetado na mensagem de usuário do turno atual, e não no system prompt. O system prompt é sensível a cache; tocar nele invalida o cache. Coloque o aviso na mensagem de usuário, e o agente aprende dentro da conversa, onde ainda consegue agir: uma chamada foi emitida e nunca confirmada — verifique o estado antes de confiar nele.
A segunda decisão é igualmente contida: por que não recusar chamadas suspeitas no pre_tool_call? Porque o Hermes fecha esse hook em caso de falha após um timeout de 30 segundos — um ledger lento acabaria bloqueando ferramentas legítimas. Um gravador de voo não deveria ter esse poder. Bloquear é um recurso separado e opcional, discutido abaixo.
Colocando para rodar
Instale pelo catálogo oficial (a entrada chegou esta semana):
hermes plugins install agent-ledger
hermes plugins enable agent-ledger
Para rodar a versão do repositório do mantenedor, em vez disso, o README a clona em ~/.hermes/plugins/agent-ledger/, a habilita, e reinicia o gateway para que o plugin carregue na próxima sessão.
Depois rode o autoteste para conferir as assinaturas de hook contra a sua versão:
python3 selftest.pyEle verifica o pareamento emissão-e-confirmação, a confirmação de fallback pelo nome da ferramenta, a detecção de fantasmas, a injeção de contexto, e que apenas ferramentas de mutação são registradas.
O bônus: um score de postura OWASP
O plugin também traz um script que pontua a atividade registrada contra o OWASP Top 10 for Agentic Applications 2026:
python3 posture.py                        # pontua o ledger atual
python3 -m posture ~/.hermes/plugin-data/agent-ledger/ledger.db
Apenas a partir dos metadados do ledger, ele cobre uso indevido de ferramentas (ASI02), execução de código inesperada (ASI05), falhas em cascata (ASI08) e agentes desonestos (ASI10), além de uma extensão da comunidade para agência excessiva rotulada ASI11 — a lista oficial para no ASI10, e o autor deixa isso claro em todo lugar em que aparece. A pontuação é auditável: score = 100 − Σ severity_weight(finding), com CRITICAL 25 / HIGH 15 / MEDIUM 8 / LOW 3, achados nunca desduplicados, e a lista completa de achados sempre retornada para que você possa recalculá-la à mão.
O seu modelo de confiança é declarado sem rodeios, e é a frase a guardar: o ledger é escrito pelo agente que está sendo avaliado. Um observador não consegue pontuar um agente que não registra nada, então um score de 100 significa “nada suspeito na atividade registrada” — e não “este agente se comportou bem”. Trate-o como um sinal de higiene, não como prova.
Aplicação de políticas: comece com um dry run
Observar é o que o core faz; aplicar é a camada opcional que este plugin adiciona. Instale um pacote de política e observe por alguns dias o que seria bloqueado:
cp policy.example.json ~/.hermes/plugin-data/agent-ledger/policy.json
echo dry_run > ~/.hermes/plugin-data/agent-ledger/policy_mode   # só registra, não bloqueia nada
Quando o relatório mostrar coisas que você realmente quer que parem, mude para enforce: as chamadas que casam são recusadas antes de rodar, com o motivo entregue de volta ao agente.
A honestidade do autor sobre a cobertura merece ser repassada: o casamento é baseado em assinatura sobre o comando extraído, então trate isso como um cinto de segurança, não um muro. Pelo menos três contornos são conhecidos — compor a string destrutiva com sh -c (o literal nunca aparece no comando), indireção por variáveis de ambiente (rm -rf $TARGET), e dividir uma ação perigosa em duas chamadas individualmente inofensivas. O que ele pega de forma confiável é a classe de desastre acidental: exclusões recursivas, pipe para shell, leitura de credenciais. É exatamente para isso que serve o relatório de dry run.
Onde os dados moram, e como tratá-los
- O ledger é um banco SQLite de texto puro local em
<hermes_home>/plugin-data/agent-ledger/ledger.db. Ele armazena argumentos de ferramenta até 4000 caracteres (comandos de terminal, conteúdos de arquivo, argumentos MCP) mais um resumo de resultado de 300 caracteres. Qualquer pessoa com acesso ao sistema de arquivos consegue lê-lo — trate-o como o seu histórico de shell. - Os avisos de fantasma têm escopo de sessão: uma sessão só enxerga as suas próprias chamadas não confirmadas.
- O ledger nunca é podado automaticamente. Defina o seu próprio limite se quiser um, por exemplo manter as 50.000 linhas mais recentes:
sqlite3 ~/.hermes/plugin-data/agent-ledger/ledger.db \
"DELETE FROM ledger WHERE id NOT IN (SELECT id FROM ledger ORDER BY id DESC LIMIT 50000)"- Para um relatório diário de postura,
posture_daily.pyé agendado por você, não pelo plugin, e usa as suas próprias credenciais de bot (POSTURE_TELEGRAM_BOT_TOKEN/POSTURE_TELEGRAM_CHAT_ID). Ele nunca lê o.envdo Hermes e nunca reutiliza o token de bot do seu agente.
Como isso se relaciona com o que o Hermes já faz
O Hermes tem as suas próprias proteções em torno do trabalho agendado: qual processo reivindicou um job, em que estado ele está travado, há quanto tempo está em silêncio — cobrimos a mecânica em integridade da compactação no meio do turno e na referência de cron. O agent-ledger chega pelo outro lado: ele não se importa com o estado de um job, se importa se uma ação que muda estado foi emitida sem confirmação, e cobre muito mais que cron — toda ferramenta de mutação. Os dois não conflitam, e instalá-lo não muda nada no comportamento do Hermes, a menos que você ligue a aplicação de política explicitamente.
A versão curta
- “A operação não aconteceu” e “a operação aconteceu, mas ninguém sabe” são falhas diferentes, e a segunda costuma ser mais cara porque nada a traz à tona.
- Um ledger write-ahead PENDING → CONFIRMED, janelas de carência por ferramenta e injeção de contexto com escopo de sessão transformam uma chamada fantasma em uma linha de conselho: verifique antes de confiar.
- O score de postura é uma lente de auditoria útil, mas o ledger é escrito pela parte que está sendo medida — leia-o como higiene, não como veredito.
- A aplicação de política é opcional e baseada em assinatura, com os contornos documentados pelo autor. Rode primeiro em modo dry run e veja o que ele realmente pegaria.