Il a dit que la tâche était créée. La tâche n'a jamais existé.
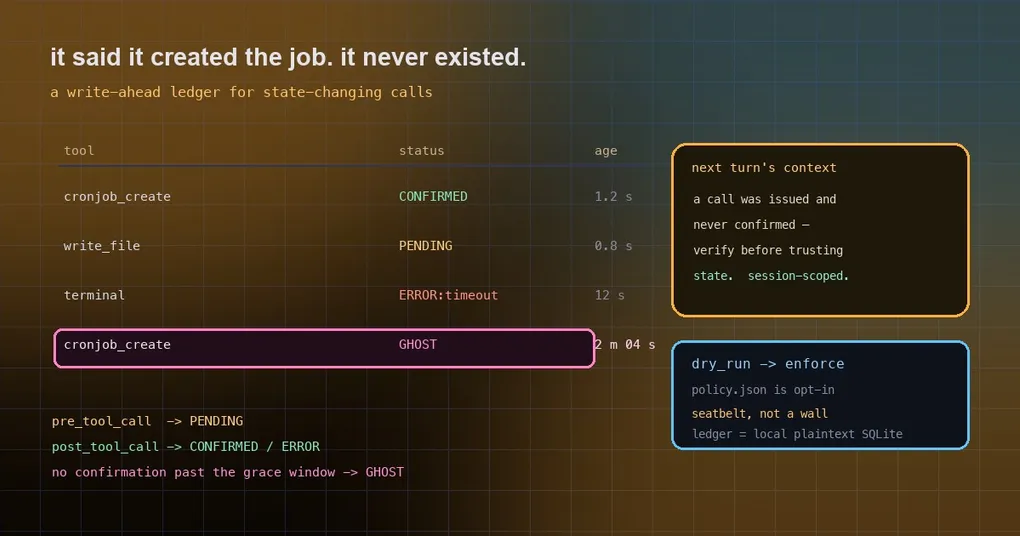
Vous demandez à l’agent de mettre en place une tâche qui s’exécute chaque matin. Il répond : créée, démarre demain à 8 h. Le lendemain à 8 h, il ne se passe rien. Vous ouvrez jobs.json — aucune tâche de ce nom. Vous consultez les enregistrements d’exécution — vides. Le journal donne l’impression que rien ne s’est jamais produit. Il ne vous a pas menti : il a bel et bien appelé l’outil. Le résultat n’est simplement jamais arrivé, parce que la compaction du contexte a remplacé tout ce tour par un résumé, emportant avec lui à la fois « l’appel a été émis » et « la tâche existe ».
Ce qui rend cette classe de panne pénible, ce n’est pas l’opération perdue. C’est que personne ne sait qu’elle a été perdue. L’agent croit qu’il n’a jamais fait la chose, vous croyez qu’il ne l’a jamais faite, et donc personne ne revient la réparer. Le plugin communautaire agent-ledger, entré cette semaine dans le catalogue officiel de plugins, surveille exactement ce trou — et, chemin faisant, met au jour une question plus générale : qu’a réellement fait votre agent qui ait changé quelque chose ?
Ce qu’est un appel fantôme
D’abord un peu de contexte. Quand une session approche de son seuil de contexte, Hermes compacte : les tours plus anciens sont remplacés par un résumé pour que la conversation puisse continuer. Ce mécanisme est nécessaire, mais il a un cas limite. Quand la compaction se déclenche au milieu d’un appel d’outil qui a été émis mais dont le résultat n’est pas encore validé, le tour est remplacé en bloc. Les conséquences :
- l’opération ne s’est jamais terminée ;
- aucune erreur, aucune nouvelle tentative, aucune ligne de journal ;
- l’état de session déclare que l’outil n’a jamais été appelé.
Le ticket amont #90985 documente un cas réel : un cronjob_create a été émis à 20:39:07Z et la tâche n’existait nulle part — ni dans jobs.json, ni dans executions.db, ni dans cron/output/. Le scénario plausible décrit dans le ticket : un tour émet plusieurs appels d’outils, leur sortie pousse le contexte au-delà du seuil de compaction, la vérification préalable se déclenche, l’historique est réécrit en résumé, et le résultat de l’appel s’évapore avec lui. Aucune trace qu’une tentative ait eu lieu.
Jusqu’à ce que le cœur ferme cette fenêtre (et sans doute après), un registre qui sait ce qu’il a pu perdre gagne sa place. C’est la prémisse d’agent-ledger.
Comment il les détecte : un registre en écriture anticipée
Le plugin se branche sur quatre hooks et enregistre chaque appel d’outil modifiant l’état dans un registre local :
| Hook | Ce qu’il fait |
|---|---|
pre_tool_call |
écrit une entrée PENDING (outil, args, horodatage, session) |
post_tool_call |
bascule l’entrée en CONFIRMED, ou enregistre ERROR:<type> |
pre_llm_call |
réconcilie : une entrée PENDING plus ancienne que son délai de grâce est un fantôme |
on_session_start |
met les comptes d’aplomb au démarrage de session |
Seuls les outils qui changent l’état sont suivis : write_file, patch, terminal, cronjob, delegate_task, les mutations kanban et tout outil MCP (reconnu par le préfixe mcp__). Les outils en lecture seule ne coûtent rien.
Les délais de grâce sont définis par outil plutôt qu’une valeur globale unique — deux minutes par défaut, mais 30 minutes pour delegate_task et 15 pour terminal, afin que les appels longs ne soient pas mal étiquetés. Un appel signalé à tort comme fantôme et confirmé plus tard est réactivé au lieu de dupliquer sa ligne. Les entrées sont des insertions SQLite en mode WAL, sous les 10 ms selon l’auteur, et le registre ne bloque jamais et ne réécrit jamais les arguments — c’est un enregistreur de vol, pas une barrière.
Pour le consulter vous-même :
sqlite3 ~/.hermes/plugin-data/agent-ledger/ledger.db "
  SELECT ts, tool_name, status, substr(args_json,1,60)
  FROM ledger ORDER BY id DESC LIMIT 20;"
Quatre statuts existent : PENDING, CONFIRMED, ERROR:<type> et GHOST_REPORTED (déjà remonté à l’agent).
Pourquoi il prévient l’agent au tour suivant plutôt que d’arrêter l’appel
C’est la décision de conception qui mérite d’être reprise.
Au moment où un fantôme est détecté, ce tour est terminé — vous ne pouvez pas revenir en arrière pour le refaire. Le plugin pousse donc le fait dans le tour suivant : le hook pre_llm_call peut renvoyer une valeur context, injectée dans le message utilisateur du tour courant plutôt que dans le prompt système. Le prompt système est sensible au cache ; y toucher invalide le cache. Placez l’avertissement dans le message utilisateur, et l’agent apprend au sein même de la conversation, là où il peut encore agir : un appel a été émis et jamais confirmé — vérifiez l’état avant de vous y fier.
La seconde décision est tout aussi mesurée : pourquoi ne pas refuser les appels suspects dans pre_tool_call ? Parce que Hermes ferme ce hook en échec après un délai de 30 secondes — un registre lent finirait par bloquer des outils légitimes. Un enregistreur de vol ne devrait pas avoir ce pouvoir. Le blocage est une fonctionnalité distincte, à activer explicitement, dont il est question plus bas.
Le mettre en route
Installez depuis le catalogue officiel (l’entrée est arrivée cette semaine) :
hermes plugins install agent-ledger
hermes plugins enable agent-ledger
Pour exécuter plutôt la version du dépôt du mainteneur, le README la clone dans ~/.hermes/plugins/agent-ledger/, l’active et redémarre le gateway afin que le plugin se charge à la session suivante.
Lancez ensuite l’auto-test pour vérifier les signatures des hooks par rapport à votre version :
python3 selftest.pyIl vérifie l’appariement émission/confirmation, la confirmation de repli par nom d’outil, la détection des fantômes, l’injection de contexte, et que seuls les outils mutants sont enregistrés.
Le bonus : un score de posture OWASP
Le plugin livre aussi un script qui note l’activité enregistrée au regard du Top 10 OWASP pour les applications agentiques 2026 :
python3 posture.py                        # noter le registre en direct
python3 -m posture ~/.hermes/plugin-data/agent-ledger/ledger.db
À partir des seules métadonnées du registre, il couvre le mauvais usage des outils (ASI02), l’exécution de code inattendue (ASI05), les défaillances en cascade (ASI08) et les agents rebelles (ASI10), plus une extension communautaire pour l’agencéité excessive étiquetée ASI11 — la liste officielle s’arrête à ASI10, et l’auteur le précise partout où elle apparaît. La notation est auditable : score = 100 − Σ severity_weight(finding), avec CRITICAL 25 / HIGH 15 / MEDIUM 8 / LOW 3, les constats jamais dédupliqués, et la liste complète des constats toujours renvoyée pour que vous puissiez la recalculer à la main.
Son modèle de confiance est énoncé sans détour, et c’est la phrase à retenir : le registre est écrit par l’agent qui est noté. Un observateur ne peut pas noter un agent qui ne journalise rien, si bien qu’un score de 100 signifie « rien de suspect dans l’activité enregistrée » — et non « cet agent s’est bien comporté ». À traiter comme un signal d’hygiène, pas comme une preuve.
Application des règles : commencez par une simulation
L’observation, c’est ce que fait le cœur ; l’application des règles est la couche optionnelle que ce plugin ajoute. Installez un pack de règles et observez pendant quelques jours ce qui aurait été bloqué :
cp policy.example.json ~/.hermes/plugin-data/agent-ledger/policy.json
echo dry_run > ~/.hermes/plugin-data/agent-ledger/policy_mode   # journaliser seulement, ne rien bloquer
Une fois que le rapport vous montre des choses que vous voulez réellement arrêter, passez à enforce : les appels correspondants sont refusés avant de s’exécuter, avec le motif renvoyé à l’agent.
L’honnêteté de l’auteur sur la couverture mérite d’être transmise : la mise en correspondance repose sur des signatures appliquées à la commande extraite, alors considérez-la comme une ceinture de sécurité, pas un mur. Au moins trois contournements sont connus — composer la chaîne destructive avec sh -c (le littéral n’apparaît jamais dans la commande), passer par des variables d’environnement (rm -rf $TARGET), et scinder une action dangereuse en deux appels individuellement inoffensifs. Ce qu’il attrape de façon fiable, c’est la classe du désastre accidentel : suppressions récursives, pipe vers un shell, lecture d’identifiants. C’est exactement à cela que sert le rapport de simulation.
Où vivent les données, et comment les traiter
- Le registre est une base SQLite locale en texte clair à l’emplacement
<hermes_home>/plugin-data/agent-ledger/ledger.db. Elle stocke les arguments d’outils jusqu’à 4000 caractères (commandes du terminal, contenus de fichier, arguments MCP) plus un condensé du résultat de 300 caractères. Quiconque a accès au système de fichiers peut le lire — traitez-le comme votre historique de shell. - Les avertissements de fantômes sont limités à la session : une session ne voit jamais que ses propres appels non confirmés.
- Le registre n’est jamais purgé automatiquement. Fixez votre propre plafond si vous en voulez un, par exemple en gardant les 50 000 lignes les plus récentes :
sqlite3 ~/.hermes/plugin-data/agent-ledger/ledger.db \
"DELETE FROM ledger WHERE id NOT IN (SELECT id FROM ledger ORDER BY id DESC LIMIT 50000)"- Pour un rapport de posture quotidien,
posture_daily.pyest planifié par vous, pas par le plugin, et il utilise ses propres identifiants de bot (POSTURE_TELEGRAM_BOT_TOKEN/POSTURE_TELEGRAM_CHAT_ID). Il ne lit jamais le.envde Hermes et ne réutilise jamais le token de bot de votre agent.
Comment cela se rapporte à ce que Hermes fait déjà
Hermes dispose de ses propres protections autour du travail planifié : quel processus a réclamé une tâche, dans quel état elle est bloquée, depuis combien de temps elle est silencieuse — nous avons détaillé la mécanique dans l’intégrité de la compaction en milieu de tour et dans la référence cron. agent-ledger l’aborde par l’autre bout : il ne se soucie pas de l’état d’une tâche, il se soucie de savoir si une action modifiant l’état a été émise sans confirmation, et il couvre bien plus que cron — tous les outils mutants. Les deux ne s’opposent pas, et l’installer ne change rien au comportement de Hermes tant que vous n’activez pas explicitement l’application des règles.
La version courte
- « L’opération n’a pas eu lieu » et « l’opération a eu lieu mais personne ne le sait » sont deux pannes différentes, et la seconde coûte souvent plus cher parce que rien ne la fait remonter.
- Un registre en écriture anticipée PENDING → CONFIRMED, des délais de grâce par outil et une injection de contexte limitée à la session transforment un appel fantôme en une ligne de conseil : vérifier avant de se fier.
- Le score de posture est une loupe d’audit utile, mais le registre est écrit par la partie qui est mesurée — lisez-le comme de l’hygiène, pas comme un verdict.
- L’application des règles est optionnelle et fondée sur des signatures, avec les contournements documentés par l’auteur. Lancez-la d’abord en mode simulation et voyez ce qu’elle attraperait réellement.