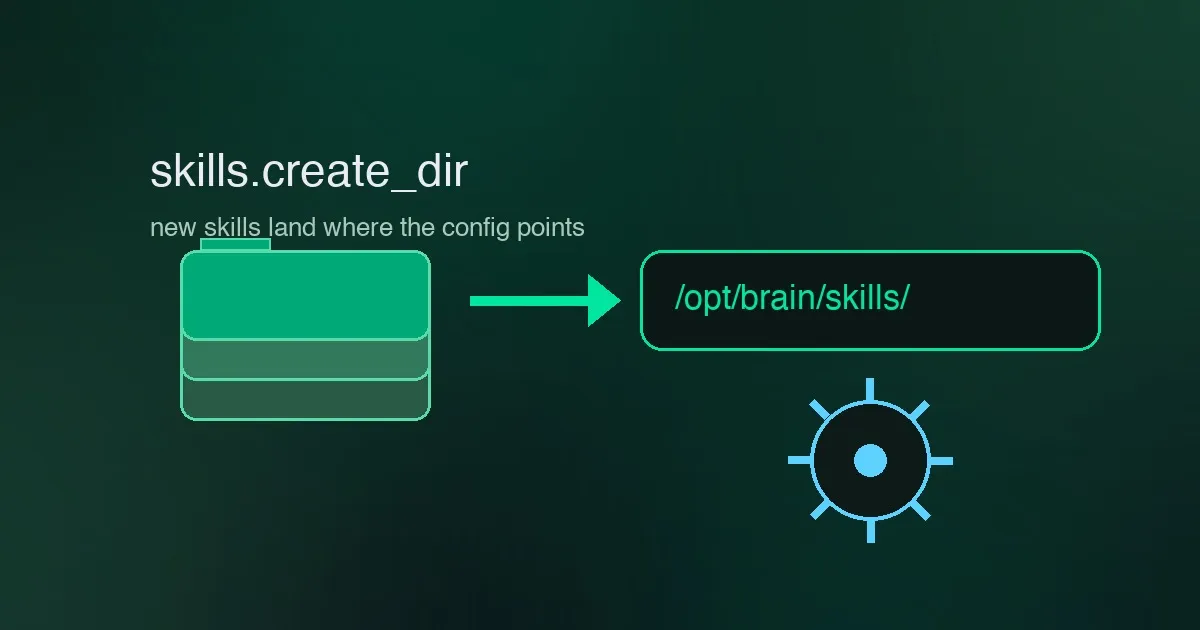
skills.create_dir : faites atterrir les nouvelles skills là où votre config le dit — pas là où le prompt est ignoré
Dire à votre agent de créer des skills dans /opt/brain/skills via un prompt n'est qu'une suggestion ; l'outil skill_manage écrit dans ~/.hermes/skills/ et aucun system prompt ne peut contrer un chemin de fichier. La nouvelle clé de config skills.create_dir (PR #100377, fusionnée le 1er septembre) dirige les skills créées par l'agent vers n'importe quel répertoire — et chaque chaîne d'instructions, schema d'outil et doc qui nomme le chemin de création affiche dynamiquement votre répertoire configuré, si bien que config, outil et prompt s'accordent enfin.
Lire la suite
Vos tâches cron sont mortes en silence ? Une seule commande ausculte toute la flotte
Vos tâches planifiées peuvent rester mortes en silence pendant des jours sans que vous le sachiez — cron list et cron status ont l'air « normaux ». La nouvelle commande hermes cron doctor vérifie chaque tâche en une seule passe : exécutions échouées, livraisons échouées, next_run_at en retard, scripts manquants et workdirs morts, et renvoie le code 1 dès qu'une action est nécessaire. Fusionnée le 31 août (PR #99479), actuellement sur main uniquement.
Lire la suite
Le cron multi-profile cesse enfin de se croiser : chaque profile livre via son propre bot
Si vous utilisez Hermes avec plusieurs profiles, vous avez peut-être déjà vu ça : le résultat cron du profile B arrive depuis le bot du profile A — ou échoue carrément avec « Bot not in chat ». Un correctif fusionné le 31 août (PR #99375) fait suivre l'identité de livraison au profile propriétaire de la tâche : chaque profile envoie via son propre bot, ses propres identifiants et son propre chat de référence, et hermes -p X cron status cesse de mentir.
Lire la suite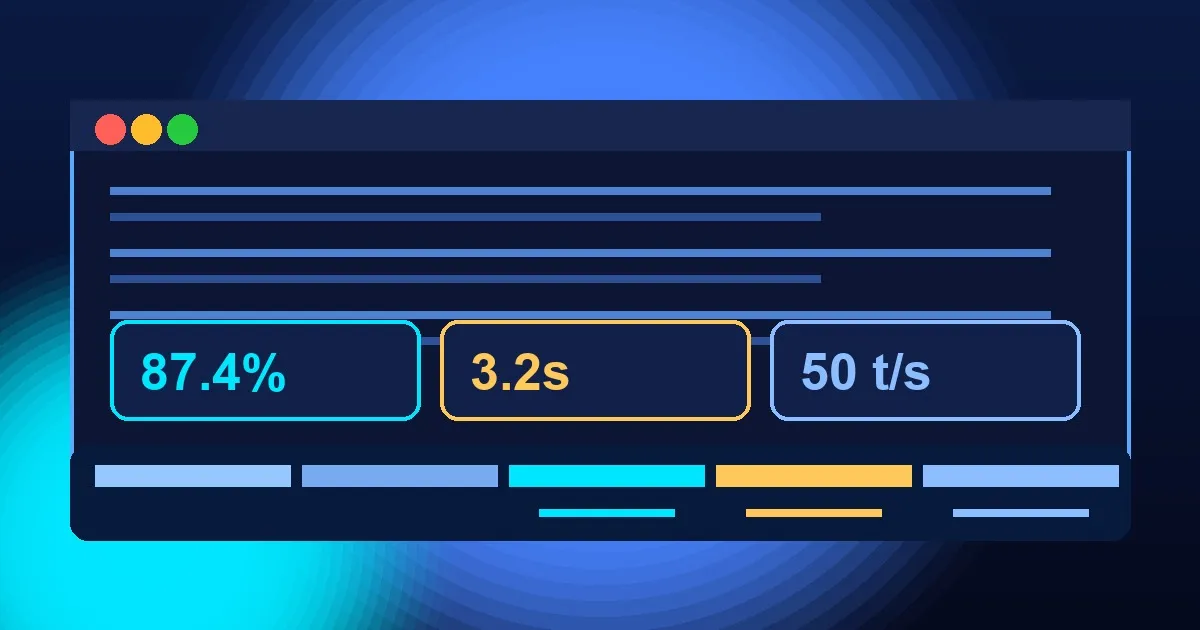
Barre de statut améliorée : taux de cache-hit, latence et tokens/seconde en un coup d'œil
La barre de statut du CLI Hermes a gagné trois nouvelles métriques : le taux de cache-hit du prompt (◎), la latence moyenne glissante (◷) et les tokens de sortie par seconde (↑) — et chaque champ peut être activé ou désactivé via display.status_bar.fields. Le taux de cache-hit est un lien direct vers votre facture API : plus il y a de hits, plus le coût baisse. Fusionnée le 30 août (PR #98250), actuellement sur main uniquement.
Lire la suite
« Session not found » ? state.db détecte, met en quarantaine et se répare désormais lui-même
Hermes stocke tout l'historique des sessions dans state.db. Par le passé, lorsque la base de données se corrompait, vous ne voyiez qu'un déroutant « session not found » — et le système continuait d'écrire dans la base cassée, aggravant les dégâts. Une série de correctifs fusionnés du 30 au 31 août (PR #99513 et ses voisines) apprend à Hermes à gérer la corruption correctement : la détecter, mettre le fichier en quarantaine, réparer ce qui peut l'être et échouer bruyamment au lieu de faire comme si tout allait bien.
Lire la suite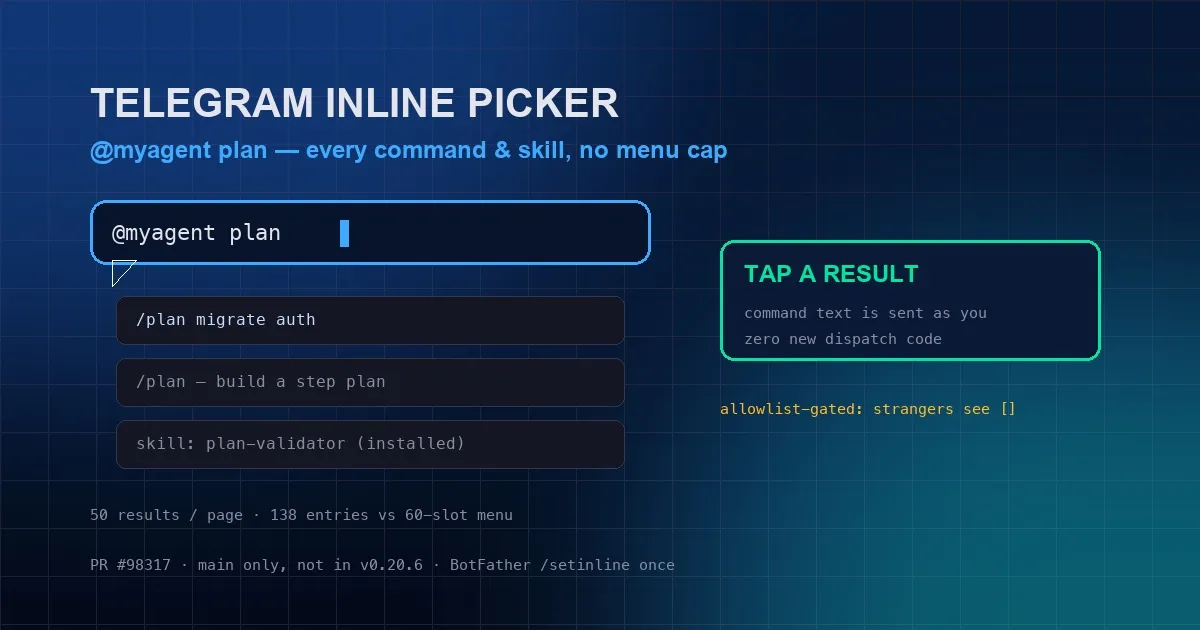
Recherchez toutes les commandes et tous les skills de Hermes dans Telegram : le sélecteur inline @botname contourne la limite des 60 emplacements du menu
Telegram plafonne durement le menu de commandes `/` (100 par scope, ~4 Ko de charge utile ; Hermes en expose 60 par défaut), si bien que les commandes de skills disparaissent dès que vous en installez assez. Une fonctionnalité fusionnée le 30 août contourne totalement cette limite : tapez `@yourbotname` + un mot-clé dans n'importe quel chat et obtenez un sélecteur vivant et recherchable sur toutes les commandes et skills installés — calculé à chaque frappe, paginé 50 par 50, un appui envoie la commande dans le chat.
Lire la suite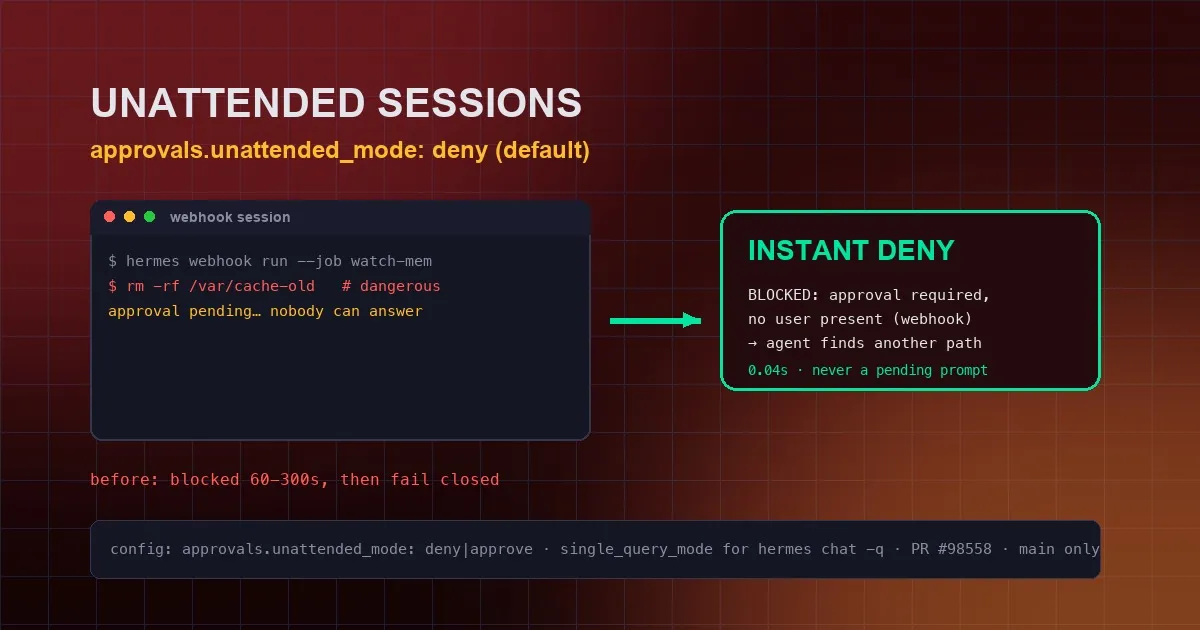
Fini les blocages d'approbation de 5 minutes pour les Hermes sans surveillance : la nouvelle clé approvals.unattended_mode
Les sessions webhook, msgraph_webhook et api_server bloquaient autrefois pendant tout le délai d'approbation de 60 à 300 s quand elles tombaient sur une commande dangereuse — parce qu'aucun humain n'existe pour répondre /approve sur ces surfaces. Un correctif fusionné le 30 août ajoute approvals.unattended_mode (deny par défaut) pour que ces sessions échouent instantanément avec une raison claire au lieu de stagner, plus single_query_mode pour les sessions one-shot hermes chat -q.
Lire la suite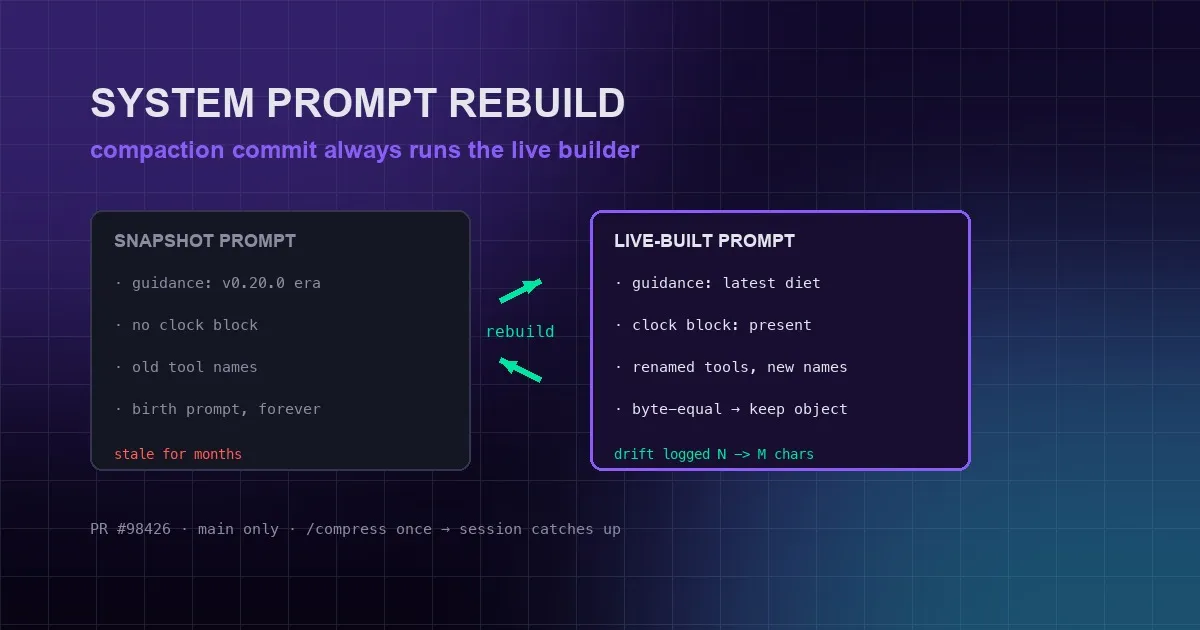
Les sessions de longue durée rattrapent enfin leur retard : la compaction reconstruit désormais toujours le prompt système
Hermes restaurait autrefois le prompt système d'une session de longue durée octet pour octet depuis son snapshot à chaque compaction — si bien que les améliorations de guidance, les nouveaux blocs de prompt et les renommages d'outils n'atteignaient jamais une session qui tournait depuis des mois. Un changement fusionné le 30 août (PR #98426) fait en sorte que le commit de compaction exécute toujours le builder de prompt vivant : une sortie identique octet pour octet conserve l'objet d'origine (caches de préfixe intacts), une sortie divergente gagne et journalise le diff.
Lire la suite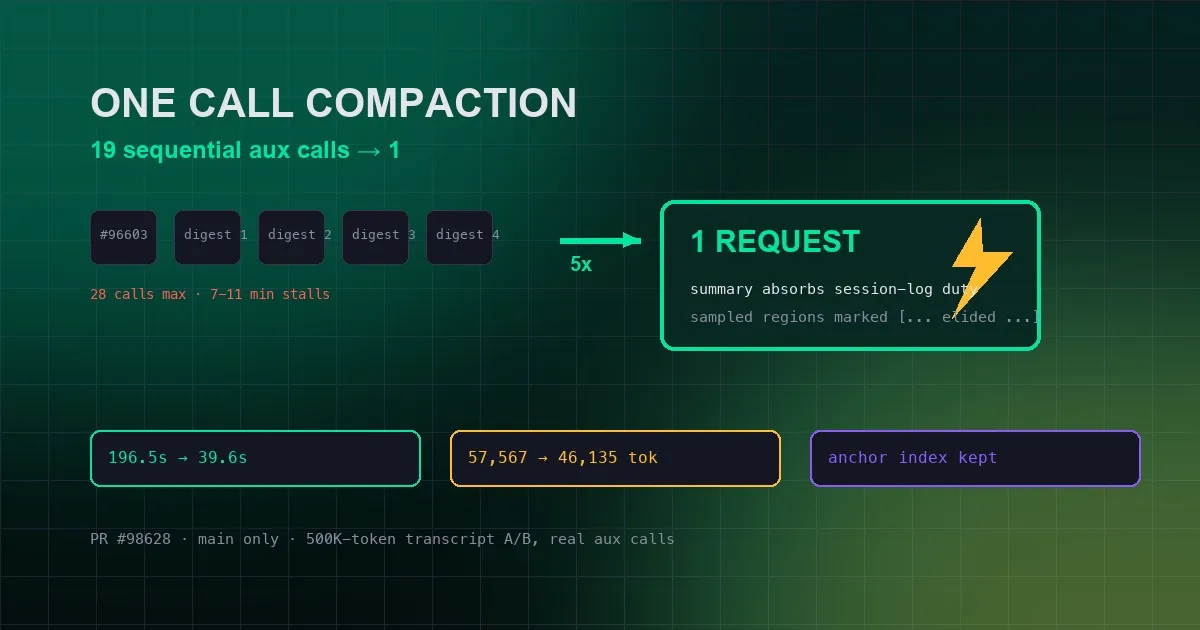
La compression de contexte devient 5× plus rapide : une requête auxiliaire au lieu de 19
L'ancienne compaction lean appelait le modèle auxiliaire une fois par morceau d'historique pour construire des digests — jusqu'à 28 appels séquentiels sur une grosse session, transformant la compaction en blocages de 7 à 11 minutes sur les routes auxiliaires lentes. Un changement fusionné le 30 août (PR #98628) supprime la boucle de digests : une requête auxiliaire par tentative de compaction. Mesuré sur un vrai transcript de 500K tokens : de 196,5 s à 39,6 s, et ~11K tokens de moins après compaction.
Lire la suite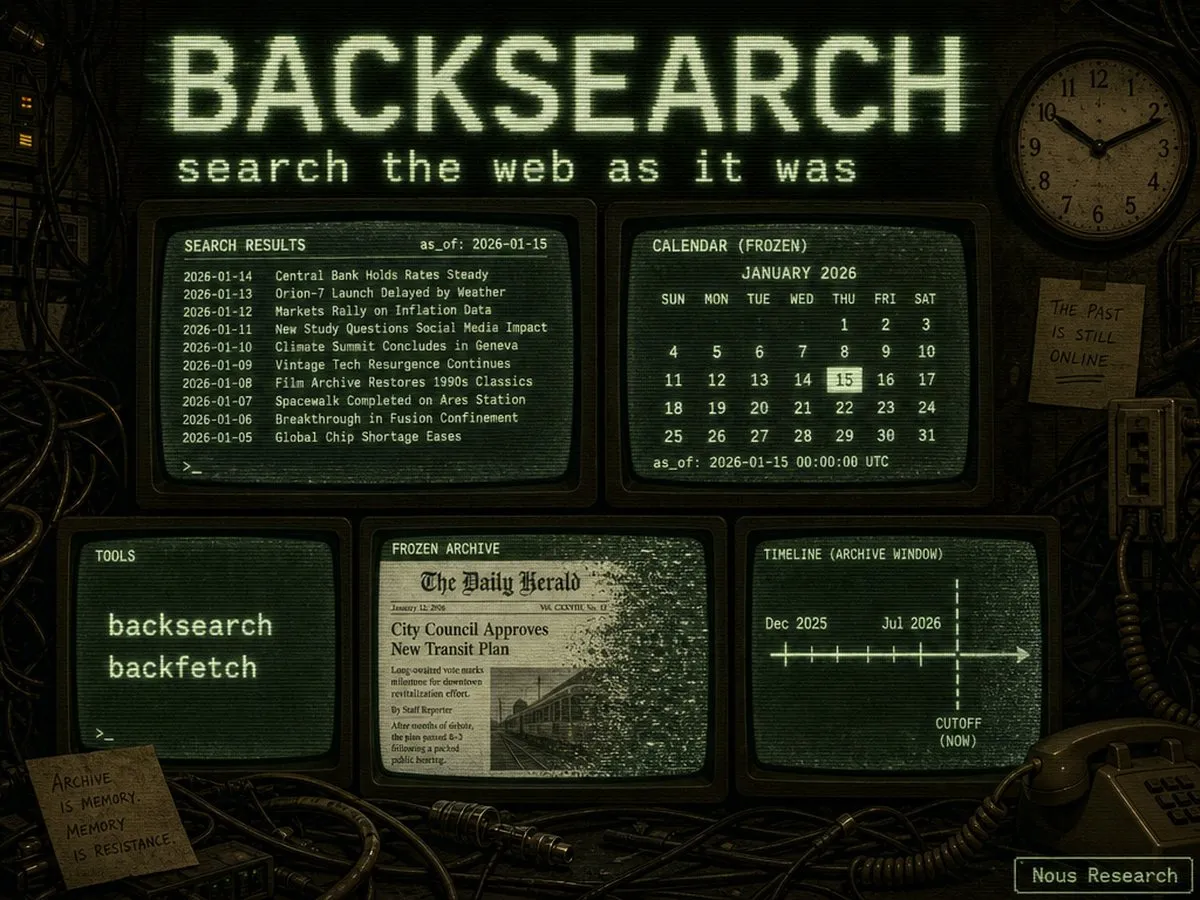
Offrez à Hermes une machine à remonter le temps : cherchez le web tel qu'il était avec BackSearch
Vous demandez à un LLM de prédire les gros titres du mois prochain… et il a discrètement lu ceux d'aujourd'hui : la prédiction est contaminée par de l'information a posteriori. BackSearch (de General Reasoning) fige les archives de presse : chaque requête porte une date as_of, la recherche ne renvoie que des documents crawls à cette date ou avant, et même requête + même date = toujours les mêmes résultats. Le plugin officiel autonome hermes-plugin-backsearch (v1.0.0, annoncé le 29 août) ajoute à Hermes deux outils — backsearch et backfetch — activés par OPENREWARD_API_KEY, avec une empreinte nulle sans clé. Cet article couvre le concept, l'installation, la référence des paramètres et les cas d'usage pour des backtests de prédiction sans fuite.
Lire la suite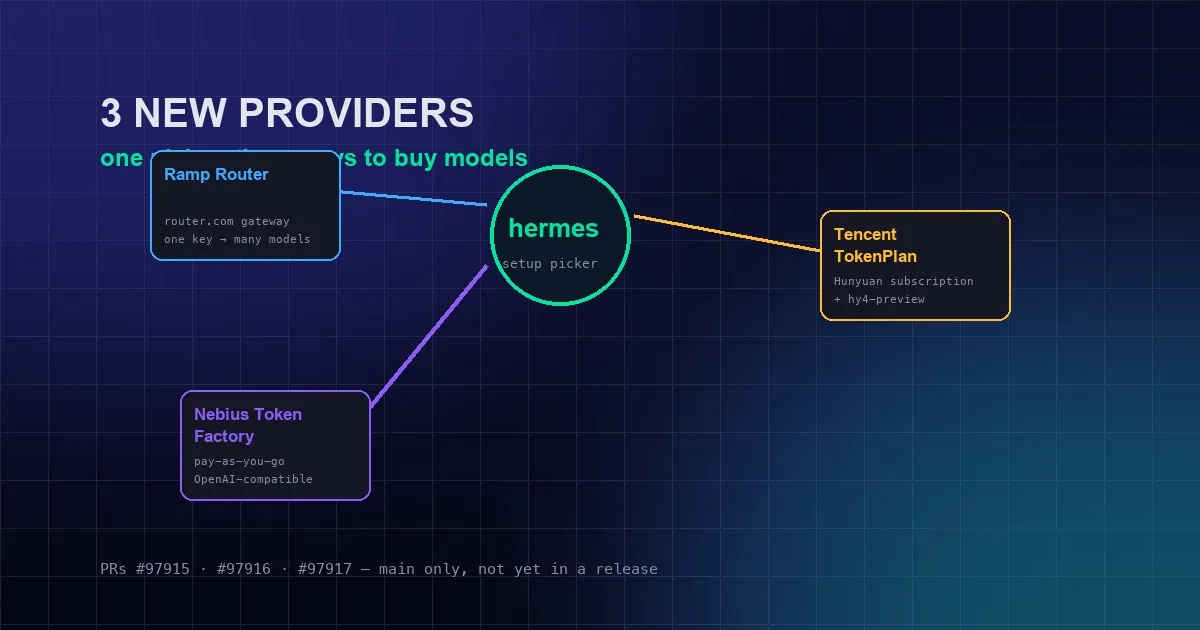
Trois nouveaux fournisseurs de modèles : Ramp Router, Nebius Token Factory et Tencent TokenPlan
Le 29 août, Hermes a fusionné trois nouveaux fournisseurs de modèles : Ramp Router (router.com) — un endpoint unique compatible OpenAI Responses qui route vers de nombreux upstreams avec fallbacks côté serveur et contrôles de dépenses ; Nebius Token Factory — l'inférence pay-as-you-go de Nebius ; et Tencent TokenPlan — l'abonnement token-plan de Tencent Cloud Hunyuan sur un endpoint compatible Anthropic, qui amène aussi le modèle hy4-preview dans le catalogue officiel. Les PR #97915/#97916/#97917 sont sur main, pas encore dans une release.
Lire la suite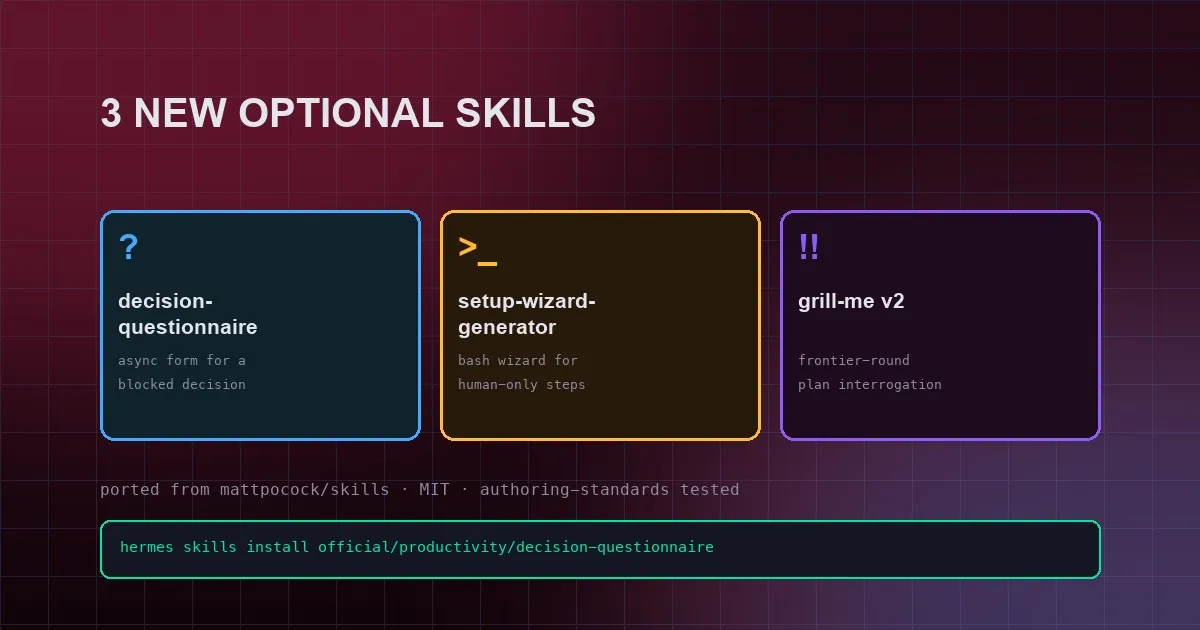
Trois nouvelles compétences optionnelles officielles : questionnaires, assistants de configuration et interrogatoire de plan
Le 29 août, Hermes a lancé d'un coup trois nouvelles compétences optionnelles : decision-questionnaire transforme une décision que seule une personne peut prendre en questionnaire asynchrone, setup-wizard-generator produit des assistants bash interactifs pour les étapes de configuration réservées aux humains, et grill-me v2.0.0 passe à des entretiens en rounds frontière qui passent au crible chaque hypothèse non examinée de votre plan. Les trois sont des ports natifs Hermes du dépôt mattpocock/skills (240k étoiles), installables avec une seule commande hermes skills install.
Lire la suite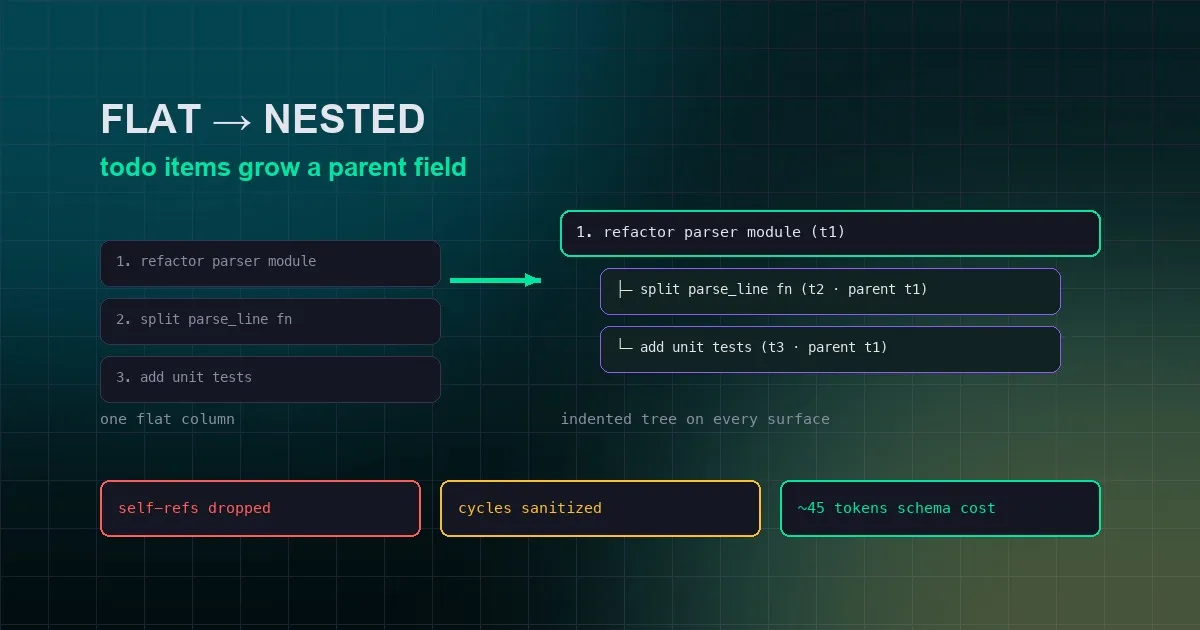
Les listes de tâches peuvent désormais s'imbriquer : le todo de Hermes gagne les sous-tâches
Lorsque vous confiez un travail complexe à Hermes, il tient une liste de tâches (todo) dans la session pour suivre sa propre progression. Cette liste était plate : « préparer la release » et « s'assurer que les tests passent » ne pouvaient que se côtoyer. La PR #97921 (fusionnée le 29 août) ajoute un champ parent aux éléments todo : les tâches peuvent s'imbriquer en arborescences, les surfaces affichent automatiquement l'indentation, et toute la fonctionnalité ne coûte qu'environ 45 tokens sur le schéma d'outil mis en cache.
Lire la suite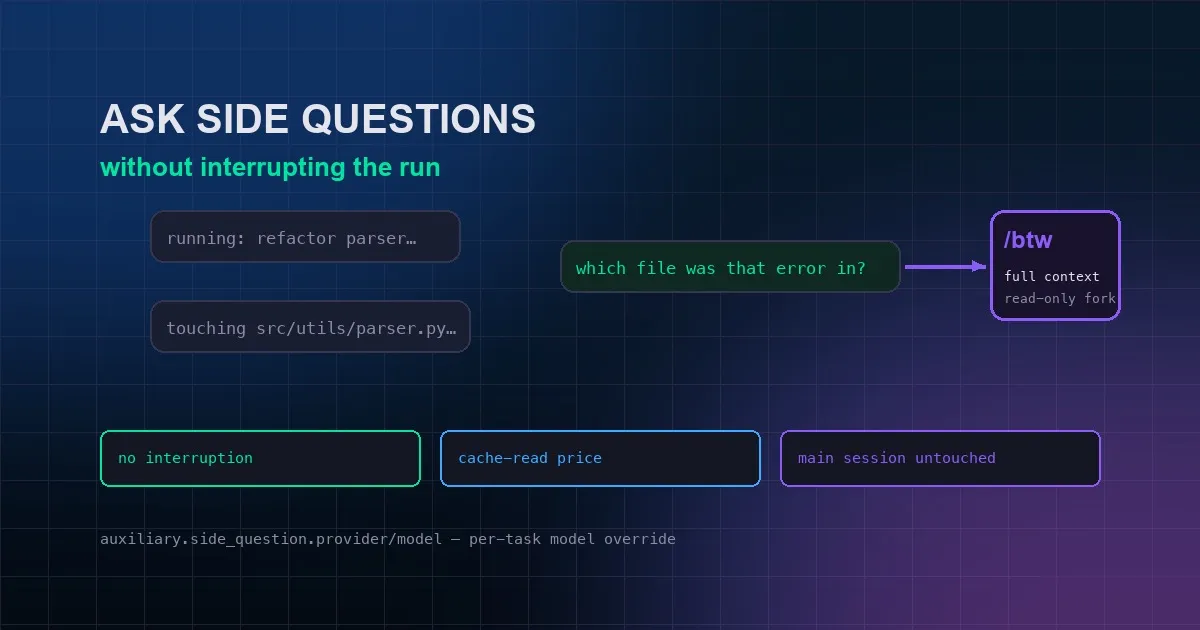
Besoin de poser une question en pleine tâche ? /btw y répond immédiatement, sans interrompre
Avant, quand une question surgissait en plein travail, vous n'aviez que deux mauvaises options : interrompre l'agent, ou ouvrir une nouvelle session qui ignore tout de la conversation. Les PR #97937/#97974 (fusionnées le 29 août) font de /btw une véritable commande de question annexe : elle répond depuis la conversation en cours, avec tout le contexte, au prix de lecture du cache — sans interruption, sans pollution, sans dépense supplémentaire. /background prend sa retraite dans la même modification ; /bg devient la commande canonique des tâches en arrière-plan.
Lire la suite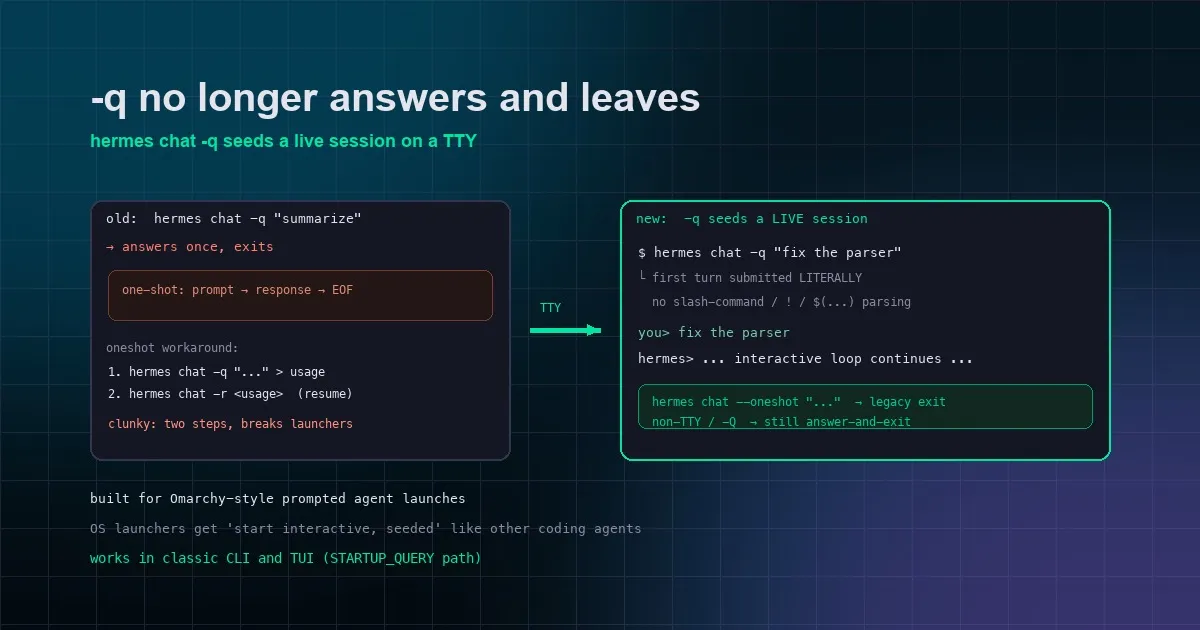
Une seule commande ouvre toute une session : hermes chat -q reste désormais interactif sur un TTY
hermes chat -q "question" répondait une fois puis sortait ; obtenir une session interactive imposait de l'exécuter, de sauvegarder le fichier de session, puis de la reprendre — une manœuvre en deux temps bien peu pratique. Le changement fusionné le 28 août (PR #97121) fait de -q le point de départ d'une session interactive vivante sur un vrai TTY, le premier message étant soumis littéralement — jamais interprété comme une commande slash ni comme une séquence d'échappement shell.
Lire la suite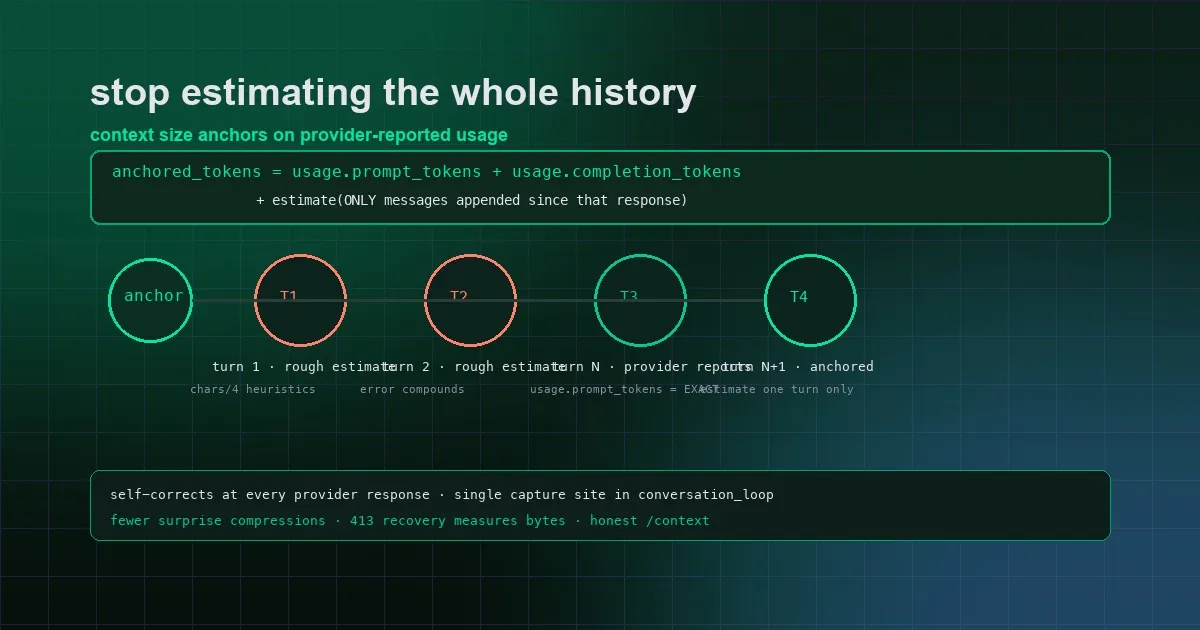
Hermes cesse de deviner la taille de votre contexte : l'ancrage sur l'usage aligne les seuils de compression sur les chiffres réels
Hermes réestimait auparavant à chaque tour le nombre de tokens de toute la conversation avec des heuristiques (chars/4, images à 1 500 tokens fixes), une erreur qui se cumulait à mesure que l'historique grandissait — d'où des compressions surprises et des erreurs 413 payload-too-large. Le changement fusionné le 28 août (PR #97206) ancre le comptage du contexte sur l'usage rapporté par le provider, réduisant la fenêtre d'estimation de l'intégralité du transcript à un seul tour.
Lire la suite