Une réponse en chinois devenue titre de session : le garde-fou de longueur ne compte que les espaces
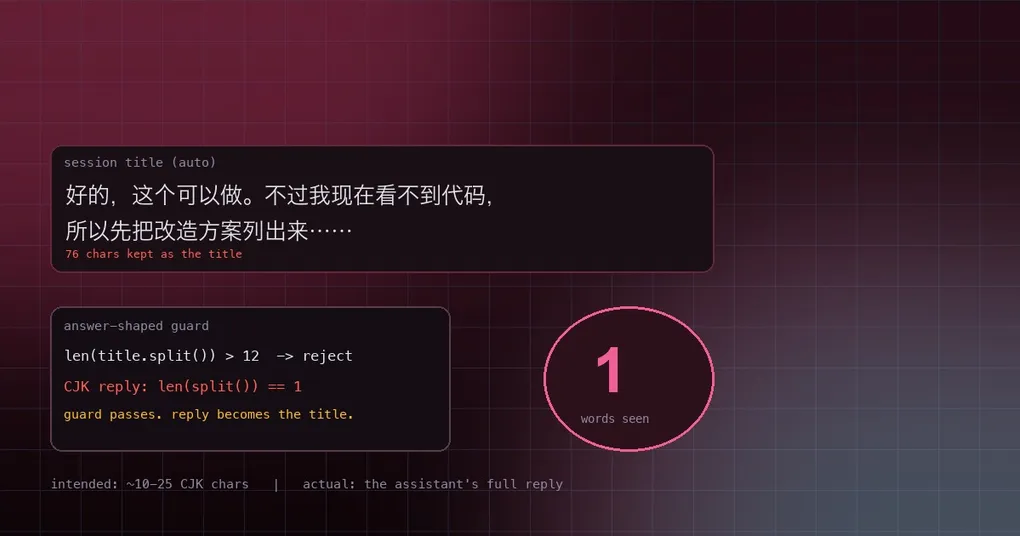
Vous changez de modèle, lancez quelques nouvelles sessions, et cherchez plus tard celle où vous avez parlé du plan de déploiement. La barre latérale affiche une phrase entière : 好的,这个可以做。不过我现在看不到代码,所以先把改造方案列出来…. Ce n’est pas un titre, c’est la réponse du modèle. Et chaque nouvelle session ressemble à ça, étirant la liste sur toute la hauteur de l’écran.
Ce n’est pas juste un modèle bavard. Le modèle a bien ignoré la consigne de renvoyer un titre court, mais Hermes possède un garde-fou fait exactement pour cette défaillance — simplement, il ne sait pas compter le chinois. Le problème a été signalé le 20 octobre 2026 (issue #141969). Voici le mécanisme, les preuves, et trois contournements qui fonctionnent dès aujourd’hui.
Comment naît un titre
Les titres sont générés en deux étapes. D’abord un titre instantané, dérivé localement de votre message d’ouverture, sans appel à un modèle. Ensuite une mise à niveau par le modèle : un appel en arrière-plan reçoit un aperçu de la conversation et doit renvoyer un titre court dans un champ JSON.
L’étape deux se comporte normalement. Mais les modèles bavards ignorent parfois le format et répondent à l’utilisateur, renvoyant toute une réponse comme contenu du champ. C’est ce que le code appelle une sortie en forme de réponse.
L’angle mort : len(title.split())
Pour rattraper cela, agent/title_generator.py applique un plafond simple :
_MAX_TITLE_WORDS = 12
...
# Garde-fou contre les sorties en forme de réponse : un titre avec beaucoup de mots
# signale un modèle qui a ignoré la tâche et répondu au message de l'utilisateur.
if title is not None and len(title.split()) > _MAX_TITLE_WORDS:
    return None
La logique est raisonnable : un vrai titre ne dépasse pas douze mots, alors qu’une réponse va bien au-delà. Le problème est str.split(), qui découpe sur les espaces. L’anglais, l’allemand et le français sont délimités par des mots et se comportent bien ; le chinois, le japonais et le coréen non, si bien qu’une phrase entière se tokenise en un, trois, peut-être huit « mots ».
Les mesures du ticket viennent directement d’un vrai state.db :
| Ce qui a été stocké comme titre | caractères | len(split()) |
garde-fou de 12 mots |
|---|---|---|---|
好的,这个可以做。不过我现在看不到 hermesbubble 的代码… |
76 | 3 | passe |
可以,直接在这说。先判断一个关键点:登录页本身能打开吗? |
32 | 1 | passe |
先确认一下:你说的 Hermes 是哪个项目/镜像? |
80 | 8 | passe |
我是 ChatGPT,由 OpenAI 开发。当前对话里没有提供… |
73 | 4 | passe |
Sur la même machine, les sessions plus anciennes créées avant le changement de provider avaient toutes des titres corrects de 17 à 24 caractères. Autrement dit : dans les langues délimitées par des espaces, le garde-fou fonctionne ; en chinois, il n’existe pour ainsi dire pas. C’est même pire qu’inutile sur un point — la réponse acceptée est persistée avec title_source='llm', impossible à distinguer d’un vrai titre, sauf que vous, vous vous souvenez de ce qu’elle était.
La piste proposée
Le ticket propose de rendre le garde-fou dépendant du système d’écriture : garder le compte de mots pour le texte délimité par des espaces, et ajouter un plafond de caractères pour les séquences CJK. Un titre fait typiquement 10 à 25 caractères chinois alors qu’une réponse dépasse 40, donc 30 laisse de la place à un titre à plusieurs propositions :
_MAX_TITLE_WORDS = 12
# Le CJK n'a pas d'espaces, donc len(split()) sous-compte gravement. Un titre reste
# court en caractères aussi ; une réponse non. ~30 laisse de la place à un vrai titre
# à plusieurs propositions.
_MAX_TITLE_CJK_CHARS = 30

def _cjk_char_count(text: str) -> int:
    return sum(1 for ch in text if
               "\u4e00" <= ch <= "\u9fff"      # idéogrammes unifiés CJK
               or "\u3040" <= ch <= "\u30ff"   # hiragana/katakana
               or "\uac00" <= ch <= "\ud7a3")  # hangul
Pour être clair sur le statut : à l’heure où ces lignes sont écrites, ce ticket est toujours ouvert et aucun patch n’a été mergé. Ce qui suit sont donc des contournements utilisables dès maintenant, pas une note de version.
Trois choses à faire dès maintenant
Un : renommer la session. hermes sessions rename prend un id de session et le nouveau titre :
hermes sessions rename 8f3c1d2a "deploy plan discussion"Pour l’historique qui a déjà hérité d’une phrase comme titre, cela les corrige un par un. Les ids de session viennent de hermes sessions list, et un préfixe suffit.
Deux : garder le titre instantané et couper la mise à niveau par le modèle. Le titre instantané est dérivé de votre propre message, il est donc court par construction. Désactivez l’appel au modèle en arrière-plan :
hermes config set auxiliary.title_generation.model_upgrade_enabled falseLe compromis, ce sont des titres plus ternes — ils reflètent votre première phrase au lieu de résumer la conversation.
Trois : désactiver complètement les titres automatiques. Si de toute façon vous nommez vos sessions vous-même :
hermes config set auxiliary.title_generation.enabled falseLes nouvelles sessions n’obtiennent alors aucun titre automatique et vous les renommez vous-même. Notez que auxiliary.title_generation.language contrôle la langue du titre (vide signifie « suivre la conversation ») — cela ne corrige pas la longueur, donc n’attendez pas de ce réglage qu’il contourne ce bug.
La leçon générale
« Estimer une longueur en comptant les mots » est un réflexe dans une base de code monolingue, et silencieusement faux dans un produit multilingue : aucune erreur, aucun avertissement, juste un contrôle qui passe discrètement pour certains systèmes d’écriture. Tout garde-fou qui estime une longueur ou une complexité en découpant sur les espaces devrait se demander ce qui se passe quand la langue n’a pas d’espaces.
Quelques domaines voisins valent le détour si vous travaillez en chinois ou dans une autre langue CJK : les frontières et l’archivage des sessions sont traités dans le guide des frontières de session ; export, rename et --resume sont documentés dans la référence hermes sessions ; et si la langue de votre interface diffère de celle du modèle, le guide des packs de langue explique quelles surfaces suivent le réglage.
En bref
Un titre de session est devenu une réponse entière parce que le garde-fou de longueur compte les mots avec split(), aveugle au texte CJK : 76 caractères chinois comptent pour trois mots, donc un plafond de douze mots ne se déclenche jamais. À court terme, renommez les sessions avec hermes sessions rename ou désactivez auxiliary.title_generation.model_upgrade_enabled pour conserver le titre instantané ; le vrai correctif est un garde-fou conscient du système d’écriture, et il n’est pas encore mergé.