La capture d'écran est juste là, mais Hermes dit que le fichier manque : il y a un espace invisible dans le nom
Vous déposez une capture d’écran fraîche dans le chat et demandez à Hermes de regarder l’erreur affichée. Le fichier s’enregistre bien, le path s’affiche bien, puis l’étape qui ouvre l’image échoue : media file not found. Vous vérifiez dans le Finder. Le fichier est là, avec exactement ce nom.
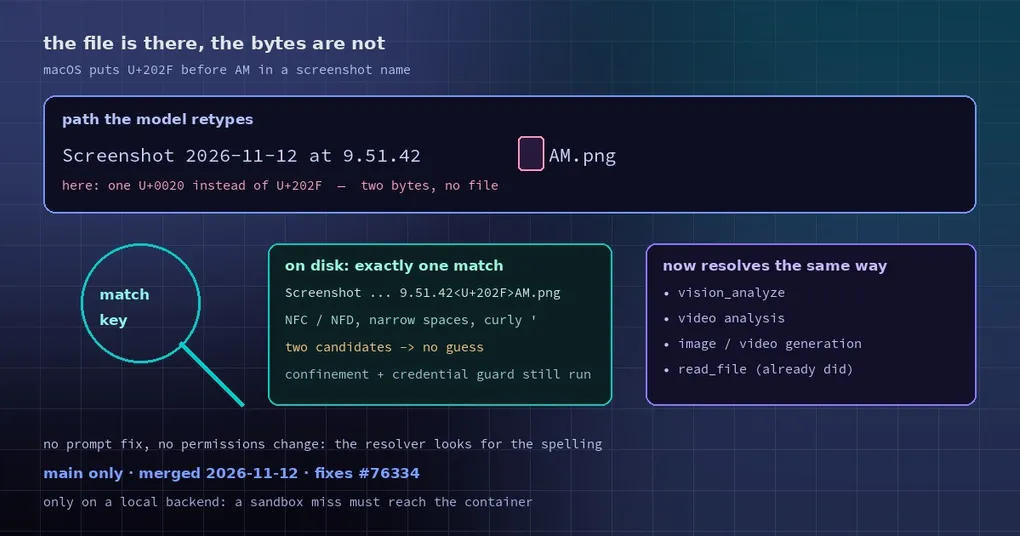
Le piège est dans « exactement ce nom ». Quand macOS nomme une capture d’écran, l’espace avant AM/PM n’est pas une espace normale. C’est U+202F, une espace fine insécable. À l’écran, elle est identique à une espace ordinaire — un cheveu plus étroite, invisible au premier regard. Quand un modèle retape le nom, il émet U+0020, et deux octets différents signifient que le path pointe vers un fichier qui n’existe pas.
La PR #154046, fusionnée le 12 novembre, fait en sorte que l’analyse d’images, l’analyse vidéo et la génération d’images ou de vidéos retrouvent elles-mêmes l’orthographe du disque.
Un caractère, toute une chaîne cassée
La défaillance se déroule ainsi :
- Le path arrive dans le contexte :
Screenshot 2026-11-12 at 9.51.42 AM.png— le caractère 26 est U+202F. - Le modèle reçoit une chaîne qui paraît normale, mais quand il génère du texte, les espaces qu’il produit sont toutes U+0020.
- La visionneuse appelle
open()sur ce path, l’OS compare les octets et ne trouve rien. - L’erreur dit
media file not found. Elle ne dit pas « un argument diffère d’un octet ».
Le pire est la façon dont cela se lit : on croit à un problème de permissions ou de path, donc on part auditer paths, permissions et sandboxes alors que la vraie cause est un caractère qu’on ne peut pas voir.
Petit détail qui rendait la chose incohérente : read_file gérait déjà ce cas. Le même fichier était donc lisible par read_file et illisible par vision_analyze.
Le correctif : matcher sur ce que l’œil voit, mais seulement quand un seul fichier correspond
Cela fonctionne en deux couches.
Une clé de matching. tools/file_operations_common.py gagne filename_match_key, qui normalise un nom vers « ce qu’un humain lit comme identique » : compositions Unicode NFC et NFD, espaces fines et spéciales, apostrophes typographiques.
Une recherche sur le disque. _on_disk_spelling dans tools/image_source.py s’exécute après un échec de path et cherche dans le même répertoire le fichier dont le nom ne diffère qu’invisiblement :
target (normalised):  screenshot 2026-11-12 at 9.51.42 am.png
actually on disk:     Screenshot 2026-11-12 at 9.51.42<U+202F>AM.png   <- match
Deux détails méritent d’être gardés en tête :
- Un seul candidat. Si un répertoire contient à la fois
a AM.pngeta<U+202F>AM.png, il ne devine pas — lire la mauvaise image est pire qu’échouer. - La sécurité s’applique toujours. Le path résolu passe par le même confinement au répertoire media et le même garde-fou de lecture de credentials, donc la correction ne contourne aucune frontière. Elle ne s’exécute de plus que sur un backend local (
TERMINAL_ENV=local) ; sous un sandbox, un échec doit encore atteindre la lecture dans le conteneur, sinon la frontière du sandbox céderait.
Quels outils en profitent désormais
Un seul résolveur pour « l’orthographe sur le disque » est partagé par ces points d’appel :
| Outil | Avant | Après |
|---|---|---|
vision_analyze (regarder une image) |
media file not found |
trouve le fichier, analyse normalement |
| Analyse vidéo | le même échec | le trouve aussi (_materialize_video renvoie le path U+202F) |
| Génération d’images ou de vidéos avec un fichier de référence local | échouait purement et simplement | _confine_source_images réécrit image_url et les références vers l’orthographe du disque, en laissant tranquilles les URLs et les fichiers réellement absents |
read_file |
le gérait déjà | inchangé |
La ligne la plus claire du compte rendu de vérification : pour la même capture, la ligne d’outil de l’ancienne branche affiche "success": false … media file not found, celle de la nouvelle affiche "success": true, et le modèle répond ensuite correctement sur la couleur de l’image. Un nouveau fichier de test, tests/tools/test_image_source_unicode_space.py, échoue sur l’ancienne branche avec SourceNotFound.
Ce que vous pouvez faire de votre côté
Le correctif fait que Hermes s’en sort seul, mais vous pouvez aussi contourner le problème :
- Renommez le fichier.
shot-1.pnget aucun caractère invisible ne pourra jamais entrer dans le nom. À faire dans tout script par lots. - Pour voir si des caractères cachés sont présents :
ls -béchappe les caractères invisibles, ou affichezrepr(path)en Python — U+202F apparaît immédiatement. - Préférez le glisser-déposer. Laisser l’outil prendre le path lui-même (glisser, upload de pièce jointe) vaut mieux qu’un modèle qui retape un nom de fichier long.
Cela n’a jamais concerné qu’un seul caractère. Les noms de fichiers NFD (courants sur macOS pour les noms accentués) et les apostrophes typographiques provoquaient la même classe d’échec, et la même clé de matching les couvre maintenant.
Si les erreurs d’image reviennent, deux lectures liées : le budget de contexte de la vision pour ce qui se passe après la réduction d’une grande image, et les photos HEIC d’un iPhone. Deux autres chemins qui évitent totalement « le modèle retape un path » : coller des images dans le terminal et la commande d’image du presse-papiers.
Statut de la release
La PR #154046 a été fusionnée dans main le 12 novembre 2026. Elle corrige l’issue #76334 et cherry-pick la #62126 plus ancienne en conservant l’attribution. v0.23.1 est sortie le 10 novembre et ne l’inclut pas. Deux issues liées, #76376 et #124742, couvraient des cas qui se recoupent (sans être identiques) — guidage côté prompt, NFD et apostrophes typographiques — et cette clé de matching les absorbe tous.
Mise à jour (17/11/2026) : ces changements sont sortis dans la v0.23.2 (16 novembre) : un
hermes updateles récupère. Le « pas dans la v0.23.1 » ci-dessus est un instantané du jour de publication.