Vous avez testé un job une fois, et le rappel n'est jamais arrivé : un lancement manuel de cron compte désormais en plus
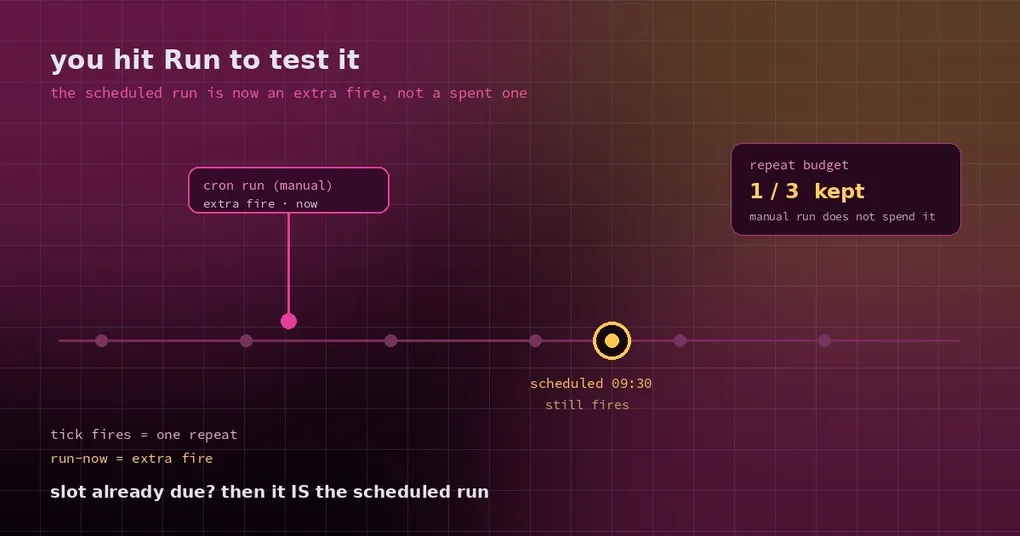
Vous programmez un rappel dans 30 minutes — sortir la poêle du feu — et vous voulez être sûr que ça fonctionne vraiment. Vous cliquez donc sur Run dans le dashboard. Ça part immédiatement, la sortie a l’air correcte, vous fermez l’onglet. Une demi-heure plus tard, la cuisine sent le métal brûlé : le rappel n’est jamais arrivé.
Le scheduler n’était pas cassé. Votre test a consommé l’unique créneau du one-shot. Le job s’est considéré terminé et s’est retiré sans bruit.
Un lancement manuel comptait autrefois comme le lancement
Deux champs d’un enregistrement cron sont faciles à confondre : quand il doit se déclencher ensuite (next_run_at), et quelle part du budget est consommée (repeat.completed sur repeat.times). Un one-shot n’est rien d’autre qu’un job doté d’un budget de un.
L’ancien code traitait un déclenchement manuel comme une exécution normale : il s’exécutait, puis écrivait la comptabilité — repeat.completed incrémenté. Pour un one-shot, cela faisait 1 sur 1, donc l’enregistrement était estampillé completed, enabled=false, next_run_at=null. C’est un état terminal. Le vrai lancement planifié n’a jamais eu sa chance. Les jobs récurrents perdaient des lancements de la même façon : repeat.times=3 vous en laissait deux après un seul test manuel.
La nouvelle règle : un lancement manuel est un déclenchement en plus
Le comportement est désormais littéral — un run-now ne consomme pas l’occurrence planifiée et ne touche pas au budget. Relus depuis jobs.json, les deux mêmes jobs ressemblent à ceci :
| Job | Avant (après un lancement manuel) | Maintenant |
|---|---|---|
Rappel one-shot in 30m |
completed, enabled=false, next_run_at=null, budget 1/1 — le lancement planifié ne part jamais |
scheduled, enabled=true, next_run_at toujours à l’heure d’origine, budget 0/1 |
every 60m, repeat.times=3 |
budget enregistré à 1/3, next_run_at repoussé à « maintenant » |
budget 0/3, next_run_at inchangé |
Un lancement manuel, c’est des heures supplémentaires : une équipe en plus, tandis que l’équipe planifiée se présente quand même et que le budget reste intact.
Le seul cas où c’est vraiment le lancement planifié
Si le créneau du job est déjà échu au moment où vous cliquez sur Run, ce lancement est l’occurrence planifiée — vous n’obtenez pas deux exécutions. Les règles en pratique :
- déclencher avant l’échéance du créneau → déclenchement en plus, le créneau survit ;
- déclencher une fois l’échéance passée → c’est le lancement planifié, pas de doublon ;
- le créneau échoit pendant que votre lancement manuel tourne encore → un one-shot part immédiatement après, tandis qu’un job récurrent abandonne le créneau dépassé et prend son occurrence naturelle suivante, exactement comme le ferait un lancement planifié.
Comment l’utiliser
# déclencher une fois maintenant ; le prochain lancement planifié est conservé
hermes cron run <job_id>

# inspecter les jobs : next_run_at et les compteurs de répétition vivent ici
hermes cron list

# créer un one-shot
hermes cron create "in 30m" "Take the pan off the heat before you keep coding"
Le bouton Run du dashboard, un agent qui appelle l’outil cronjob_manage, et un lancement relayé par le gateway passent tous par le même chemin : pas de fracture entre « sûr en CLI, destructeur dans l’UI ».
Pourquoi c’est plus difficile qu’il n’y paraît
La difficulté, c’est un crash entre la décision et l’enregistrement. La réservation a lieu une seule fois, sous le verrou des jobs : quand le déclenchement est un run-now explicite alors que le créneau stocké est encore dans le futur, la réservation estampille ce créneau sur l’enregistrement du déclenchement et remet next_run_at dans la même écriture. Si le processus meurt après la réservation mais avant la fin, le disque pointe toujours vers le bon instant futur : aucune occurrence n’est perdue.
Le chemin relayé par le gateway (trigger_job) écrasait autrefois next_run_at par « maintenant » sans en garder de copie ; il sauvegarde désormais le créneau écrasé et le restaure au moment de la réservation, donc des déclenchements répétés ne peuvent plus faire dériver le planning.
Le changement comble aussi un trou de visibilité : un one-shot dont le dispatch était réservé mais dont l’exécution ne s’est jamais terminée était supprimé sans sortie, sans erreur et sans trace. Il écrit maintenant un petit diagnostic dans le répertoire de sortie du job — dispatch réservé, exécution jamais terminée, processus très probablement tué — pour que la disparition soit au moins explicable.
Deux détails à connaître
- Une pause globale ne bloque pas les lancements manuels. Tant que
hermes pauseest actif, rien de planifié ne démarre, mais un run-now explicite est une décision d’opérateur et s’exécute quand même. C’est une raison de plus pour qu’il ne consomme pas le budget : rattraper à la main pendant une pause ne doit pas manger le vrai lancement d’après. - Un lancement manuel n’est pas un « passer au suivant ». Il n’avance pas
next_run_at. Pour sauter une occurrence, faitespause/resume, oueditle planning.
Pour un contrôle de toute la flotte, utilisez cron doctor. Les plannings multi-fuseaux sont traités dans le papier sur les fuseaux et l’heure d’été, et l’identité par profile ainsi que la portée des secrets dans l’isolation des secrets au déclenchement routé. La liste des options est sur la page de référence hermes cron.
Statut de la release
Mergé dans main le 28 octobre 2026 (PR #146113). La release courante, v0.22.5 (23 octobre 2026), a encore l’ancienne sémantique : sur un build plus ancien, un test peut donc toujours retirer un one-shot sur-le-champ.
Avant de faire confiance à un rappel, vous voulez la preuve qu’il sonnera encore. Cette prémisse est enfin vraie.