Claude Fable 5.2 et Mythos 5.2 dans Hermes : fast mode, une fenêtre de 1M et le trou de 200K entre les deux
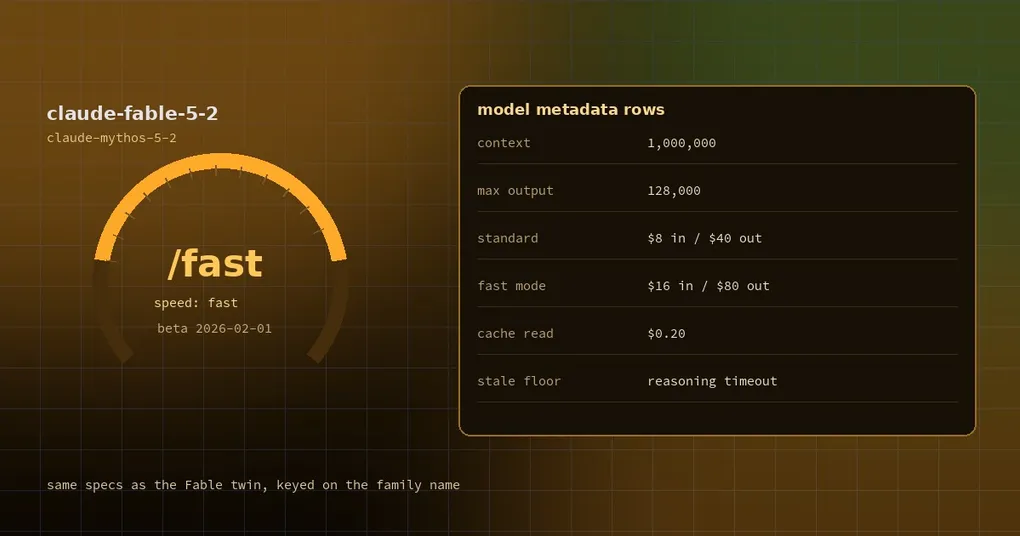
Votre refactoring du lundi se termine en moitié moins de temps que d’habitude, et vous vous en félicitez jusqu’à ce que le tableau de bord d’usage vous rattrape : le même travail, ligne pour ligne, a coûté le double. Ou l’inverse se produit : vous passez sur un modèle censé disposer d’une fenêtre d’un million de tokens, et la toute première requête sur un prompt de 200K qui passait auparavant revient comme si cette fenêtre n’avait jamais existé. Ces deux surprises viennent de la même petite famille de modèles, et toutes deux sont désormais des choix que vous faites exprès plutôt que des découvertes accidentelles.
Deux pull requests, à six heures d’intervalle
Claude Fable 5.2 arrive dans Hermes avec PR #152220, fusionnée le 2026-11-09 à 21:33 UTC. Environ six heures plus tard, PR #152393 est fusionnée avec trois changements pour Claude Mythos 5.2 : le fast mode activé, la fenêtre de contexte de 1M de tokens qu’il aurait toujours dû avoir, et le plancher de stale-timeout de raisonnement que Fable portait déjà.
Fable 5.2 est le modèle accessible au public. Mythos 5.2 est le jumeau à la fiche technique identique — 1 000 000 de tokens de contexte, jusqu’à 128K de sortie — réservé aux membres des programmes Cyber Verification et Life Sciences Verification d’Anthropic. Si la seconde PR vous semble être de la menue maintenance à côté du lancement d’un modèle, commencez par la section sur les 200K : cette menue maintenance coûtait discrètement du contexte réel aux utilisateurs de Mythos.
Le fast mode, sans jargon
Une requête en fast mode, c’est le même modèle à un autre niveau de service. Vous ajoutez speed: "fast" à côté du corps de requête habituel, et l’API Claude renvoie les tokens plus tôt. La PR embarque aussi l’en-tête bêta fast-mode-2026-02-01, tandis que la documentation de la plateforme Anthropic présente le paramètre comme généralement disponible. Rien ne change dans les poids, la fenêtre de contexte ou le cache de prompt. Ce qui change, c’est le prix par token, qui double.
Deux termes méritent d’être fixés avant les tableaux :
- Fenêtre de contexte — la quantité totale de texte (prompt système, fichiers, sortie d’outils, historique de conversation) que le modèle peut contenir dans une seule requête. Dépassez-la et la requête est rejetée, ou Hermes doit compacter l’historique : ce chiffre compte donc plus que n’importe quel score de benchmark.
- cache read — le tarif réduit que vous payez pour une entrée que l’API a déjà vue, typiquement le préfixe stable d’un prompt que vous renvoyez. Un cache write est le surcoût pour placer ce préfixe dans le cache, et la variante de cinq minutes expire vite.
Les deux réapparaissent dans la grille tarifaire du fast mode, ce qui surprend : vous ne conservez pas le tarif de cache bon marché en payant le tarif rapide pour la sortie. Tout est multiplié par le même facteur.
Identifiants de modèles, et qui peut vraiment y accéder
Les noms sont le point où ces deux modèles deviennent confus, parce que trois systèmes les écrivent de trois façons différentes.
| Où vous l’exécutez | Fable 5.2 | Mythos 5.2 |
|---|---|---|
| API Anthropic native | claude-fable-5-2 |
claude-mythos-5-2 |
| Bedrock | anthropic.claude-fable-5-2 |
— |
| OpenRouter | anthropic/claude-fable-5.2 |
— |
| Nous Portal | anthropic/claude-fable-5.2 |
non listé |
La forme avec barre oblique et point est la convention d’OpenRouter et de Nous Portal ; la forme avec tirets est celle qu’accepte l’API Anthropic native. Bedrock facture anthropic.claude-fable-5-2 aux mêmes tarifs standard que l’API directe.
Mythos 5.2 est la colonne intéressante. L’accès est réservé aux membres des programmes Cyber Verification et Life Sciences Verification d’Anthropic, et au moment où la seconde PR a été fusionnée, Nous Portal renvoyait 404 pour anthropic/claude-mythos-5.2 comme pour anthropic/claude-mythos-5-2, et l’identifiant était absent de la liste de modèles du Portal — 396 identifiants à ce moment-là. Autrement dit : si vous atteignez Claude via Nous Portal, la moitié fast mode de cette sortie ne vous concerne pas encore. Si vous utilisez l’API Anthropic native, elle vous concerne, et /fast est l’interrupteur.
Le trou de 200K
La régression de contexte n’était pas un bug du client API. C’était une clé manquante dans un dictionnaire.
Hermes tient une table de longueurs de contexte par défaut, utilisée chaque fois qu’un provider ne renvoie pas de chiffre en direct — un cache de métadonnées froid, un endpoint qui fait proxy, un provider qui ne remonte simplement pas la valeur. Les lignes concernées ressemblent à ceci :
DEFAULT_CONTEXT_LENGTHS = {
    # ...
    "claude-fable-5": 1000000,
    "claude-fable": 1000000,
    "claude-mythos": 1000000,
    "claude-opus-5": 1000000,
    "claude-sonnet-5": 1000000,
}
Regardez maintenant ce qui manque : claude-mythos-5-2. La table accroche la famille Fable sur le préfixe claude-fable, donc claude-fable-5-2 se résout et garde son million de tokens. Mythos partage la spécification — 1M de contexte, 128K de sortie — mais pas le préfixe, donc claude-mythos-5-2 retombait sur l’entrée générique claude à 200 000 tokens.
| Identifiant du modèle | Contexte utilisé sans lecture en direct, avant | Après |
|---|---|---|
claude-fable-5-2 |
1 000 000 | 1 000 000 |
claude-mythos-5-2 |
200 000 (repli générique claude) |
1 000 000 |
Le mode de défaillance est vicieux parce qu’il est silencieux. Quand le provider renvoie des métadonnées, rien ne va mal : la vraie limite arrive avec la réponse. Mais sur les chemins qui dépendent du repli, Mythos se comporte comme un modèle 200K, et une longue session dépassant 200K est compactée bien plus tôt qu’elle ne devrait l’être. Aucune erreur n’apparaît ; l’historique est simplement résumé plus tôt que nécessaire, ce qui se lit comme un modèle devenu bête du jour au lendemain.
PR #152393 ajoute l’entrée Mythos à cette table. La seconde moitié du correctif est plus subtile.
Le plancher de stale-timeout du raisonnement
Quand un modèle de raisonnement réfléchit avant de répondre, quelque chose doit décider combien de silence est acceptable. Si aucun token n’arrive dans la fenêtre stale, Hermes considère la requête comme bloquée et réessaie, et la tentative est jetée.
Les longues chaînes de pensée sont exactement le cas qui déclenche cela. Fable avait un plancher appliqué à ce budget de raisonnement — un temps de réflexion minimal accordé au modèle avant que sa requête puisse être jugée stale. Mythos n’avait pas ce plancher, donc sur un prompt vraiment difficile il pouvait être coupé avant même que son premier token n’arrive : pas de réponse, pas de sortie à facturer, et une nouvelle tentative qui repart de zéro. La même PR accorde le plancher à Mythos, à l’identique de Fable.
Voilà toute la sortie en une phrase : un modèle ajouté, un modèle aligné sur son jumeau.
Combien coûte le fast mode
Seul Fable 5.2 a des lignes publiées dans la grille tarifaire, et elles se lisent par paire, parce que la ligne fast mode n’est la remise de personne.
| Par million de tokens (USD) | Entrée | Sortie | cache read | cache write 5 minutes |
|---|---|---|---|---|
| Fable 5.2, standard | $8.00 | $40.00 | $0.20 | $10.00 |
| Fable 5.2, fast mode | $16.00 | $80.00 | $0.40 | $20.00 |
| Fable 5.2 sur Bedrock | $8.00 | $40.00 | $0.20 | $10.00 |
Faites le calcul avant de basculer l’interrupteur : le fast mode se rentabilise quand la latence réelle est le goulot d’étranglement — une boucle de code interactive, un agent qui attend des allers-retours d’outils. C’est un mauvais échange pour du traitement par lots, pour les tâches à contexte long dominées par des cache reads renvoyés, ou pour tout ce que vous allez lancer dix fois avant que ce soit juste. Doubler un cache read à $0.20, c’est de la petite monnaie ; doubler $80 de sortie, c’est une ligne sur laquelle quelqu’un vous posera des questions. Si vous accédez à Claude via un abonnement plutôt qu’une clé API, le guide des providers indique quel chemin est facturé sur quel quota, et cette analyse du comptage des abonnements Claude explique pourquoi un travail identique peut faire bouger votre utilisation de quantités très différentes.
L’activer
/fast est une commande slash qui existait déjà — c’est hermes_cli/cli_info_mixin.py qui la gère —, il n’y a donc rien de nouveau à installer. Ce que ces deux PR ont changé, c’est la liste que consulte cet interrupteur, et la liste que consulte le portail des requêtes Anthropic natives :
_ANTHROPIC_FAST_MODE_MODELS = frozenset({
    "claude-opus-4-8",
    "claude-opus-5",
    "claude-opus-5-5",
    "claude-fable-5-2",
    "claude-mythos-5-2",
})
Un modèle est éligible si son identifiant tombe dans cet ensemble après normalisation. Le contrôle accepte un préfixe de fournisseur (anthropic. ou anthropic/), les graphies pointées comme claude-mythos-5.2, et un suffixe de date à 8 chiffres comme -20260601, retiré avant la comparaison — ainsi claude-fable-5-2, anthropic/claude-fable-5.2 et anthropic.claude-mythos-5-2-20260601 se résolvent tous vers une entrée. Un identifiant distinct qui se termine seulement par -fast est autre chose et n’est pas dans cet ensemble.
Une précision, parce que le nom invite à l’erreur : le fast mode est un paramètre de requête sur le même identifiant de modèle, pas un second modèle. Il n’y a pas de déploiement ni d’endpoint Fable-fast séparé à configurer.
Ce que cela change pour vous
- Anthropic natif, Fable 5.2. Tout fonctionne aujourd’hui.
/fasts’active ; budget doublé par token, cache reads et cache writes compris. - Anthropic natif, Mythos 5.2. Suppose une adhésion à Cyber ou Life Sciences Verification. Une fois obtenue,
/fasts’applique, et votre fenêtre de contexte ne s’effondre plus à 200K quand les métadonnées manquent. - Nous Portal ou OpenRouter. Fable 5.2 est disponible sous l’identifiant pointé au tarif standard. Mythos 5.2 n’est pas listé, donc les changements de fast mode et de contexte de la seconde PR restent théoriques pour vous.
- Tous ceux qui font de longues sessions sur Mythos. Le plancher de stale-timeout est le correctif dont vous ignoriez avoir besoin — les longs tours de raisonnement cessent de mourir avant le premier token.
Si vous débutez côté CLI, la référence des commandes couvre les autres commandes slash que vous taperez dans une session, et le guide du catalogue de plugins est l’endroit à consulter si vous voulez automatiser tout cela plutôt que le taper à chaque session.
Le schéma est le même dans les deux PR, et il revient chaque fois qu’une famille de modèles s’élargit : le modèle lui-même est une pull request, et le faire se comporter comme ses frères en est une autre. Surveillez la seconde. Une fenêtre de contexte erronée et un plancher stale manquant ne s’annoncent pas ; ils font juste passer un bon modèle pour un modèle médiocre.