Claude Fable 5.2 und Mythos 5.2 in Hermes: fast mode, ein 1M-Fenster und das 200K-Loch dazwischen
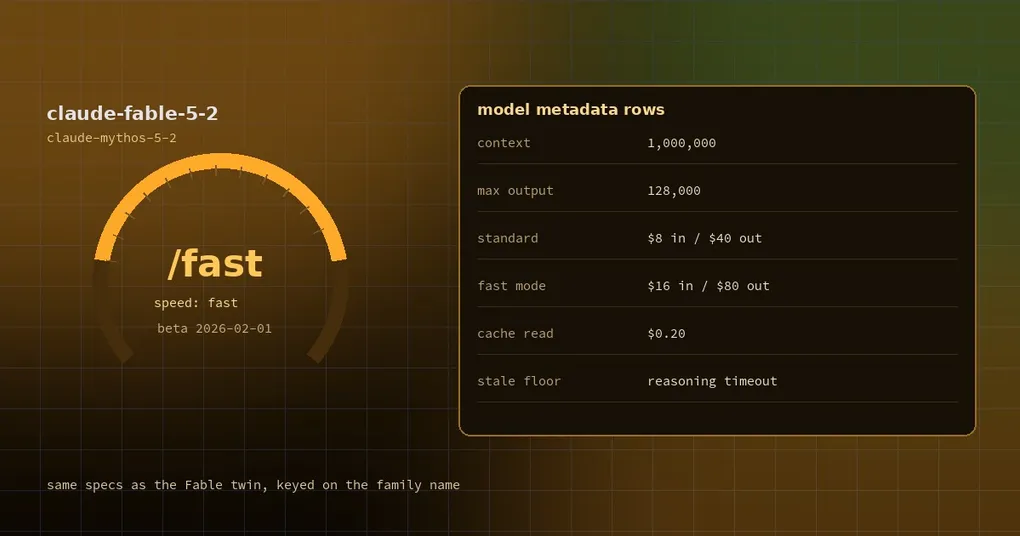
Dein Refactoring am Montag ist in der halben üblichen Zeit durch und du fühlst dich gut dabei – bis das Usage-Dashboard hinterherkommt: dieselbe Arbeit, Zeile für Zeile, doppelt so teuer. Oder das Gegenteil passiert: Du wechselst auf ein Modell, von dem es hieß, es habe ein Fenster von einer Million Tokens, und die allererste Anfrage mit einem 200K-Prompt, der bisher passte, kommt zurück, als hätte es dieses Fenster nie gegeben. Beide Überraschungen kommen aus derselben kleinen Modellfamilie, und beide sind jetzt Dinge, die du bewusst wählst, statt sie zufällig zu entdecken.
Zwei Pull Requests, sechs Stunden Abstand
Claude Fable 5.2 kommt mit PR #152220 nach Hermes, gemergt am 2026-11-09 um 21:33 UTC. Rund sechs Stunden später wird PR #152393 mit drei Änderungen für Claude Mythos 5.2 gemergt: fast mode eingeschaltet, das Kontextfenster von 1M Tokens, das es immer schon hätte haben sollen, und der stale-timeout-Unterwert fürs Reasoning, den Fable bereits mitbrachte.
Fable 5.2 ist das öffentlich verfügbare Modell. Mythos 5.2 ist der Zwilling mit identischem Datenblatt – 1.000.000 Tokens Kontext, bis zu 128K Ausgabe –, beschränkt auf Mitglieder der Programme Cyber Verification und Life Sciences Verification von Anthropic. Wenn dir der zweite PR neben einem Modellstart wie Aufräumarbeit vorkommt, fang beim 200K-Abschnitt an: genau diese Aufräumarbeit hat Mythos-Nutzern still und leise echten Kontext gekostet.
fast mode, ohne Jargon
Eine fast-mode-Anfrage ist dasselbe Modell auf einer anderen Service-Stufe. Du schickst speed: "fast" neben den normalen Request-Body, und die Claude API liefert Tokens früher. Der PR bringt außerdem den Beta-Header fast-mode-2026-02-01 mit, während Anthropics Plattform-Doku den Parameter als allgemein verfügbar führt. An den Gewichten, am Kontextfenster und am Prompt-Cache ändert sich nichts. Was sich ändert, ist der Preis pro Token – er verdoppelt sich.
Zwei Begriffe sollte man vor den Tabellen festzurren:
- Kontextfenster — die Gesamtmenge Text (System-Prompt, Dateien, Tool-Ausgaben, Gesprächsverlauf), die das Modell in einer einzigen Anfrage halten kann. Wird das überschritten, wird die Anfrage abgelehnt oder Hermes muss den Verlauf komprimieren – die Zahl ist also wichtiger als jeder Benchmark-Score.
- cache read — der rabattierte Satz für Input, den die API schon gesehen hat, typischerweise das stabile Präfix eines Prompts, den du erneut sendest. Ein cache write ist der Aufschlag dafür, dieses Präfix in den Cache zu legen, und die Fünf-Minuten-Variante läuft schnell ab.
Beide tauchen in der fast-mode-Preisliste wieder auf, was viele überrascht: Du behältst nicht den günstigen Cache-Satz und zahlst für die Ausgabe den schnellen Satz. Alles skaliert um denselben Faktor.
Modell-IDs und wer sie tatsächlich erreicht
Bei den Namen wird es verwirrend, weil drei Systeme sie drei verschieden schreiben.
| Wo du es laufen lässt | Fable 5.2 | Mythos 5.2 |
|---|---|---|
| Native Anthropic API | claude-fable-5-2 |
claude-mythos-5-2 |
| Bedrock | anthropic.claude-fable-5-2 |
— |
| OpenRouter | anthropic/claude-fable-5.2 |
— |
| Nous Portal | anthropic/claude-fable-5.2 |
nicht gelistet |
Die Form mit Schrägstrich und Punkt ist die Konvention von OpenRouter und Nous Portal; die Form mit Bindestrichen akzeptiert die native Anthropic API. Bedrock rechnet anthropic.claude-fable-5-2 zu denselben Standardsätzen ab wie die direkte API.
Mythos 5.2 ist die interessante Spalte. Der Zugang ist auf Mitglieder der Programme Cyber Verification und Life Sciences Verification von Anthropic beschränkt, und zum Zeitpunkt, an dem der zweite PR gemergt wurde, antwortete Nous Portal sowohl für anthropic/claude-mythos-5.2 als auch für anthropic/claude-mythos-5-2 mit 404, und die ID fehlte in der Modellliste des Portals – damals 396 IDs. Klartext: Wenn du Claude über Nous Portal erreichst, gilt die fast-mode-Hälfte dieses Releases für dich noch nicht. Wenn du die native Anthropic API nutzt, gilt sie, und /fast ist der Schalter.
Das 200K-Loch
Die Kontext-Regression war kein Bug im API-Client. Es war ein fehlender Schlüssel in einem Dictionary.
Hermes führt eine Tabelle mit Standard-Kontextlängen und nutzt sie immer dann, wenn ein provider keine Live-Zahl zurückgibt – ein kalter Metadaten-Cache, ein proxyender Endpoint, ein provider, der den Wert schlicht nicht meldet. Die relevanten Zeilen sehen so aus:
DEFAULT_CONTEXT_LENGTHS = {
    # ...
    "claude-fable-5": 1000000,
    "claude-fable": 1000000,
    "claude-mythos": 1000000,
    "claude-opus-5": 1000000,
    "claude-sonnet-5": 1000000,
}
Schau jetzt, was fehlt: claude-mythos-5-2. Die Tabelle hängt die Fable-Familie am Präfix claude-fable auf, also löst claude-fable-5-2 auf und behält seine Million Tokens. Mythos teilt die Spezifikation – 1M Kontext, 128K Ausgabe –, aber nicht das Präfix, also fiel claude-mythos-5-2 auf den generischen claude-Eintrag mit 200.000 Tokens durch.
| Modell-ID | Kontext ohne Live-Lookup, vorher | Nachher |
|---|---|---|
claude-fable-5-2 |
1.000.000 | 1.000.000 |
claude-mythos-5-2 |
200.000 (generischer claude-Fallback) |
1.000.000 |
Der Fehlermodus ist gemein, weil er leise ist. Wenn der provider Metadaten zurückgibt, geht nichts schief – das echte Limit kommt mit der Antwort. Auf den Pfaden, die auf den Fallback angewiesen sind, verhält sich Mythos aber wie ein 200K-Modell, und eine lange Session, die über 200K läuft, wird viel früher komprimiert als nötig. Es erscheint kein Fehler; der Verlauf wird nur früher zusammengefasst, und das liest sich, als wäre das Modell über Nacht dümmer geworden.
PR #152393 trägt den Mythos-Eintrag in diese Tabelle ein. Die zweite Hälfte der Korrektur ist subtiler.
Der stale-timeout-Unterwert fürs Reasoning
Wenn ein Reasoning-Modell vor der Antwort nachdenkt, muss irgendetwas entscheiden, wie viel Stille akzeptabel ist. Kommt innerhalb des stale-Fensters kein Token, behandelt Hermes die Anfrage als hängend und wiederholt sie, und der Versuch ist verloren.
Lange Gedankenketten sind genau der Fall, der das auslöst. Fable hatte einen Unterwert auf diesem Reasoning-Budget – eine Mindestdenkzeit, die einem Modell zugestanden wird, bevor seine Anfrage als stale gelten darf. Mythos hatte keinen solchen Unterwert, also konnte es bei einem wirklich harten Prompt abgeschnitten werden, bevor das erste Token überhaupt ankam: keine Antwort, keine Ausgabe zum Abrechnen und ein Retry, der bei null beginnt. Derselbe PR gibt Mythos den Unterwert, passend zu Fable.
Das ist das ganze Release in einem Satz: ein Modell hinzugefügt, ein Modell seinem Zwilling gleichgestellt.
Was fast mode kostet
Nur Fable 5.2 hat veröffentlichte Positionen in der Preistabelle, und die liest man am besten als Paar, denn die fast-mode-Zeile ist niemandes Rabatt.
| Pro Million Tokens (USD) | Input | Output | cache read | cache write (5 Minuten) |
|---|---|---|---|---|
| Fable 5.2, Standard | $8.00 | $40.00 | $0.20 | $10.00 |
| Fable 5.2, fast mode | $16.00 | $80.00 | $0.40 | $20.00 |
| Fable 5.2 auf Bedrock | $8.00 | $40.00 | $0.20 | $10.00 |
Rechne, bevor du den Schalter umlegst: fast mode rechnet sich, wenn die Wall-Clock-Latenz der Engpass ist – eine interaktive Coding-Schleife, ein Agent, der auf Tool-Roundtrips wartet. Für Batch-Arbeit ist es ein schlechter Tausch, für Long-Context-Jobs, die von erneut gesendeten cache reads dominiert werden, und für alles, was du zehnmal laufen lässt, bis es stimmt. Ein cache read von $0.20 zu verdoppeln ist Kleingeld; $80 Ausgabe zu verdoppeln ist eine Position, nach der jemand fragen wird. Wenn du Claude über ein Abo statt über einen API-Key erreichst, erklärt der Provider-Leitfaden, welcher Pfad gegen welches Kontingent abgerechnet wird, und diese Aufschlüsselung der Abo-Messung bei Claude zeigt, warum identische Arbeit deine Auslastung sehr unterschiedlich bewegen kann.
Einschalten
/fast ist ein bestehender Slash-Befehl – hermes_cli/cli_info_mixin.py behandelt ihn –, es gibt also nichts Neues zu installieren. Was diese beiden PRs geändert haben, ist die Liste, die dieser Schalter konsultiert, und die Liste, die das Gate für native Anthropic-Anfragen konsultiert:
_ANTHROPIC_FAST_MODE_MODELS = frozenset({
    "claude-opus-4-8",
    "claude-opus-5",
    "claude-opus-5-5",
    "claude-fable-5-2",
    "claude-mythos-5-2",
})
Ein Modell qualifiziert sich, wenn seine ID nach der Normalisierung in dieser Menge landet. Die Prüfung akzeptiert ein Vendor-Präfix (anthropic. oder anthropic/), punktierte Schreibweisen wie claude-mythos-5.2 und ein achtstelliges Datums-Suffix wie -20260601, das vor dem Vergleich entfernt wird – also lösen claude-fable-5-2, anthropic/claude-fable-5.2 und anthropic.claude-mythos-5-2-20260601 alle auf einen Eintrag auf. Eine separate Modell-ID, die bloß auf -fast endet, ist etwas anderes und nicht in dieser Menge.
Eine Klarstellung, weil der Name den Fehler einlädt: fast mode ist ein Request-Parameter auf derselben Modell-ID, kein zweites Modell. Es gibt kein separates Fable-fast-Deployment und keinen eigenen Endpoint zum Konfigurieren.
Was sich für dich ändert
- Native Anthropic, Fable 5.2. Funktioniert heute.
/fastgreift; Budget doppelt pro Token, inklusive cache reads und writes. - Native Anthropic, Mythos 5.2. Setzt eine Mitgliedschaft in Cyber oder Life Sciences Verification voraus. Sobald du sie hast, greift
/fast, und dein Kontextfenster fällt nicht mehr auf 200K zurück, wenn Metadaten fehlen. - Nous Portal oder OpenRouter. Fable 5.2 ist unter der punktierten ID zum Standardpreis verfügbar. Mythos 5.2 ist nicht gelistet, die fast-mode- und Kontext-Änderungen des zweiten PRs sind für dich also theoretisch.
- Alle mit langen Sessions auf Mythos. Der stale-timeout-Unterwert ist die Korrektur, von der du nicht wusstest, dass du sie brauchst – lange Reasoning-Turns sterben nicht mehr vor dem ersten Token.
Wenn du auf der CLI-Seite neu bist, deckt die Befehlsreferenz die anderen Slash-Befehle ab, die du in einer Session tippst, und der Plugin-Katalog-Leitfaden ist die Stelle, an der du nachsiehst, wenn du das automatisieren willst, statt es pro Session zu tippen.
Das Muster hinter beiden PRs ist dasselbe, das jedes Mal auftaucht, wenn eine Modellfamilie wächst: das Modell selbst ist ein Pull Request, und es wie seine Geschwister handeln zu lassen, ist ein anderer. Beobachte den zweiten. Ein falsches Kontextfenster und ein fehlender stale-Unterwert kündigen sich nicht an; sie lassen ein gutes Modell nur mittelmäßig aussehen.