Cada mensaje lee tu config: Hermes acaba de quitar el lock de esa ruta caliente
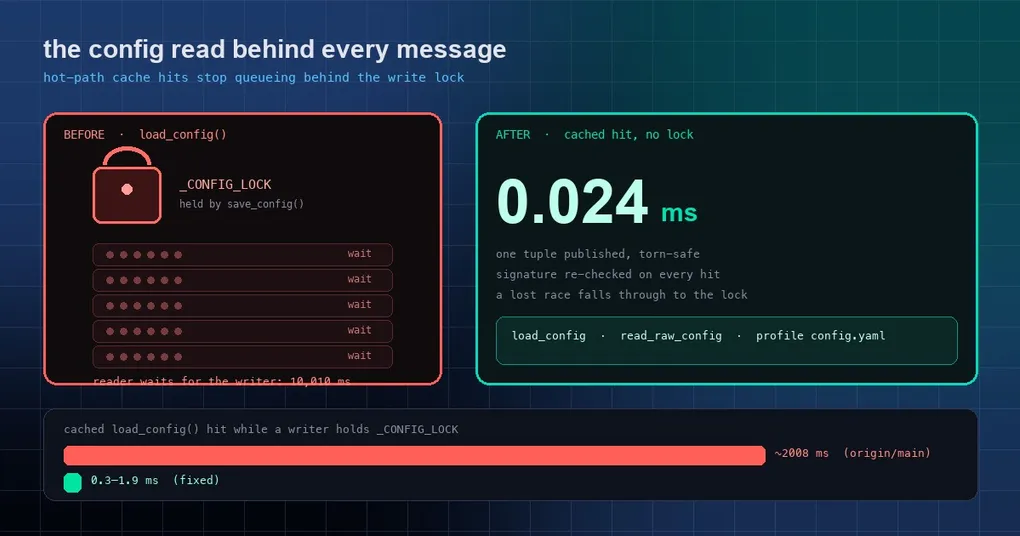
Pides a Hermes que suba un umbral de compresión. Lo hace, y escribe el cambio de vuelta en config.yaml. Durante esos pocos cientos de milisegundos disparas un mensaje a tu propio bot en Telegram — y no vuelve nada. No es el modelo ni la red. Ese mensaje está esperando un lock.
Suena a caso límite. No lo es; pasa a diario. La razón es mundana: antes de que Hermes pueda responder “¿qué modelo estoy usando?”, “¿está activado este plugin?” o “¿cuánto dura este timeout?”, la mayoría de sus rutas críticas tiene que leer la config. Y leer la config siempre ha sido una operación cara que además tiene que hacer cola. Este lote de trabajo (#118961, que absorbe #115069, #115070 y #117440) elimina el parseo redundante y el lock global de esa ruta.
De dónde venía realmente el coste
La config es YAML, así que leerla significa: localizar el archivo, parsear el YAML, fusionarlo en profundidad sobre los valores por defecto y luego entregar una copia a quien llama. Para no leer un archivo a medio escribir, todo eso corría bajo un único _CONFIG_LOCK global.
De ahí salen dos problemas:
- Cada lectura volvía a parsear. Incluso cuando no había cambiado ni un byte. Algunas rutas eran peores: la salida en streaming releía la config por cada reasoning token para decidir si emitir deltas, y la restauración del heartbeat volvía a entrar en cada ámbito de profile por cada fila.
- Las lecturas hacían cola detrás de las escrituras. Si un escritor (
save_config(), por ejemplo) tenía el lock, toda lectura esperaba. En un gateway, esa lectura está en la ruta de hooks de cada mensaje entrante, así que un solo guardado podía atascar el procesamiento de mensajes de todo el mundo.
Arreglo uno: leer una vez por stream, no por token
Tres cambios absorbidos, cada uno eliminando una repetición:
- Entrega en streaming (
agent/stream_delivery.py):plugins.stream_reasoning_deltasahora se resuelve una vez por stream en lugar de una vez por reasoning token. La medición del PR: de unos 340 µs a unos 23 µs por lectura. - Restauración del heartbeat (
gateway/run_heartbeat_restore.py): cada ámbito de profile se entra una vez por pasada de restauración, en lugar de una vez por fila. - Parseo de la config de profile (
utils.load_yaml_file_readonly): los parseos delconfig.yamlde un profile se cachean según la firma del archivo (mtime_ns, tamaño, inode,ctime_ns) — solo resultados positivos, así que un archivo cambiado se vuelve a parsear en lugar de servirse obsoleto.
Arreglo dos: un acierto de cache ya no toma el lock
Este es el importante. load_config() en hermes_cli/config.py tiene ahora una ruta rápida lock-free, y el comentario del código deja claro lo que está en juego:
# Ruta rápida lock-free para aciertos de cache — mismo contrato de publicación
# que `_read_raw_config_impl` arriba (reemplazo del tuple completo; `_CONFIG_LOCK`
# solo serializa reconstrucciones y escritores). Un acierto cuesta ~0,024 ms;
# detrás de un lock en manos de `save_config()` la misma lectura medía 10010 ms,
# y en un gateway eso atasca la ruta de hooks de cada mensaje entrante.
# Una carrera perdida cae de vuelta al lock.
¿Por qué es seguro? Por un contrato de publicación explícito: la entrada de cache se reemplaza como un único tuple completo, y el lock solo serializa reconstrucciones y escritores. Un lector, por tanto, ve o el tuple antiguo completo o el nuevo completo — nunca un estado intermedio roto. Después de tomar la instantánea vuelve a comprobar la firma del archivo; si la firma no coincide, la lectura se trata como fallo y baja por la ruta con lock.
Dicho de otro modo: las lecturas ya no necesitan hacer cola porque no leen estado bajo protección — leen una instantánea que nunca se muta en su sitio. Y perder la carrera no es una apuesta de corrección: el fallback es la implementación original, totalmente defensiva.
La misma ruta rápida se extendió a read_raw_config() y read_raw_config_readonly().
Los números de la sonda en el PR (en la máquina del autor, con un escritor manteniendo _CONFIG_LOCK durante 2 segundos):
| Lectura | Antes | Después |
|---|---|---|
Acierto de load_config() con cache |
~2008 ms | 0,3–1,9 ms |
read_raw_config() |
~2001 ms | 0,1–0,2 ms |
| Peor caso registrado en el comentario del código | 10010 ms | ~0,024 ms |
También se verificó que alternar HERMES_HOME A → B → A no muestra fugas de cache entre homes, que es justo lo que importa en despliegues multi-profile y multi-gateway.
Arreglo tres: borrar una memoización que había dejado de pagarse sola
Hay un detalle bonito enterrado en este lote: el autor eliminó una memoización en lugar de conservarla.
hermes_cli/plugins.py tenía una memo para hook_callback_timeout. Una vez que los aciertos de load_config pasaron a ser lock-free, la memo ahorraba casi nada — el PR da 8,4 µs para un acierto de memo frente a 9,0 µs por llamar a load_config_readonly() directamente, una diferencia de 0,6 µs. Pero tenía un efecto secundario real: se saltaba la comprobación de instantánea de entorno de load_config, así que si habías expresado ese timeout como referencia de entorno — la forma ${VAR} — cambiar la variable no lo habría refrescado.
Ahorrar 0,6 µs a cambio de una trampa de “cambié la variable de entorno y no pasó nada” es un mal negocio. Así que se borró en lugar de optimizarse.
Qué significa para ti
- Latencia de mensajes más estable en los gateways. “Guardar config” y “recibir mensajes” ya no se interfieren.
- Nada que configurar. No es un interruptor que se active; es el comportamiento por defecto.
- Los setups multi-profile y multi-gateway son los que más ganan, porque la restauración del heartbeat y la entrada por ámbito de profile eran costes que escalaban con el número de profiles.
Si lo que sufrías era otra cosa — “la máquina va lenta y la CPU está ocupada mientras está inactiva” — eso es otro barrido de rendimiento: mira la nota sobre disco lento / CPU inactiva. Si tu dolor es que las tareas largas se atascan a mitad, ajustar para tareas largas es la lectura más cercana. Para ver cómo se lee y se escribe la config desde el CLI, la página de referencia es hermes config; y sobre por qué conviene colapsar varios profiles en un host, mira un gateway por host.
Para cerrar
Aquí no hay funcionalidades nuevas ni claves de config nuevas — solo una idea: leer la config no debería ni hacer cola ni volver a parsear. Un acierto de cache pasó de “tomar el lock y reparsear” a “leer una instantánea que nunca se muta en su sitio y verificar luego la firma”, con la implementación original con lock como fallback. Los números de rendimiento son llamativos, pero lo más valioso es el compromiso: una memoización que vale 0,6 µs y que podía ignorar en silencio un cambio de variable de entorno no merece la pena conservar.