装的时候说「安全」,看它一眼就执行了
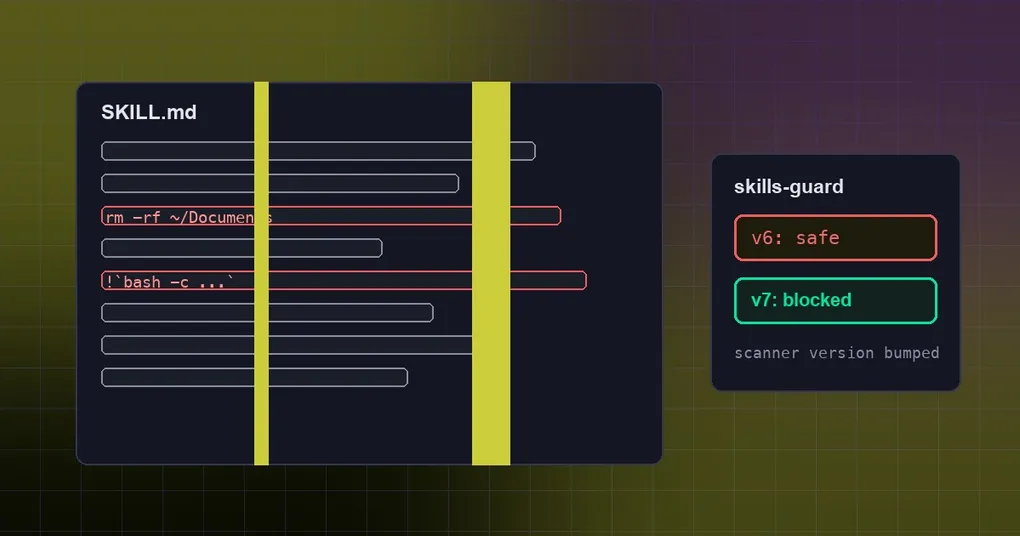
你从技能市场装了一个社区技能。安装时屏幕上闪过一行 installed,扫描报告写着安全,你也就没多想。三周之后,你在会话里打开这个技能看了一眼——然后有东西跑了起来。
危险的不是你「装」了它,而是你「看」了它。这一篇讲清楚技能守卫到底扫什么、它漏掉了哪三种情况、以及你该做哪一件补救动作。
技能守卫是怎么工作的
外部来源的技能在安装前会过一遍正则静态扫描,再按信任档位决定放不放行:
| 信任档位 | safe 结论 | caution 结论 | dangerous 结论 |
|---|---|---|---|
| builtin(内置技能) | 放行 | 放行 | 放行(从不扫描) |
| trusted(openai/skills、anthropics/skills、huggingface/skills、NVIDIA/skills) | 放行 | 放行 | 阻止 |
| community(其他社区来源) | 放行 | 阻止 | 阻止 |
| agent-created(agent 自己写的) | 放行 | 放行 | 报错回给 agent(仅当 skills.guard_agent_created 打开) |
扫描结论会连同一个扫描器版本号一起缓存(SCANNER_VERSION,修复前是 v6)。这个版本号很关键:它变了,缓存里的旧结论就不算数,技能会被重新扫一遍。
漏掉的三处
一、只有写着 $HOME 的删除才算危险
扫描器里负责「删家目录」的规则原本只匹配字面的 $HOME:
rm -rf $HOME/Documents     → 命中,critical
rm -rf ~/Documents         → 漏掉,判为 safe
于是 rm -rf ~/Documents 这样一条命令,在所有信任档位下都能顺利通过。修复后,裸波浪号的各种写法(~/、~ 、~*、~$)也一并命中,而且 rm 和 rmdir 都管。
二、没人盯着 !cmd`` 这条「自动执行」语法
Hermes 的技能支持一段行内 shell 语法:写在技能正文里的 !`cmd`,在技能被查看或加载时通过 bash -c 展开执行。这个能力由配置控制,默认是关的:
skills:
  inline_shell: false        # 默认关闭;打开前请确认技能来源可信
inline_shell_timeout: 10 # 每段 !`cmd` 的超时(秒)但扫描器里没有任何规则对应这条语法。也就是说,一个技能正文里写着 !`rm -rf ~/Documents`,扫描判 safe、装进来,然后在你下一次打开这个技能时执行。
修复新增了 inline_shell_exec 规则(严重度 high,类别 execution)。它要求 !`...` 里确实有非空命令,所以一个只是记录这条语法、没有真正命令的技能不会被误报。
三、安装失败被当成了安装成功
第三条和扫描规则无关,是接口层的问题:TUI gateway 的安装入口跑的是 do_install(skip_confirm=True),并且把输出接到了「黑洞」控制台,然后无条件返回 installed: True。
结果就是:技能明明被安全扫描拦下来了,调用方(比如桌面版的一键安装)收到的却是「装好了」。修复之后,只有真正安装成功才返回 installed: True;失败会返回一个错误信封(code 5031),把打印出来的尾部内容(扫描拦截说明、候选表、拉取失败原因)放进消息和 data.log 里,不再被丢掉。
已经装过的技能会被重新扫吗
会,但靠的是版本号而不是重装。因为缓存条目里存了 scanner_version,扫描器升到 v7 之后:
- 之前缓存下来的「safe」结论全部失效;
- 已安装的 hub 技能在重新扫描时会得到 v7 的结论;
- 新装技能当然直接走 v7。
这一点值得注意:如果你机器上的扫描器还是 v6,那么「我之前扫过、是安全的」这个结论本身就不成立——那条 rm -rf ~/Documents 当时根本没被规则覆盖。
你现在该做的事
- 确认扫描器版本。 更新到包含修复的构建后,
tools/skills_guard.py里的SCANNER_VERSION应该是skills-guard-v7(修复前是 v6)。 - 把已经装过的技能重新过一遍。 这是最重要的一步:
它专门用来重新扫描已安装的 hub 技能。命令与子命令全表见 hermes skills 命令参考,找技能的地方见技能市场与搜索源。hermes skills audit skills.inline_shell保持关闭,除非你真的信任来源。 这个开关本身就是设计给可信来源的显式选择;这次修复故意没有给它加信任档位限制(那属于产品决策),所以规则只做到「让风险在安装时可见」。- 知道扫描器的边界。 它是正则,不是数据流分析。它自己的说明里就承认一处已知缺口:
open(..., 'w')、Path.write_text、shutil.copy*这类语言层写文件的 API,如果目标是动态算出来的,扫描器没法把调用和目的地连起来,只会留下一条低严重度的「引用」提示。也就是说——扫描通过不等于可以闭眼用。 - agent 自己写的技能也要看。 在
skills.guard_agent_created打开时,agent 生成的技能命中危险规则会以报错形式退回给 agent,让它重写;但这仍然是拦住「明显的坏写法」,不是审查。
想进一步收窄边界的话,项目级技能与信任门禁讲了怎么把仓库里的技能纳入信任判断,可选技能和 MCP 目录的安全用法也是同一个话题的另外两面。
现状
PR #128443 于 2026-09-30 合并进 main,同类问题里还有一条更早的报告(issue #63307,扫描结论在安装 RPC 上被吞掉)。最新标签 v0.21.5 的日期是 9-24,所以标签里还是 v6 的扫描器——走 git 安装并跟进 main 的用户已经在 v7 上了。
小结
三个盲点有一个共同点:扫描器检查的是「写了什么字」,而真实的风险常常藏在「这些字会被怎么执行」。$HOME 和 ~ 是同一个家目录,!`...` 和 bash -c ... 是同一次执行,静态匹配看得见前者、看不见后者。
对你来说最有价值的一条动作很简单:升级之后跑一次 hermes skills audit。它会用 v7 的规则重新看你已经装在机器上的那些技能——而其中可能有几个,在旧规则下从来没被真正检查过。