让 agent 在开口之前闭嘴:pre_llm_call 现在能在模型调用前拦下整轮对话
凌晨两点,群里有人把一张工单截图粘进了机器人会话——里面带着客户手机号和身份证后四位。你的 gateway 正挂着十几个渠道,下一秒这条消息就会被送进模型,进入会话历史,再被压缩摘要、被记忆系统、被后台回顾任务读一遍。等你想起来“这个不该发出去”,已经晚了。
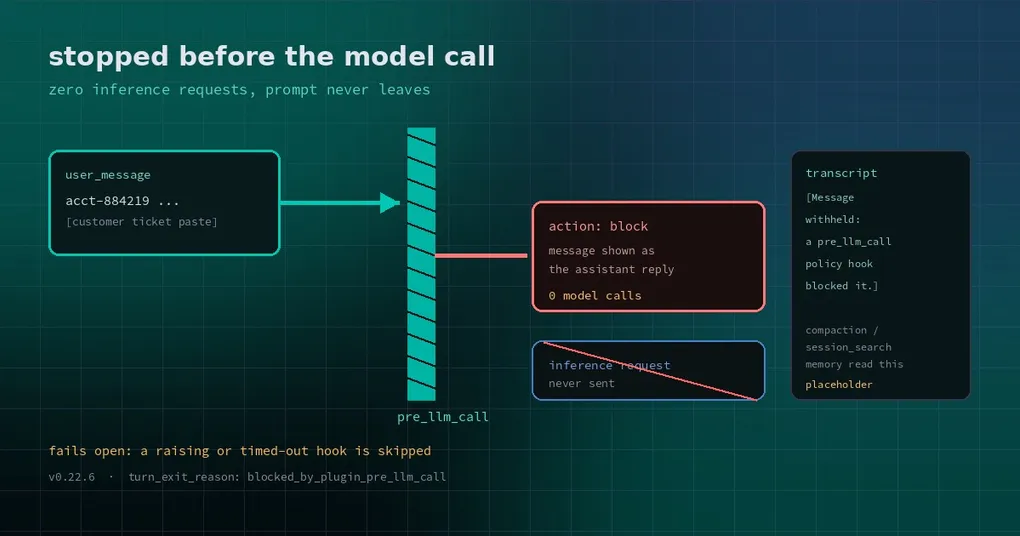
这是所有“事后补救型”护栏的通病:你只能在模型已经回答、日志已经落盘之后删数据。Hermes 在 v0.22.6 里给 pre_llm_call 钩子加了一个新返回值,把拦截点提前到了推理请求发出之前——这一轮直接结束,零次模型调用。
它拦的到底是什么
pre_llm_call 是每个回合只会触发一次的钩子,位置在上下文压缩之后、工具循环开始之前。它原本的用途是“往这一轮里塞点东西”:召回的记忆、当前的 git 状态、今天星期几。返回值是一段字符串,或者一个带 context 键的对象,内容会被追加到用户消息里(不是系统提示词,这样提示词缓存不会被打乱)。
现在它多了一个动作:
{"action": "block", "message": "这一段包含客户身份信息,已被策略拦截,请在一对一窗口里处理。"}返回这个之后发生的事,按官方文档的说法是这样:
- 不发任何推理请求,这一轮零次模型调用;
message直接作为助手回复展示给用户,并写进会话记录——所以记录里仍然是一条正常的“用户问、助手答”,--resume照常可用;- 结果里带
turn_exit_reason: "blocked_by_plugin_pre_llm_call",你能在日志/结果里精确区分“被拦下”和“模型答了”; - 先返回的 block 生效,后面的钩子不再改变结论;只返回 block 却没有 message 的,视为无效,不拦。
被拦下的那句原话,会被怎么处理
这是设计里最值得说清楚的一段,因为它决定了这个功能能不能真的当隐私护栏用。
被拦下的用户提示,在会话历史里存成一句占位符:
[Message withheld: a pre_llm_call policy hook blocked it.]之后所有会“读历史”的东西——后续回合、压缩摘要、session_search、外部记忆提供方、后台记忆回顾——读到的都是这句占位符,而不是原文。换句话说,这条内容在这一轮和以后任何一轮都不会进入模型。
你真正打的那行字只作为展示元数据保留:命令行 --resume 的回放、TUI、桌面端和 dashboard 仍然显示原文,方便你事后确认“当时到底问了什么”。
另外还有两个连带效果,官方也写明了:钩子在回合开始的压缩之前运行,所以被拦下的回合会跳过压缩、跳过会话标题生成、也跳过外部记忆的预取与同步。对被拦下的这一轮来说,这些工作本来也没有意义。
怎么写一个:Python 插件和 shell 钩子两条路
插件方式(放在你的插件里,注册即生效):
import re

CUSTOMER_ID = re.compile(r"\b(?:cust|acct)-[0-9]{6,}\b", re.I)

def policy(session_id, user_message, platform, **kwargs):
    text = user_message if isinstance(user_message, str) else ""
    if CUSTOMER_ID.search(text):
        return {
            "action": "block",
            "message": "这条消息里包含客户标识,已被策略拦截。请在工单系统里处理,或改成脱敏描述后重发。",
        }
    return None

def register(ctx):
    ctx.register_hook("pre_llm_call", policy)
shell 钩子方式(写进 profile 的 config.yaml,适合不想动 Python 的场景):
hooks:
  pre_llm_call:
    - command: "~/.hermes/agent-hooks/block-customer-ids.sh"
      timeout: 5
脚本从标准输入拿到事件 payload,往标准输出打一行 JSON 就行。{"action": "block", "message": "..."} 和 Claude Code 风格的 {"decision": "block", "reason": "..."} 两种写法都认。没有要拦的就输出 {}。
三个必须知道的边界
一、它是“失败放行”的。 钩子抛异常、或者超过 plugins.hook_callback_timeout(默认 30 秒,可设 0–600 秒)没返回,系统只记一条日志就跳过,这一轮照常进行。对比一下 pre_tool_call:那个钩子超时是失败关闭(拦下工具),而 pre_llm_call 是失败放行。官方在文档里直接给了建议:策略型钩子要自己捕获异常,判不了的时候返回 block,而不是把异常抛出去——否则一个写错的脚本会让你以为有护栏,实际什么也没拦。
顺带说,fail_closed: true 这个选项目前只对 pre_tool_call 生效,写在其它事件上会在配置解析阶段告警并被忽略。
二、exit code 2 在这里不等于拦截。 那个约定只属于 pre_tool_call。pre_llm_call 的 shell 钩子即使退出码是 2,也只当普通非零退出处理:记个警告,然后继续解析标准输出。
三、它审查的是入口,不是内容。 它只能看到这一轮的 user_message 和会话历史,看不到模型将要调用什么工具。要拦工具,那是 pre_tool_call 的活;要拦“模型说了什么”,得在 post_llm_call 里做。两层配合才完整:入口拦明显不该进来的东西,工具层拦危险动作。
什么时候值得打开
三类场景最直接:
- 合规/隐私前置:工单号、身份证、内部域名、客户的邮箱,命中就拦,提示语直接告诉对方该走哪条通道;
- 成本闸门:夜里或月底额度快用完时,直接拦下“会触发长上下文检索”的请求,比让模型先答一半再中断便宜得多;
- 提示词注入防御:粘贴进来的网页/邮件里带了明显的指令注入模式(“忽略之前的所有指令”),在进入模型之前就退回去。
这个能力在 v0.22.6 这个 tag 里,升级到该版本即可使用。钩子的完整事件清单、返回约定和超时规则在官方文档的 hooks 页面;如果你想先弄清“钩子”和“中间件”的区别,站内的 插件钩子与生命周期指南 是一个好的起点,需要人工介入的暂停点则看 human-input hooks 那篇。