Faire taire l'agent : pre_llm_call peut désormais bloquer un tour avant tout appel au modèle
Deux heures du matin, et quelqu’un colle dans une session de bot la capture d’écran d’un ticket de support — numéro de téléphone du client, quatre derniers chiffres d’une pièce d’identité, tout y est. Votre gateway surveille une douzaine de canaux. Une seconde plus tard, ce message part au modèle, entre dans la transcription, puis passe par les résumés de compaction, le système de mémoire et la passe de revue en arrière-plan. Le temps de penser « ça n’aurait jamais dû sortir d’ici », c’était déjà fait.
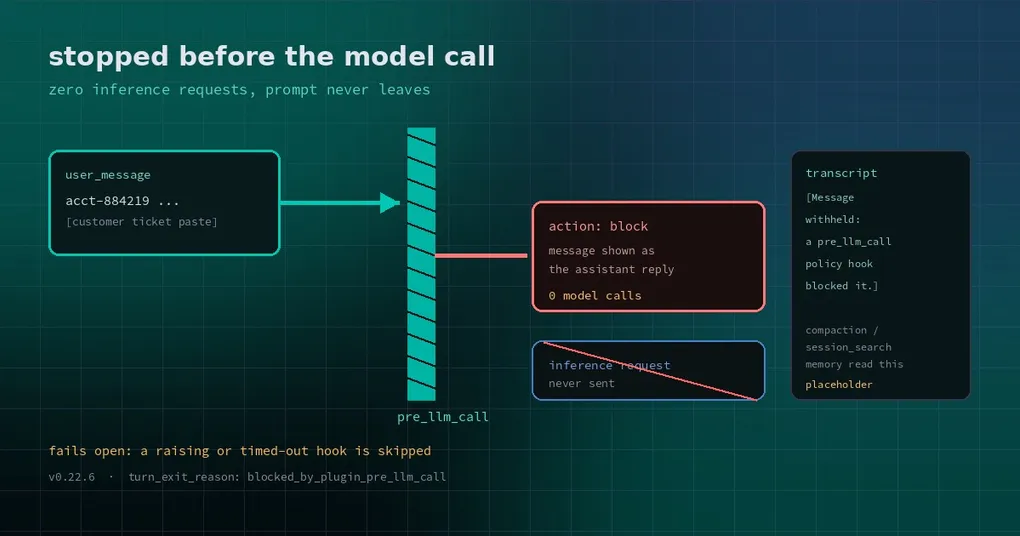
C’est le défaut de tout garde-fou a posteriori : on ne peut effacer les données qu’une fois le modèle a répondu et les logs écrits. Dans la v0.22.6, Hermes a doté le hook pre_llm_call d’une nouvelle valeur de retour qui déplace le point d’interception avant l’émission de la requête d’inférence — le tour s’arrête là, sans aucun appel au modèle.
Ce qui est arrêté exactement
pre_llm_call se déclenche une fois par tour, après la compression de contexte et avant le début de la boucle d’outils. Son rôle d’origine était de mettre des choses dans un tour : mémoires rappelées, git status courant, date du jour. Vous renvoyez une chaîne ou un objet avec une clé context, et le texte est ajouté au message utilisateur (jamais au system prompt, pour que le cache de prompt survive).
Désormais, il peut aussi refuser le tour :
{"action": "block", "message": "This message contains customer identity data and was blocked by policy. Please handle it in a 1:1 channel."}Selon la documentation officielle, voici ce qui se passe ensuite :
- Aucune requête d’inférence n’est émise. Le tour coûte zéro appel au modèle.
messageest affiché à l’utilisateur comme réponse de l’assistant et enregistré comme telle : la transcription garde donc une paire normale utilisateur-puis-assistant et--resumefonctionne toujours.- Le résultat porte
turn_exit_reason: "blocked_by_plugin_pre_llm_call", ce qui permet de distinguer « bloqué » de « le modèle a répondu » dans les logs et les résultats. - Le premier blocage l’emporte ; les callbacks suivants ne peuvent pas changer le verdict. Un blocage sans message est ignoré.
Ce qu’il advient du texte que vous avez tapé
C’est la partie qui décide si la fonctionnalité est réellement utilisable comme garde-fou de confidentialité.
Le prompt bloqué est stocké dans la transcription sous forme de placeholder :
[Message withheld: a pre_llm_call policy hook blocked it.]Tout ce qui relit l’historique ensuite — tours suivants, résumés de compaction, session_search, providers de mémoire externes, revue de mémoire en arrière-plan — lit ce placeholder au lieu de l’original. Autrement dit, le contenu n’atteint un modèle ni dans ce tour ni dans aucun tour ultérieur.
Ce que vous avez réellement tapé ne survit que comme métadonnée d’affichage : le récapitulatif --resume de la CLI, le TUI, l’application desktop et le dashboard l’affichent toujours, de sorte que vous pouvez vérifier après coup ce qui avait été demandé.
Deux effets de bord que la documentation précise aussi : le hook s’exécute avant la compaction de début de tour, donc un tour bloqué saute la compaction, le titrage de session et le préchargement/synchronisation de la mémoire externe. Pour un tour qui n’a pas eu lieu, tout ce travail ne valait de toute façon pas la peine.
En écrire un : un plugin Python ou un hook shell
Plugin Python (enregistrez-le, il est actif) :
import re

CUSTOMER_ID = re.compile(r"\b(?:cust|acct)-[0-9]{6,}\b", re.I)

def policy(session_id, user_message, platform, **kwargs):
    text = user_message if isinstance(user_message, str) else ""
    if CUSTOMER_ID.search(text):
        return {
            "action": "block",
            "message": "This message contains a customer identifier and was blocked by policy. Handle it in the ticket system, or resend a redacted description.",
        }
    return None

def register(ctx):
    ctx.register_hook("pre_llm_call", policy)
Hook shell (dans le config.yaml du profile, sans Python) :
hooks:
  pre_llm_call:
    - command: "~/.hermes/agent-hooks/block-customer-ids.sh"
      timeout: 5
Le script reçoit la charge utile de l’événement sur stdin et imprime une ligne de JSON sur stdout. Aussi bien {"action": "block", "message": "..."} que la forme à la Claude Code {"decision": "block", "reason": "..."} sont acceptées ; imprimez {} quand rien ne doit être bloqué.
Trois limites à connaître
Un : il échoue en mode ouvert (fail open). Si un callback lève une exception, ou dépasse plugins.hook_callback_timeout (30 secondes par défaut, réglable de 0 à 600), Hermes le journalise et l’ignore — le tour continue. Comparez avec pre_tool_call, où un timeout échoue en mode fermé et bloque l’outil. La documentation est explicite sur la conséquence : un hook de politique doit attraper ses propres erreurs et renvoyer un blocage quand il ne peut pas décider, sinon un script cassé ressemble à un garde-fou tout en ne bloquant rien.
À noter : fail_closed: true ne s’applique aujourd’hui qu’à pre_tool_call. Le définir sur un autre événement produit un avertissement au moment de l’analyse de la configuration, puis il est ignoré.
Deux : le code de sortie 2 n’est pas un blocage ici. Cette convention appartient uniquement à pre_tool_call. Un hook shell pre_llm_call qui sort avec 2 est traité comme n’importe quel code non nul : avertissement, puis analyse de stdout quand même.
Trois : c’est un filtre d’entrée, pas un filtre de contenu. Il voit le user_message de ce tour et l’historique de conversation — pas les outils que le modèle s’apprête à appeler. Bloquer des outils, c’est le travail de pre_tool_call ; juger ce que le modèle a dit, celui de post_llm_call. Il faut les deux couches : l’entrée arrête ce qui n’aurait jamais dû arriver, la couche des outils arrête les actions dangereuses.
Quand cela vaut la peine de l’activer
Trois cas rapportent immédiatement :
- Confidentialité et conformité en amont. Identifiants de tickets, numéros de pièce d’identité, noms d’hôtes internes, e-mails clients : détecter et bloquer, avec un message qui indique à la personne quel canal utiliser à la place.
- Un limiteur de coût. Quand le quota est presque épuisé, ou qu’il est au milieu de la nuit, refusez les requêtes qui déclencheraient une récupération massive au lieu de laisser le modèle répondre à moitié puis abandonner.
- Défense contre l’injection de prompt. Les pages web ou e-mails collés portant des patterns d’injection évidents (« ignore all previous instructions ») sont renvoyés avant que le modèle ne les voie.
La capacité est dans le tag v0.22.6 : passer à cette version suffit. La liste complète des événements, les contrats de retour et les règles de timeout se trouvent dans la documentation officielle des hooks. Si vous voulez d’abord la distinction entre hooks et middleware, notre guide des hooks de plugin et du cycle de vie est un bon point de départ, et pour les points de pause qui exigent un humain, voyez l’article sur les hooks d’entrée humaine.