插件也能"复制一份 agent 到后台"了:fork_session 与 idle tasks 实战
你写了个插件,想在每轮对话之后做一件事:看看这一轮有没有创建或修改技能,如果有,判断值不值得推荐给团队。
听起来简单,写起来全是坑。你在 post_llm_call 里拿到上下文,但没有“这一轮用了哪些工具、轮次计数到哪了”的干净入口,只能自己数;你想让这件事在后台跑,就得自己起线程、自己防重入、自己处理“用户又发了一条消息”的中断。最后写出来的东西,和 Hermes 核心的 background review 是两套逻辑,行为不一致,出问题也没人看得懂。
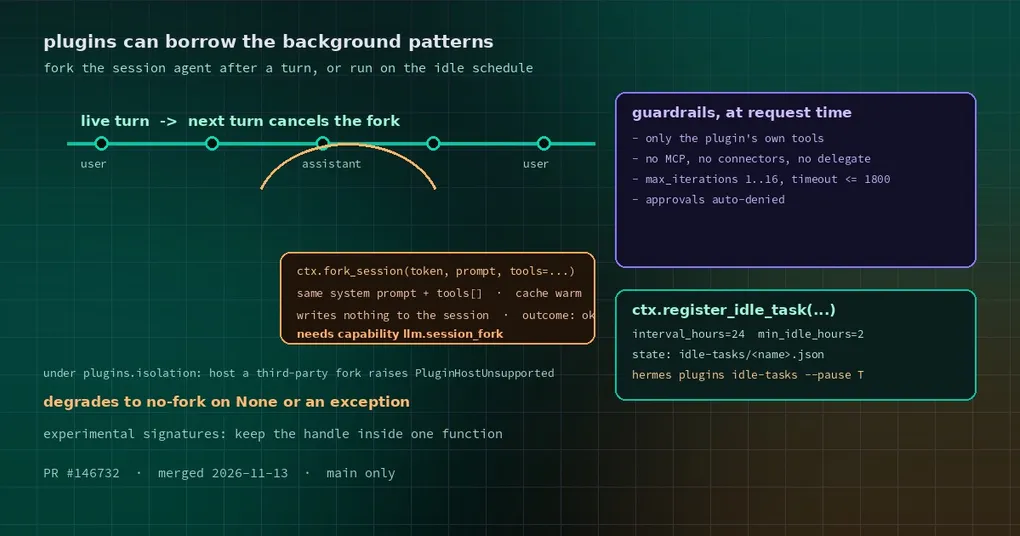
11 月 13 日合并的 PR #146732(49 个文件、约 4500 行)把这件事变简单了:核心自己用的两个后台模式,现在以 API 的形式开放给插件——ctx.fork_session 和 ctx.register_idle_task。这篇讲清楚它们能做什么、边界在哪、以及怎么写得不会在半年后崩掉。
两个模式,一句话概括
ctx.fork_session:在一轮对话结束后,复制一份这个会话的 agent 到后台,让它带着同样的系统提示词、工具列表、记忆和历史,去做一件多步的事。这就是 Hermes 自己做记忆/技能后台评审用的模式。ctx.register_idle_task:给“没有轮次可挂”的工作(每天重算一次索引、定期清理缓存、建议一次整理)一个调度器。它跑在技能 curator(Hermes 的技能整理器)的同一套空闲调度上。
两个都是实验性的。官方文档写得很明确:签名和 fork handle 的形状可能在后续版本变化。所以写法上有一条硬要求——把 handle 关在一个小函数里,只返回普通数据,不要跨轮次存它。
fork_session:复制一份 agent 去后台
签名:
handle = ctx.fork_session(
    token,                      # post_llm_call 的 side_question_token
    prompt,                     # <= 8192 字符
    tools=(),                   # 允许调用的工具名
    max_iterations=8,           # 1..16
    input_budget=None,          # 只能收紧,不能放宽
    task=None,                  # 走某个 auxiliary 通道的模型
    timeout=None,               # 秒,<= 1800
)
返回值是一个 handle,或者 None(表示这次请求没有被启动)。
关键点:fork 和会话共享逐字节一致的系统提示词和 tools[]。这意味着第一次请求几乎全是 cache 读——你花的是“后台多跑几步”的钱,不是“重新起一个 agent”的钱。
fork 做不了什么,也很清楚:
- 不写 session transcript,也不写 session 数据库。后台做的事不会污染你的对话历史。
- 危险命令审批一律自动拒绝。fork 不能替你点“同意”。
- 下一轮对话一开始,fork 就被取消——不管它是正在跑、正在启动、还是排队中。
最后一条是设计核心。fork 是“这一轮的余兴”,不是“后台常驻任务”。如果你需要跨轮次的长期任务,那是 cron 或 idle task 的活,不是 fork。
一个 token,一次机会
token 来自 post_llm_call 钩子的 side_question_token。规则比名字听起来严格:
- 一轮对话只支持一次请求,side question 或 fork,两者共享同一个 token,而且所有插件共享。
- 无人值守的轮次没有 token:cron 任务、子代理,都拿不到。
- 没有
llm.session_fork能力的插件拿不到 token,也不会消耗它。 - 请求里点名了白名单之外的工具,返回
None且不消耗 token;其他情况的None会消耗。
最后两条的差别很重要:写错了工具名不会浪费这一次机会,但如果是别的原因被拒(比如会话 agent 已经释放),机会就没了。所以别在 hook 里做“试错式调用”。
工具白名单:只有你自己的工具
fork 能调用的工具,来自一个很窄的白名单:
- 你这个插件用
register_tool注册的工具(而且当前注册必须仍然属于你,并且 Hermes 会把它派发到工具注册表); - 核心工具里被标记为 fork-safe 的那些——目前一个都没有。
其他一切都在名单外:别的插件的工具、所有 MCP 工具、connectors、memory provider 和 context engine 提供的工具,以及 delegate_task、message_agent、cronjob_manage、Kanban 系列工具。
还有一层容易被忽略:即使某个名字是你注册的,如果 Hermes 在工具注册表之前就把它派发掉了(agent 级工具、legacy 别名、Tool Search 桥、任何 connectors__<connector>__<tool> 形式的名字),它也在名单外——因为调用根本到不了你的 handler。
实际影响是:fork 只能做“你这个插件自己定义的动作”,不能变成“偷偷启动一个子代理”或者“偷偷调度一个 cron”的入口。
预算、超时与取消
max_iterations把 fork 的循环卡在 1–16 之间。- 输入的累计 token 按 background review 的方式设上限(
auxiliary.background_review.max_input_tokens,默认是上下文窗口的 75%),input_budget只能把这个上限调低。 timeout是墙钟秒数,最多 1800,协作式生效——fork 在下一个中断检查点停下。- 下一轮对话开始 → 排队中和运行中的 fork 都取消。
有一段官方文档写得特别实在,值得照抄进你的代码注释:provider 调用如果不理中断,handle 会一直开着直到它返回。所以永远用带超时的 handle.wait(t),不要裸等。
handle 与 outcome
handle 暴露这些:done、cancelled、outcome、result(fork 的最终文本,或 None)、actions(它按顺序调用了哪些白名单工具)、wait(timeout)、cancel()。它永远不会把 fork 的 agent 本身暴露给你。
outcome 的取值值得记住,因为排查问题全靠它:
| outcome | 含义 |
|---|---|
deferred |
本地托管运行时(内置 llama-server)上等机器空闲,像 background review 那样 |
running |
正在跑 |
ok |
正常结束,result 里有文本 |
cancelled |
被下一轮对话或 cancel() 取消 |
superseded |
同一个插件同一个会话的更新 deferred fork 替换了它 |
timeout |
墙钟超时 |
budget_exhausted |
输入预算用完 |
error |
运行期错误 |
error:spawn |
工作线程起不来(这时返回的是已结算的 handle,不是异常) |
refused:<reason> |
请求被拒:parent_gone(会话 agent 已释放)、moa(Mixture-of-Agents 运行时)、agent_provider、runtime_changed(这轮之后换了模型或 provider) |
怎么知道“是我的工具在被 fork 调用”
工具 handler 在 fork 里被调用时,会收到一个关键字参数 turn_origin="plugin_fork:<你的插件 id>"。活着的 agent 调用你的工具时不带这个参数。
这个设计解决了一个真实的安全问题:如果 fork 和主 agent 调同一个工具,你的工具就没法区分“是模型自己决定分享”还是“后台检查建议分享”。官方示例里就是这么用的——工具只有在 turn_origin == "plugin_fork:wisdom" 时才允许弹出分享卡片。
计费也分得清:fork 的用量记在 plugin_fork:<插件 id> 名下;它的每次 provider 请求触发 pre_auxiliary_call / post_auxiliary_call,带 aux_task="plugin_fork" 和 plugin_id,不会触发轮次级的 pre_api_request / post_api_request。
register_idle_task:没有轮次可挂的活
签名:
ctx.register_idle_task(name, fn, interval_hours=24, min_idle_hours=2, first_run="defer")它返回一个 PluginRegistration(dispose 它就能停止轮询)。任务在这些地方被调度:
- gateway 的 housekeeping(每个被服务的 profile 都会跑);
- CLI / TUI 启动时;
hermes serve的维护 tick。
fn 跑在自己的线程里,在注册它的那个 profile 里。宿主不等它:轮询函数立刻返回,而且同一个任务不会有两个实例同时跑。
状态存在插件数据目录下:idle-tasks/<name>.json,字段包括 last_run_at、run_count、paused、last_summary、last_status、last_error。所以每个 profile 各自调度自己的一份。
写 fn 有三条契约,违反了就会在半夜出怪事:
- 保持短:自己带时间上限,分批做,把 checkpoint 写进插件数据,下一轮接着做。
- 保持幂等:被重启打断的一轮不会留下记录,下次会从头再跑一遍。同一批数据跑两次不能出事。
- 不要指望 stop 信号:gateway 关闭时不会启动新的运行,会等几秒等在跑的那次,然后就走了。插件代码停不下来,
fn也没有停止信号——它跑完时什么都不记录(状态保持成运行前的样子),然后释放 claim。
关于 claim:运行 claim 会记下持有者(pid、进程启动时间、机器)。已崩溃的持有者会在下一次轮询时被立刻接管,而不是等一小时;只有“无法校验的持有者”(在另一台机器上写的 claim)才按一小时算。curator 也用同一套实现——这次重构把它从 curator 里抽到了 agent/idle_schedule.py。
fn 里的模型调用走 ctx.llm 和它的信任门。注意:fn 没有轮次,所以它拿不到 side_question_token,也不能 fork 会话。
用 CLI 管这些任务
hermes plugins idle-tasks                # 列出本 profile 里注册的所有 idle task
hermes plugins idle-tasks <plugin>       # 看某个插件的任务详情
hermes plugins idle-tasks <plugin> --pause nightly-reindex
hermes plugins idle-tasks <plugin> --resume nightly-reindex
列表里会显示状态、运行次数、上次和下次运行时间、上次的摘要或错误。这是排查“我的任务到底跑没跑”最快的入口——比看日志快得多。
review_signals:跟着用户的自学习节奏走
post_llm_call 现在还多了一个 review_signals,它告诉你这一轮结束时 Hermes 自己的评审节奏走到哪了:技能评审是否到期、记忆评审是否到期、计数器、间隔、后台评审是否开启。
为什么这很重要:以前你在插件里想“每 N 轮检查一次”,只能自己数,而用户设置的间隔跟你数的不一样。现在你可以直接读用户的设置,和他的自学习节奏对齐。
什么时候不可用
plugins.isolation: host:第三方插件的ctx.fork_session存在,但会抛PluginHostUnsupported(一个RuntimeError)。原因是 handle 追踪的是 Hermes 进程内活着的会话 agent 的一个线程。- cron 任务和子代理轮次:没有
side_question_token,所以没有 fork。 - MoA / agent-as-provider 运行时:outcome 是
refused:moa或refused:agent_provider。
官方给的降级写法很朴素:把 None 和异常都当作“这次不 fork”,插件在两种环境下都能工作。
def _try_fork(ctx, token, prompt):
    try:
        return ctx.fork_session(token, prompt, tools=["wisdom_offer_share"], max_iterations=4)
    except Exception:      # PluginHostUnsupported, or anything else
        return None
一段完整的最小例子
import json
import threading


def register(ctx):
    def offer_share(args, turn_origin=None, **kwargs):
        if turn_origin != "plugin_fork:wisdom":
            return json.dumps({"error": "only the background check may offer a share"})
        return json.dumps({"offered": True})

    ctx.register_tool("wisdom_offer_share", "wisdom", OFFER_SCHEMA, offer_share)

    def on_post_llm_call(side_question_token=None, review_signals=None, **kwargs):
        if side_question_token is None or not (review_signals or {}).get("skill_review_due"):
            return
        handle = ctx.fork_session(
            side_question_token,
            "Did this session change a skill the team would benefit from? "
            "If so, call wisdom_offer_share once; otherwise answer 'no'.",
            tools=["wisdom_offer_share"],
            max_iterations=4,
        )
        if handle is not None:
            threading.Thread(
                target=lambda: handle.wait(600) and ctx.state.set("last_check", handle.outcome),
                daemon=True,
            ).start()

    ctx.register_hook("post_llm_call", on_post_llm_call)
以及插件清单里必须声明能力:
capabilities:
  - llm.session_fork
开启时用户看到的授权文案大致是:“在一轮之后运行你的 agent 的后台副本。它能看见整个会话(包括记忆),可以使用插件自己的工具,并且会消耗你主模型的 token。”
这段文案本身就是最好的设计说明:fork 能看见整个会话。所以如果你的插件会把 fork 的输出发给第三方,先想清楚这一点。
状态:main only,而且是实验性的
PR #146732 于 2026 年 11 月 13 日合并,只落在 main 上,不在 v0.23.1 里。而且两个接口都被明确标注为实验性——签名可能变。
更新(2026-11-17):这里说的改动已随 v0.23.2 发布(2026-11-16),
hermes update就能拿到。上文「不在 v0.23.1 里」是发布当时的快照。
实践建议:
- 如果
fork_session返回None或抛异常,插件必须能正常工作(“这次不 fork”)。 - 不要把 handle 存进 state 跨轮次用,它活不过一轮。
- 用带超时的
wait,不要裸等。 - 上线前先用
hermes plugins validate跑一遍(插件目录/API 的整体玩法见 插件目录指南,隔离模式见 plugins.isolation 指南,公开 API 清单见 插件公开 API)。
如果你只想做“每天整理一次数据”这种活,register_idle_task 是更省心的选择——它不需要能力声明,也不需要 token,还自带暂停/恢复和崩溃接管。fork 适合的是“必须紧接在这一轮之后、必须看见这一轮的上下文”的工作。这两者选错了,代码会写得很别扭。