Les plugins peuvent désormais copier l’agent en arrière-plan : fork_session et tâches idle
Vous écrivez un plugin censé faire une chose après chaque tour : vérifier si la session a créé ou modifié un skill et, si oui, décider s’il vaut la peine d’être recommandé à l’équipe.
Ça a l’air petit. Ça ne l’est pas. Dans post_llm_call vous obtenez du contexte mais aucun handle propre sur « quels outils ce tour a utilisés, où en sont les compteurs » — donc vous comptez vous-même. Pour lancer le travail en arrière-plan vous créez un thread, vous gardez la ré-entrance, et vous gérez « l’utilisateur vient d’envoyer un autre message ». Ce que vous finissez par obtenir, c’est une seconde implémentation, moins bonne, de la revue en arrière-plan que le core exécute déjà, avec un comportement différent et aucun vocabulaire partagé quand elle dysfonctionne.
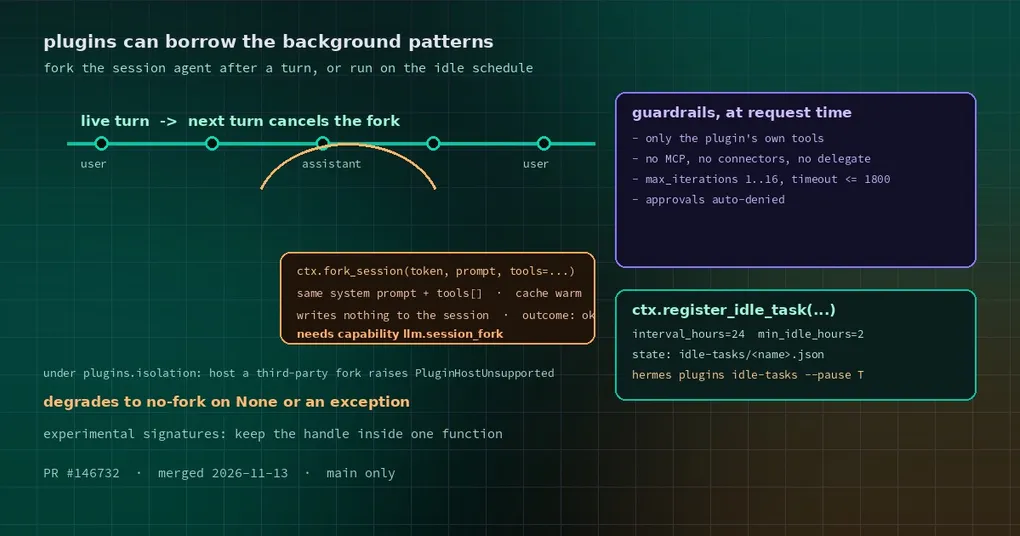
La PR #146732 (49 fichiers, ~4 500 lignes, fusionnée le 13 novembre) corrige ça : les deux motifs d’arrière-plan que le core utilise pour lui-même sont désormais des API plugin — ctx.fork_session et ctx.register_idle_task. Voici ce qu’ils font, où sont les bords, et comment écrire contre eux sans devoir tout réécrire dans six mois.
Deux motifs en une phrase
ctx.fork_sessioncopie l’agent de la session en arrière-plan après un tour, en emportant le même system prompt, la même liste d’outils, la même mémoire et la même conversation, et travaille sur un prompt multi-étapes. C’est le motif derrière la revue de mémoire et de skills en arrière-plan d’Hermes lui-même.ctx.register_idle_taskdonne un tour à du travail qui n’a pas de tour auquel s’accrocher — re-scorer des données chaque jour, compacter un cache, suggérer un nettoyage — l’ordonnancement idle du skill curator.
Les deux sont expérimentaux. La doc dit explicitement que les signatures et la forme du handle de fork peuvent changer. Ça vous donne une règle de code dure : gardez le handle dans une petite fonction qui renvoie des données simples, et ne le stockez jamais au-delà du tour.
fork_session : une copie en arrière-plan de l’agent du tour
handle = ctx.fork_session(
    token,                      # side_question_token de post_llm_call
    prompt,                     # <= 8192 caractères
    tools=(),                   # noms d'outils autorisés
    max_iterations=8,           # 1..16
    input_budget=None,          # ne peut que resserrer la borne
    task=None,                  # exécuter sur le modèle d'une voie de tâche auxiliaire
    timeout=None,               # secondes, <= 1800
)
Il renvoie un handle, ou None quand rien n’a été démarré.
La propriété importante : un fork partage le system prompt et le tools[] du tour vivant octet pour octet, donc sa première requête est surtout des lectures de cache de prompt. Vous payez pour « quelques étapes de plus en arrière-plan », pas pour monter un agent neuf.
Ce qu’un fork ne fera pas est tout aussi clair :
- Rien n’est écrit dans la transcription ni dans la base de session. Le travail d’arrière-plan ne peut pas polluer la conversation.
- Les approbations de commandes dangereuses sont refusées automatiquement. Un fork ne peut pas cliquer « approuver » à votre place.
- Le tour vivant suivant annule le fork — qu’il tourne, qu’il démarre, ou qu’il soit encore différé.
Cette dernière règle est le centre du design. Un fork est l’after d’un tour, pas un daemon. Si vous avez besoin de travail longue durée à travers les tours, c’est cron ou une idle task, pas un fork.
Un token, une chance
token est le side_question_token de post_llm_call, et les règles sont plus strictes que le nom ne le suggère :
- Une requête par tour, side question ou fork, partagée par tous les plugins.
- Les tours non surveillés n’ont pas de token : les runs cron et les tours de subagent reçoivent
None. - Un plugin sans
llm.session_forkreçoitNoneet ne dépense pas le token. - Nommer un outil hors de l’allowlist renvoie
Nonesans dépenser le token ; tous les autresNonele dépensent.
Cette distinction compte : une faute de frappe dans un nom d’outil ne vous coûte rien, mais un refus pour une autre raison (disons que l’agent de session a été libéré) brûle l’unique chance. Donc ne sondez pas par essais à l’intérieur du hook.
L’allowlist d’outils : vos propres outils, rien d’autre
Un fork peut appeler un ensemble étroit :
- les outils que votre plugin a enregistrés avec
register_tool(et dont l’enregistrement courant est toujours le vôtre, dispatché via le tool registry) ; - les outils core qu’Hermes marque fork-safe — aucun pour l’instant.
Tout le reste est dehors : les outils des autres plugins, tous les outils MCP, les connecteurs, les outils de memory-provider et de context-engine, et delegate_task, message_agent, cronjob_manage, ainsi que les outils Kanban.
Il y a une couche plus subtile : même un nom que vous avez enregistré est hors allowlist si Hermes le dispatche avant le tool registry (outils au niveau agent, alias legacy, le bridge Tool Search, tout nom connectors__<connector>__<tool>), parce que l’appel n’atteindrait jamais votre handler.
L’effet pratique : un fork ne peut faire que « les actions que ce plugin définit ». Il ne peut pas devenir une porte dérobée pour lancer un subagent ou planifier un cron.
Budgets, timeouts, annulation
max_iterationsborne la boucle du fork entre 1 et 16.- Les tokens d’entrée agrégés sont bornés comme ceux de la revue en arrière-plan (
auxiliary.background_review.max_input_tokens, 75 % de la fenêtre de contexte par défaut) ;input_budgetne peut que baisser ça. timeoutest en secondes de temps réel, au plus 1800, et coopératif — le fork s’arrête à sa prochaine vérification d’interruption.- Le tour suivant démarre → les forks en file et en cours sont annulés.
Une ligne de la doc mérite d’être recopiée dans vos commentaires : un appel provider qui ignore l’interruption garde le handle ouvert jusqu’à son retour. Utilisez toujours un handle.wait(t) borné ; n’attendez jamais sans borne.
Le handle et ses issues
Le handle expose done, cancelled, outcome, result (le texte final du fork ou None), actions (les noms d’outils allowlistés appelés, dans l’ordre), wait(timeout) et cancel(). Il n’expose jamais l’agent du fork lui-même.
outcome est ce avec quoi vous déboguez :
| outcome | signification |
|---|---|
deferred |
en attente que la machine soit idle sur un runtime géré localement (llama-server embarqué), comme la revue en arrière-plan |
running |
en vol |
ok |
terminé, result contient le texte |
cancelled |
annulé par le tour suivant ou par cancel() |
superseded |
un fork différé plus récent du même plugin et de la même session l’a remplacé |
timeout |
temps réel écoulé |
budget_exhausted |
budget d’entrée épuisé |
error |
erreur d’exécution |
error:spawn |
le thread worker n’a pas pu démarrer (vous obtenez un handle réglé, pas une exception) |
refused:<reason> |
parent_gone, moa, agent_provider ou runtime_changed |
Distinguer un fork de l’agent vivant
Un handler d’outil appelé dans un fork reçoit le keyword turn_origin="plugin_fork:<plugin id>". Les appels que fait l’agent vivant ne portent aucun turn_origin.
Ça bouche un vrai trou : sans ça, un outil ne peut pas distinguer « le modèle a choisi de partager ceci » de « la vérification en arrière-plan a suggéré de partager ». L’exemple officiel utilise exactement ça — l’outil ne propose la carte de partage que quand il est appelé depuis plugin_fork:wisdom.
La facturation est séparée aussi : l’usage est facturé à la session comme plugin_fork:<plugin id>, et chaque requête provider déclenche pre_auxiliary_call / post_auxiliary_call avec aux_task="plugin_fork" et plugin_id — jamais les pre_api_request / post_api_request liés au tour.
register_idle_task : du travail sans tour auquel s’accrocher
ctx.register_idle_task(name, fn, interval_hours=24, min_idle_hours=2, first_run="defer")Il renvoie un PluginRegistration (disposez-le pour arrêter le polling). Les tâches sont planifiées depuis :
- le housekeeping du gateway, pour chaque profile servi ;
- le démarrage CLI / TUI ;
- le tick de maintenance de
hermes serve.
fn tourne sur son propre thread, dans le profile qui l’a enregistré. L’hôte n’attend pas : le poll rend la main immédiatement, et une seconde exécution de la même tâche ne démarre jamais tant qu’une est en vol.
L’état vit dans le répertoire de données du plugin à idle-tasks/<name>.json — last_run_at, run_count, paused, last_summary, last_status, last_error — donc chaque profile planifie sa propre copie.
Trois contrats pour fn, et les casser produit des mystères nocturnes :
- Gardez-la courte. Donnez-lui sa propre limite de temps, travaillez par petits lots, checkpoint dans les données du plugin pour que l’exécution suivante reprenne.
- Gardez-la idempotente. Une exécution coupée par un redémarrage n’enregistre rien et repart du début. Rejouer le même lot doit être inoffensif.
- N’attendez pas de signal d’arrêt. À l’arrêt du gateway, aucune nouvelle exécution ne démarre et le gateway attend quelques secondes celle qui est en vol, puis s’arrête sans elle. Le code plugin ne peut pas être arrêté et
fnne reçoit aucun signal — quand elle finit, elle n’enregistre rien (l’état reste tel qu’avant l’exécution) et libère son claim.
Sur les claims : un claim d’exécution enregistre son propriétaire (pid, démarrage du process, machine). Un propriétaire planté est repris au poll suivant, pas après une heure ; seul un propriétaire invérifiable (un claim écrit sur une autre machine) compte comme abandonné après une heure. Le curator partage cette implémentation — la porte d’intervalle et le claim d’exécution ont migré dans agent/idle_schedule.py dans cette PR.
Les appels de modèle depuis fn passent par ctx.llm et sa porte de confiance. Notez ce que fn n’a pas : pas de tour, donc pas de side_question_token, donc pas de fork.
Gérer les idle tasks depuis la CLI
hermes plugins idle-tasks                       # toutes les idle tasks de ce profile
hermes plugins idle-tasks <plugin>              # les tâches d'un plugin
hermes plugins idle-tasks <plugin> --pause nightly-reindex
hermes plugins idle-tasks <plugin> --resume nightly-reindex
Le listing montre le statut, le nombre d’exécutions, la dernière et la prochaine, et le dernier résumé ou la dernière erreur. C’est le moyen le plus rapide de répondre à « ma tâche a-t-elle vraiment tourné » — bien plus rapide que lire les logs.
review_signals : suivre la cadence de l’utilisateur
post_llm_call reçoit aussi désormais review_signals : si la revue de skills et la revue de mémoire sont dues, les compteurs, les intervalles, et si la revue en arrière-plan est active.
Ça compte parce que l’ancien contournement — « vérifier tous les N tours » — comptait vos tours alors que l’utilisateur avait configuré une autre cadence. Maintenant vous pouvez lire les réglages de l’utilisateur et vous aligner sur le rythme d’auto-apprentissage d’Hermes au lieu d’en inventer un.
Quand ce n’est pas disponible
plugins.isolation: host: lectx.fork_sessiond’un plugin tiers existe mais lèvePluginHostUnsupported(unRuntimeError), parce que le handle suit un thread de l’agent de session vivant à l’intérieur du process Hermes.- Les tours cron et subagent : pas de
side_question_token, donc pas de fork. - Les runtimes MoA et agent-as-provider : l’outcome est
refused:moaourefused:agent_provider.
La dégradation documentée est simple : traitez None et les exceptions comme « pas de fork cette fois » pour que le plugin fonctionne dans les deux environnements.
def _try_fork(ctx, token, prompt):
    try:
        return ctx.fork_session(token, prompt, tools=["wisdom_offer_share"], max_iterations=4)
    except Exception:      # PluginHostUnsupported, ou autre chose
        return None
Un exemple minimal qui marche
import json
import threading


def register(ctx):
    def offer_share(args, turn_origin=None, **kwargs):
        if turn_origin != "plugin_fork:wisdom":
            return json.dumps({"error": "only the background check may offer a share"})
        return json.dumps({"offered": True})

    ctx.register_tool("wisdom_offer_share", "wisdom", OFFER_SCHEMA, offer_share)

    def on_post_llm_call(side_question_token=None, review_signals=None, **kwargs):
        if side_question_token is None or not (review_signals or {}).get("skill_review_due"):
            return
        handle = ctx.fork_session(
            side_question_token,
            "Did this session change a skill the team would benefit from? "
            "If so, call wisdom_offer_share once; otherwise answer 'no'.",
            tools=["wisdom_offer_share"],
            max_iterations=4,
        )
        if handle is not None:
            threading.Thread(
                target=lambda: handle.wait(600) and ctx.state.set("last_check", handle.outcome),
                daemon=True,
            ).start()

    ctx.register_hook("post_llm_call", on_post_llm_call)
Et la capability va dans le manifeste du plugin :
capabilities:
  - llm.session_fork
L’écran de consentement que voient les utilisateurs dit en substance : « Lancer une copie en arrière-plan de votre agent après un tour. Elle voit toute la session, mémoire comprise, peut utiliser les outils propres au plugin, et dépense les tokens de votre modèle principal. »
Cette phrase est la meilleure note de design de toute la fonctionnalité : un fork voit la session entière. Si votre plugin transmet la sortie d’un fork à un tiers, réfléchissez-y d’abord.
Statut : main uniquement, et expérimental
La PR #146732 a été fusionnée le 13 novembre 2026, vit sur main, et n’est pas dans la v0.23.1. Les deux API sont explicitement expérimentales, donc les signatures peuvent bouger.
Mise à jour (17/11/2026) : ces changements sont sortis dans la v0.23.2 (16 novembre) : un
hermes updateles récupère. Le « pas dans la v0.23.1 » ci-dessus est un instantané du jour de publication.
En pratique :
- Le plugin doit fonctionner quand
fork_sessionrenvoieNoneou lève (« pas de fork cette fois »). - Ne gardez jamais le handle dans l’état à travers les tours ; il ne survit pas à un seul.
- Faites toujours un
waitborné. - Lancez
hermes plugins validateavant de livrer — voir le guide du catalogue de plugins, le mode isolation et la liste des API publiques de plugins.
Si tout ce qu’il vous faut est « re-scorer mes données une fois par jour », register_idle_task est le choix le plus simple : aucune capability, aucun token, et vous obtenez pause/resume plus la reprise après crash gratuitement. Un fork, c’est pour du travail qui doit atterrir immédiatement après ce tour et doit voir le contexte de ce tour. Choisissez le mauvais et le code se bat avec vous tout du long.