AI 写代码越来越快,代码库为什么没有烂掉
你让 agent 重构一个模块,它交回 800 行 diff,你扫一眼,合并。三个月后你打开那个文件——4,000 行,每个函数十几个分支,改一行要先花一小时读懂上下文。问题不在于 agent 写得差,而在于生成速度已经远远超过人工审查速度:一天能加 5,000 行,而没有人有能力一天读 5,000 行。代码库不是被某一次糟糕的提交毁掉的,是被“每次都只多一点点”累积压垮的。
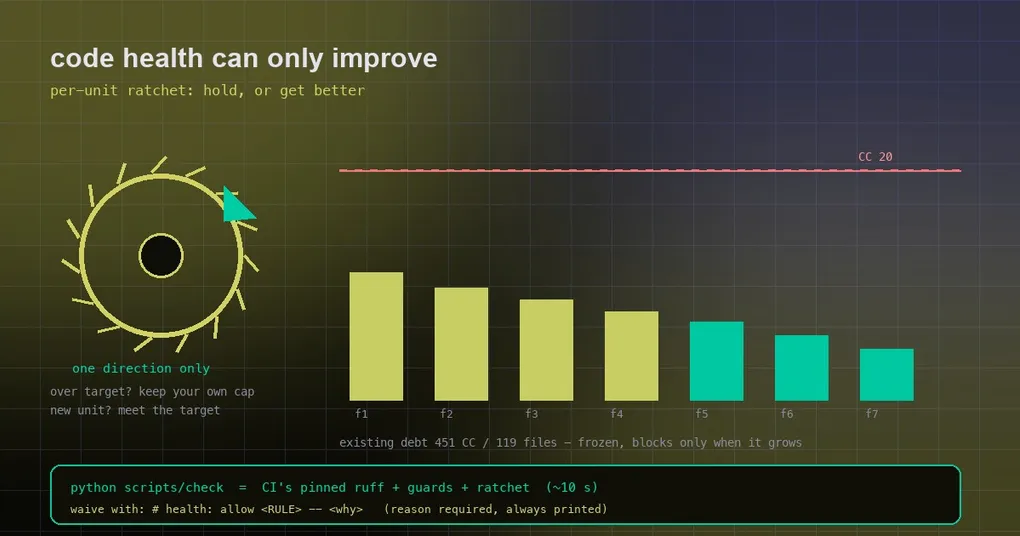
2026 年 10 月 5 日,Hermes 仓库合并了 PR #132646,装上了一个很有意思的机制:代码健康度只能变好,不能变坏。它不是在追求某个理想目标,而是用“棘轮”(ratchet)的思路——每个函数、每个文件各自保持自己当前的水平,只允许朝好的方向动。下面是它具体怎么运作,以及你可以从里面拿走什么。
棘轮的核心:各自为界,不许挪用
规则只有两层,但很硬:
- 已经超标的东西,不许再涨。 一个函数如果是 40 的圈复杂度(CC,Cyclomatic Complexity,简单说就是“这段代码里有多少条独立分支路径”),它可以在下一次改动中保持 40,也可以降到 20,但不能变成 41。
- 新东西必须达标。 新增的函数和文件必须满足目标值:CC 20、函数自身 300 行、嵌套深度 6 层、文件 2,000 行。
更细的一条是“不许挪用额度”:模式类规则(比如“吞掉异常”)的违规是按指纹(规则 + 所在函数 + 该行文本)追踪的。修好一处违规,不会给你换来新增另一处的权利,也不存在“这个文件修了三处,所以另一个文件可以多三处”这种池化操作。这条规则很关键——不然棘轮会被当成积分卡来玩。
没有 baseline 文件,这是最妙的一点
大多数代码健康工具需要一个 baseline:把当前所有违规记下来,之后不许超过它。问题是这个文件会变成冲突源——两个并行 PR 同时想改它,谁先合谁赢。
Hermes 的做法是不存 baseline,而是每次现场测量:拿这次改动碰到的文件在 base(合并提交的第一个父提交)和 head 两边的状态算一遍。带来三个好处:
- 一个改进一旦落到
main,它立刻成为新的上限,不需要有人记得去“收紧棘轮”; - 并行 PR 之间不会因为棘轮状态互相冲突;
- 两边永远用同一个工具版本测量,结果可比。
搬走的代码保留额度,复制的不算
这条是给重构留活路的关键设计:
- 函数按“函数体哈希”匹配,忽略名字。一个函数被移到另一个文件并做了轻微修改(函数体相似度 ≥ 0.6,一边消失一边出现),它保留自己的上限。模块级的语句如果原样搬走,也一样。
- 如果原处还留着副本,那它就是新代码——得按达标线来。
- 重命名的文件跟随 git 的 rename detection,不会因为改名就被当成新文件。
- 嵌套函数算独立单元:改一个闭包内部,不会算到包含它的那个钩子或函数头上。Python 的 CC 用 ruff 的 C901 数值再减去直接嵌套的 def。
除了体积,还拦什么
体积只是其中一类。规则清单(每条规则的作用、适用范围和“给 agent 看的修复建议”都在 scripts/code_health/config.py 里):
| 类别 | 规则 |
|---|---|
| 吞掉异常 | S110、BLE001、E722(裸 except:);注意只写 logger.warning("...: %s", e) 而没别的处理,也算吞掉 |
| 正确性 | F821/F823/F811/F841、RUF006 |
| 可能挂住 | ASYNC230/ASYNC240、S113、HX006(subprocess/urlopen 没有 timeout)、HX007(async def 里做同步配置 I/O)、HX008(get_event_loop)、HX009(gather 的结果拿 Exception 去判) |
| Profile 作用域 | HX001(硬编码 ~/.hermes)、HX002(新引入的 HERMES_* 环境变量)、HX004(UnscopedSecretError 回退到 os.getenv)、HX005(import 期捕获)、HX012(裸 threading.Thread),以及 profile_scope_patterns.json 里的 PS-P05/PS-P06 |
| 其他 | HX003(用 argv 判断进程身份)、HX010(把环境变量字符串直接 bool())、HX011(if/elif 长阶梯) |
有一组规则是只警告不拦截的:HX001、HX003、HX010、HX012、PS-P05、PS-P06。理由是它们在评审给的样本里准确率只有大约 12%–60%。它们每次运行都会打印,但不会挡提交;等有回放证据之后再翻成拦截,只是改一行的事。
逃逸阀:可以豁免,但必须写理由
再好的规则也有例外。写法是在那一行加:
# health: allow BLE001 -- <why>
理由必填。而且每一次被使用的豁免都会列在输出里,评审的人一眼能看到这一轮新增了几个豁免、分别是什么。这比“允许 # noqa“要好,因为 # noqa 通常是静默的。
一条命令,和 CI 完全一样
最实用的部分在本地体验上:python scripts/check 会并行跑 ruff、那一堆守卫检查(footgun / shebang / 临时目录 / 配置写入 / 系统标记 / 大小写冲突 / 懒加载依赖 / profile 归档),以及棘轮本身,用的是 CI 锁定的那个 ruff 版本(取自 pyproject 的 dev 组,如果本地版本不一致,退回 uvx ruff@<pin>,绝不静默用你机器上那个)。整棵树大约 10 秒。
常用参数:
python scripts/check                # 全部检查,对比与 origin/main 的合并基点
python scripts/check --only health  # 只跑代码健康棘轮
python scripts/check --staged       # 判定暂存区(pre-commit 钩子跑的就是它)
python scripts/check --commit REV   # 判定某一个提交(pre-push 钩子跑的就是它)
python scripts/check --install-hook pre-push
python scripts/check --uninstall-hook钩子是可选安装的,而且可以用 --no-verify 跳过;CI 跳不过。scripts/check 要求 Python 3.11+(需要 tomllib),版本太低会明确提示你用仓库的 venv 跑,而不是抛一堆 traceback。
还有一个总开关:ENFORCEMENT = "blocking" | "advisory" | "off",写在 scripts/code_health/config.py 里。关键在于它永远从 main 读(CI 读合并提交的第一个父提交,本地读 origin/main),从不从被检查的分支读——所以主分支上一行提交就能给所有打开的 PR 降档,而任何一个 PR 都无法放松自己的检查。
这套东西上线前先跑了回放
一个新门禁最怕“拦下一堆正确的东西”。所以它先在冻结的历史上做回放:把 2026-10-02 到 10-03 之间合并的全部 PR 重新检一遍。
| 检查项 | 结果 |
|---|---|
| 冻结回放(318 个 PR) | 59 个会被拦。其中 38 个纯粹因为文件体积增长;21 个来自其他规则:10 个 PR 有 CC 增长或新函数 CC>20,9 个 PR 有 13 处“盲豁免”,F841 5 处(同一个测试文件),一个测试 F811(一个被遮蔽、从来没运行过的测试),一处 S110,一个新出现的 300+ 行函数 |
| 文件体积棘轮 | 在这段窗口里是 38/318(12%) 的唯一拦截原因,多数是往已经超过 2,000 行的文件里多加了 1–50 行(main.ts、auxiliary_client.py、cron/scheduler.py、23,000 行的 test_tui_gateway_server.py) |
| 全树报告(main) | 今天仍超标的单元:CC 451 个、函数行数 55 个、嵌套 28 个;文件行数 119 个;BLE001 6,516 处、S110 828 处、HX012 227 处、HX006 209 处、HX005 53 处——这些是既有债务,只在它们继续增长时才拦人 |
最后那行值得多想一秒:这个机制不要求任何人还债。既有的 6,516 处吞异常不会被要求修掉,它们只是被冻在那里,不再增长。这让门禁可以落地——如果一上线就要求清零历史债务,唯一的结果是没人敢开这个开关。
你可以从里面拿走什么
如果你的团队也在大量使用 agent 写代码,这套设计里有几条是可以直接抄的:
- 棘轮而不是目标。不要定“以后 CC 不超过 20”,而是“已经超的不许更超,新的必须达标”。前者会卡住所有存量代码的修改。
- 现场测量,不存 baseline 文件。省掉并行 PR 的冲突,也省掉“谁记得去收紧棘轮”这个纪律问题。
- 模式类违规按指纹追踪,修一处不能换新增一处。
- 新规则先只警告,用历史回放测出准确率再翻成拦截。
- 豁免必须带理由,并且要被打印出来——静默豁免等于没有规则。
- 本地一条命令 = CI,别让开发者靠 CI 猜规则。
顺带说一句,这个仓库自己在 9 月被 agent 大规模重构过一次,1,393 个子代理把非测试 Python 代码削掉 34.4%。那件事证明了 agent 能大规模改代码;这篇讲的棘轮,解决的是“改完之后怎么防止它慢慢长回去”——两件事其实是同一个问题的两面。如果你关心这类工程化约束在 CI 里的落地方式,插件目录的供应链校验讲的是另一种“把规矩写进流水线”的做法。
小结
写这套东西的人有一个很克制的判断:不追求理想,只守住现状。代码健康度达标的目标值(CC 20、函数 300 行、嵌套 6 层、文件 2,000 行)不是道德标准,而是“从这里开始不继续恶化”的闸门。真正让它能活下去的是三个细节:既有的超标代码被冻住而不是被清算、门禁的开关永远由 main 定而不是被检查的分支定、以及每一条规则都要先拿历史数据证明自己不会误伤。当生成代码的边际成本趋近于零时,这类机制的稀缺性反而会上升——因为唯一越来越贵的东西,是人读懂代码的时间。