Uma execução de cron perdida deve ser recuperada? grace_minutes responde job por job
Você fecha o notebook para uma reunião de duas horas. Ao abrir de novo, há dois relatórios diários idênticos esperando — o job das 15:00 perdeu o horário enquanto a máquina dormia, foi recuperado ao acordar e então disparou outra vez às 16:00. Você apaga a duplicata e pensa “da próxima vez, é só pular”.
Só que a recuperação existe por um motivo. Se a sincronização de dados das 03:00 foi perdida porque a máquina reiniciou, você quer que ela rode logo depois do boot, não amanhã. A pergunta nunca foi se recuperar é bom; é por quanto tempo um job específico deve estar disposto a esperar. O Hermes aplicava uma regra única a todos os jobs. Agora cada job pode definir a sua.
O que o padrão realmente faz
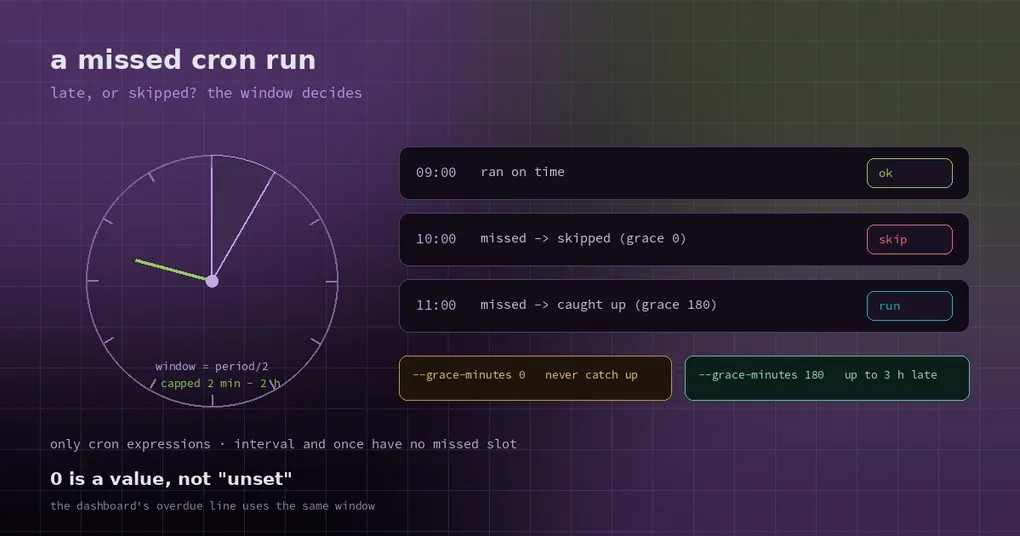
O agendador encontra um horário devido no passado e tem duas opções: executar agora, ou pular e reancorar na próxima ocorrência. A decisão usa uma janela de recuperação:
- metade do período do job,
- limitada entre 2 minutos e 2 horas.
Assim, um job que roda a cada minuto tem janela de 2 minutos: qualquer coisa mais atrasada é considerada velha e ele salta para o próximo minuto em vez de disparar uma rajada de execuções de recuperação. Um job diário ganha 12 horas, então reabrir o notebook no meio da manhã ainda conta como “atrasado, mas válido”. Um job horário ganha 30 minutos.
| Período | Janela de recuperação padrão |
|---|---|
| A cada minuto | 2 minutos (piso) |
| A cada 15 minutos | 7,5 minutos |
| A cada hora | 30 minutos |
| Diário | 12 horas |
| Semanal | 2 horas (teto) |
Jobs de execução única são um caso à parte: recebem 120 segundos de tolerância e depois expiram.
A regra é sensata — períodos longos toleram mais atraso, períodos curtos avançam rápido — mas encaixa mal em dois cenários comuns:
- Relatórios diários ou semanais que devem rodar no máximo uma vez por dia. Uma janela de 12 horas significa que o job dispara ao acordar, mesmo que você já tenha conferido os números no celular, gerando notificações duplicadas.
- Jobs sensíveis a horário. Puxar dados de mercado 30 minutos antes da abertura não serve para nada às 11:00. Melhor pular.
Sobrescrevendo a janela por job
A sobrescrita é em minutos:
# nunca recuperar: uma ocorrência perdida é descartada
hermes cron edit market-open --grace-minutes 0

# aceita rodar com até três horas de atraso
hermes cron edit nightly-sync --grace-minutes 180
Você também pode definir na criação:
hermes cron create "30 9 * * 1-5" "Busque as cotações antes da abertura e escreva o briefing" \
  --name market-open \
  --grace-minutes 5
O intervalo vai de 0 a 1440 minutos (um dia inteiro). 0 é um valor de verdade, que significa “nunca recuperar”. Para voltar à janela calculada, passe uma string vazia:
hermes cron edit nightly-sync --grace-minutes ""Isso vale apenas para expressões cron. Agendamentos once e interval não têm horário de relógio perdido — interval conta a partir da última execução e once é um horário absoluto — então definir o valor neles não faz nada, e o CLI avisa em vez de aceitar em silêncio.
Três configurações típicas
Relatórios diários e semanais: 0. O que importa é se rodou hoje, não se a cópia de ontem acaba aparecendo. Com 0 a ocorrência perdida é descartada, o descarte fica registrado no log e o próximo horário roda normalmente. As notificações duplicadas acabam.
Jobs noturnos em uma máquina que dorme: use um valor alto. Quem usa notebook é o caso clássico: sincronização às 23:00, máquina que liga às 08:00. A janela padrão cobre um job diário, mas o semanal fica limitado a 2 horas, então use --grace-minutes 600 e ele ainda recupera pela manhã.
Jobs sensíveis a horário: mantenha pequena. Jobs de pré-abertura, pré-lançamento ou pré-conciliação não servem para nada atrasados. Dê 5 ou 10 minutos e deixe que sejam pulados. Um relatório desatualizado que roda com sucesso é mais perigoso do que um job que não rodou, porque ninguém percebe.
Desligando a recuperação globalmente
Se você não quer recuperação em lugar nenhum:
hermes config set cron.catch_up_missed falseUm job recorrente que passou da janela passa a ser reancorado na próxima ocorrência futura em vez de disparar, e o descarte é registrado no log. Jobs ainda dentro da janela, além de disparos manuais, seguem o comportamento normal. Em relação ao ajuste por job: o switch global é um desligamento, o valor por job afrouxa ou aperta a janela de um job — uma vez que a recuperação esteja desligada globalmente, uma janela generosa por job não tem sobre o que agir.
Em deployments hospedados com um provider de cron gerenciado existe mais uma camada: cron.misfire_grace_minutes (padrão 10) é por quanto tempo o gateway espera a nova tentativa do próprio provider antes de recuperar localmente, de modo que uma entrega falha custa minutos em vez do dia inteiro.
Quatro armadilhas
0é um valor, não “não definido”. Os comentários do código deixam isso explícito:0 == False, então qualquer teste do tipo “vazio significa limpar” descarta0em silêncio e restaura a janela padrão. O CLI e o parsing de configuração tratam um0explícito como definido — se você editar ojobs.jsonpor script, tenha o mesmo cuidado.- Só expressões cron. Agendamentos
intervaleonceignoram o campo; ele não vai controlar como um job “a cada 5 minutos” recupera execuções perdidas. - A distribuição de profiles descarta campos desconhecidos. Se você exporta e distribui definições de job entre profiles,
grace_minutesprecisa estar na lista de campos permitidos, senão o lado que recebe volta para a janela padrão. - Os health checks mudam junto. A linha “este job está atrasado” do dashboard usa a mesma janela do agendador. Mudar a tolerância muda também o limite do alarme — o que está correto (senão o dashboard sinalizaria jobs que o agendador considera em dia), mas o momento dos seus alertas vai mudar.
Confirmando que surtiu efeito
hermes cron list                 # a linha Grace aparece apenas quando há uma sobrescrita
hermes cron doctor               # aponta um valor inutilizável, ou definido em um agendamento não-cron
Em hermes cron list, o bloco de detalhes de cada job ganha uma linha Grace mostrando algo como 180 min. Jobs sem sobrescrita não têm essa linha. O hermes cron doctor verifica dois modos de falha: um valor inutilizável e um valor definido em um agendamento que não consegue usá-lo. Para confirmar que um descarte realmente aconteceu, procure a linha de log Skipping missed occurrence — ela informa a causa (grace_minutes ou o global cron.catch_up_missed=false) e o horário da próxima execução.
Para um passo a passo completo de health check, veja o guia do cron doctor; para disparos errados causados por fuso horário, o artigo sobre fuso horário e horário de verão; para montar jobs do zero, o guia de automação com cron.
Status
O grace_minutes chegou ao main em 2026-10-28 e já vem na v0.22.6 (2026-11-02): basta atualizar para definir a janela de recuperação por tarefa. Em builds anteriores, a alternativa é o switch global cron.catch_up_missed: tamanho único, mas suficiente para parar com as recuperações duplicadas.