Installer un plugin sans redémarrer le gateway : Hermes le câble à la volée
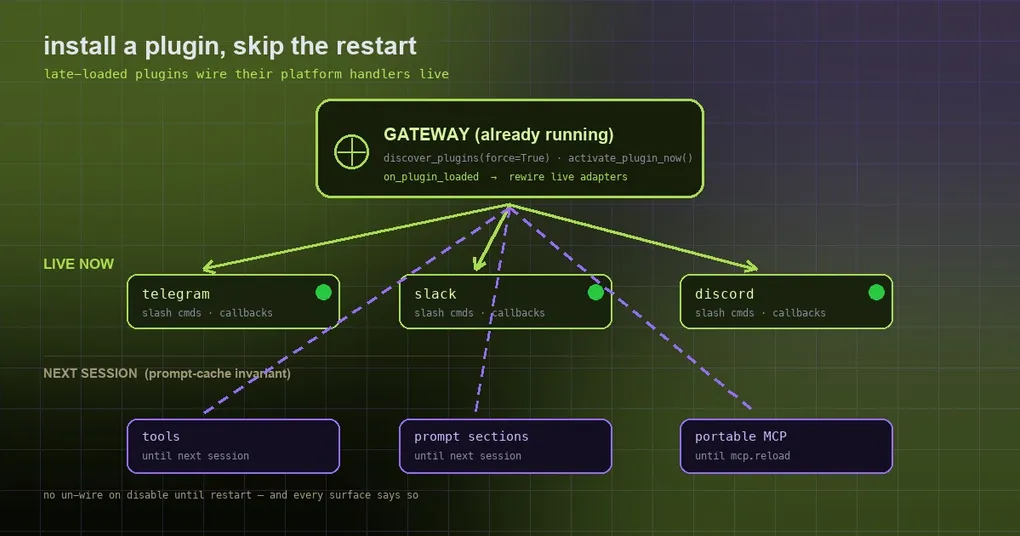
Vous installez un plugin sur votre bot dans un groupe Telegram. Il apporte une nouvelle commande slash. Vous la tapez dans le groupe, plein d’attentes — et le bot fait comme s’il n’avait rien entendu. La doc dit : redémarrez le gateway. Ce qui signifie qu’une réponse en streaming est coupée, que les jobs en arrière-plan meurent et que chaque session repart de zéro. C’est un prix lourd pour une seule commande slash.
Alors la plupart des gens attendent le prochain redémarrage. Cela vient de changer (#119266, qui corrige #87770) : installez un plugin pendant que le gateway tourne, et ses handlers de plateforme sont câblés sur place.
Pourquoi un redémarrage était autrefois obligatoire
Tout le problème tenait à quand les plugins sont découverts :
discover_plugins()s’arrête court une fois la découverte effectuée, sauf si vous passez explicitementforce=True.- Aucun des chemins d’installation à chaud ne le passait. Pire,
tools/mcp_tool_config._portable_mcp_serversl’appelait sans forçage — donc exécutermcp.reloadaprès une installation à chaud rechargeait le vieux jeu de serveurs. - Le
plugins.manage installde la TUI revenait dès que l’helper d’installation avait fini, sans aucun rescan. - Les adaptateurs de plateforme (Telegram, Slack, …) construisaient leur registre de handlers au boot et ne regardaient plus jamais.
Effet net : les fichiers du plugin étaient sur le disque, la config l’avait activé, et le processus en cours n’en savait rien.
Un récapitulatif d’activation : actif maintenant vs session suivante
Chaque chemin de chargement à chaud est désormais un vrai rescan forcé, et il émet un callback depuis l’intérieur même de ce rescan (PluginManager.on_plugin_loaded) portant un récapitulatif d’activation par plugin nouvellement chargé. Ça ressemble à ceci :
{"name": "late-mcp", "key": "late-mcp",
 "activated_now": {"gateway_commands": ["late"], "callbacks": ["telegram"]},
 "deferred": {"tools": ["late_tool"], "prompt": ["late.section"], "mcp_servers": ["worker"]}}
En clair :
| Catégorie | Quand cela s’applique | Ce que cela couvre |
|---|---|---|
| Commandes slash du gateway | Immédiatement | les noms de commandes enregistrés par le plugin |
| Hooks de transform du gateway | Immédiatement | transform_llm_output, transform_tool_result, transform_terminal_output, pre_gateway_dispatch, gateway_platform_event, pre_command |
| Autres hooks | Immédiatement | les noms de hooks restants |
| Callbacks de plateforme | Immédiatement | les plateformes dotées d’une factory register_platform_handler, plus les action ids Slack |
| Tools | Session suivante | les noms de tools |
| Sections de system-prompt | Session suivante | les ids de sections |
| Serveurs MCP portables | Un mcp.reload, ou la session suivante |
les noms exactement tels qu’ils apparaissent dans mcp.json |
La plus utile des trois lignes « immédiatement » est les callbacks de plateforme : les callbacks de boutons et les transforms de messages entrants d’un plugin fonctionnent désormais sans redémarrage.
Pourquoi le câblage ne double pas et ne perd pas face aux handlers du cœur
« Fonctionne immédiatement » a l’air simple ; deux pièges le rendent moins simple.
Piège un : la double inscription. Un rechargement forcé rend de nouveaux objets fonction, donc l’identité des fonctions ne peut pas vous dire si quelque chose était déjà câblé. Le correctif consiste à indexer chaque câblage sur (plugin, factory qualname) — un plugin, une factory, un câblage. C’est pourquoi la méthode s’appelle un recâblage idempotent (rewire_plugin_handlers()) : elle relit le registre des factories et n’exécute que celles qui ne sont pas encore câblées sur le client natif vivant.
Piège deux : l’ordre. Sur Telegram, les handlers nouvellement ajoutés sont hissés devant les catch-alls du cœur. Cela compte parce que PTB ne dispatche que le premier match par groupe, et le cœur enregistre un catch-all filters.COMMAND — un handler tardif placé derrière ne se déclencherait jamais. Slack fait l’équivalent en dédupliquant register_slack_action_handler par AsyncApp.
Le runner du gateway s’abonne par profile servi au boot, et sur l’événement recâble chaque adaptateur vivant sur la boucle d’événements. Tout cela se passe à l’intérieur du processus gateway, pas dans le processus qui a lancé l’installation.
Chaque surface d’installation vous dit la vérité
CLI, Desktop, TUI ou l’installation REST du dashboard — toutes rapportent exactement ce qui est actif maintenant et ce qui attend :
hermes plugins install late-mcp --enableLa commande pousse d’abord le gateway en cours (un verbe reload-plugins sur la control socket, qui lui demande de rescaner de force le home visé), puis imprime cette séparation actif-vs-différé. Le plugins.manage install/toggle/update du Desktop/TUI renvoie activation plus gateway_reloaded ; restart_required est true uniquement quand aucun gateway n’a répondu.
Il y a une prise de position éditoriale délibérée dans ce design : mieux vaut ne rien faire que faire semblant. D’où :
- Les tools et les sections de system-prompt d’un plugin chargé tardivement ne s’appliquent pas à la session en cours. Même règle que
/skills install— le prompt et le schéma de tools d’une session vivante restent stables en cache, et un changement en plein vol les casserait. - Les serveurs MCP portables attendent
mcp.reload. - Désactiver ne décâble pas. Désactivez un plugin en cours d’exécution et ses handlers déjà câblés restent jusqu’au redémarrage du gateway. Chaque surface le dit, plutôt que de vous laisser croire que c’est instantanément propre.
À quoi cela ressemble en pratique
Une exécution typique :
# 1. installer et activer (pousse le gateway en cours à rescaner)
hermes plugins install late-mcp --enable

# 2. la sortie indique que gateway_commands: ["late"] est actif maintenant
#    donc /late fonctionne déjà dans votre groupe Telegram — sans redémarrage

# 3. si le plugin embarque aussi un serveur MCP, faites-le monter lui aussi
#    (via mcp.reload, ou simplement en démarrant une nouvelle session)
Une mise en garde à intégrer : le gateway doit servir le home où vit le plugin. L’événement se propage par profile, et un gateway qui ne sert pas ce profile ne câblera rien pour lui. Sur les déploiements multi-profile et multi-gateway, c’est plus facile à déclencher que sur une seule machine — pour le contexte, voyez un gateway par hôte.
Limites et mises en garde
- Cette version ne couvre que les handlers. Les tools, les sections de system-prompt et les serveurs MCP portables restent hors de l’ensemble immédiat, pour les raisons de cache de prompt et de durée de vie des connexions évoquées plus haut.
- Il n’y a pas de décâblage. Le câblage est unidirectionnel : une installation s’applique immédiatement ; une désactivation ne nettoie vraiment qu’après un redémarrage. Les mises à niveau se comportent de la même façon.
- La confiance accordée aux plugins ne s’est pas relâchée. C’est un mécanisme de câblage à l’exécution, pas un assouplissement de la revue ; pour savoir d’où viennent les plugins et comment ils sont admis, voyez le modèle de confiance du catalogue de plugins et le SDK de plugins du bureau.
- Les plugins de backend terminal sont un autre sujet — voyez les plugins de backend terminal.
Pour conclure
« Il suffit de redémarrer après l’installation » est survivable sur un setup jouet, mais sur un gateway qui fait du vrai travail c’est un verrou dur — il repousse chaque mise à niveau à 3 h du matin. La moitié de ce verrou a maintenant disparu : ce qui doit prendre effet immédiatement (handlers de plateforme, commandes slash, hooks de transform) le fait, et ce qui doit attendre un tour (tools, sections de prompt, connexions MCP) le dit tout haut — y compris le fait que désactiver ne décâble pas. L’autre moitié ne bougera pas de sitôt, parce qu’elle se heurte de plein fouet à l’invariant du cache de prompt.