Sortir l'exécution du code de votre portable : sandboxes persistants et lots parallèles avec Hermes + Flame
Vous demandez à l’agent de traiter un journal de 200 Mo : le nettoyer, l’agréger, en faire un graphique. Chaque étape est assez rapide — jusqu’au moment où vous voulez relancer trois combinaisons de paramètres sur un portable de 16 Go. Les ventilateurs s’emballent, vous surveillez la mémoire du coin de l’œil, et chaque candidat réimporte pandas depuis zéro. Autre cas : vous voulez tester huit hypothèses d’un coup, et l’agent les enchaîne une par une, parce qu’un shell local ne sait rien faire d’autre.
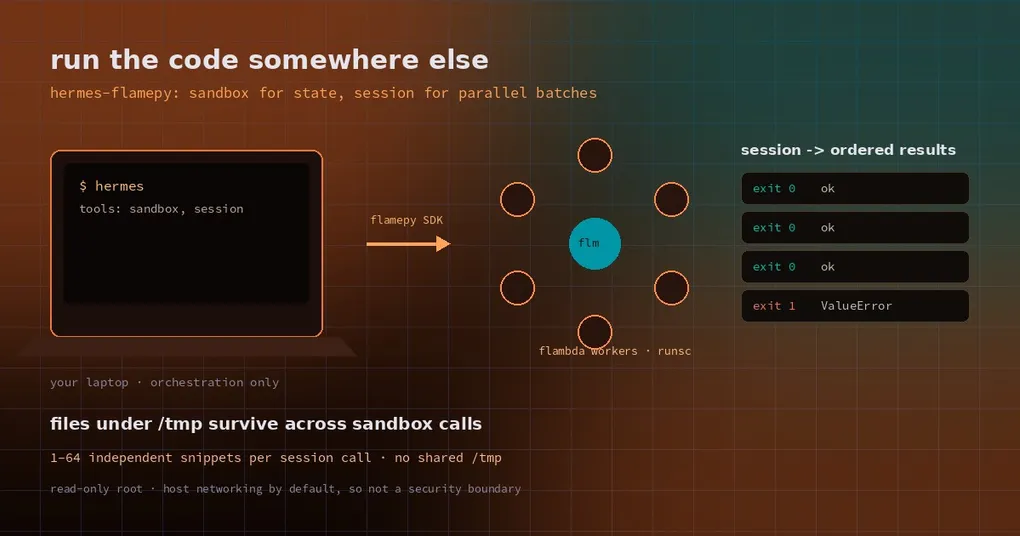
Les clusters d’exécution distante règlent ce problème, mais y brancher un agent suppose généralement d’écrire de la colle. Le plugin communautaire hermes-flamepy prend un autre chemin : il ajoute à Hermes deux outils qui soumettent des extraits de code à un cluster Flame, laissant votre machine orchestrer et lire les résultats.
Trois murs quand on exécute du code en local
Le budget de contexte. Si chaque étape renvoie les données et les résultats intermédiaires dans la fenêtre de contexte du modèle, quelques tours suffisent à la saturer. La bonne approche consiste à laisser les fichiers dans l’environnement d’exécution et à ne rendre au modèle que des résumés — mais l’exécution locale, c’est un processus par appel : l’état se perd facilement.
La puissance de calcul. Votre parallélisme, c’est votre nombre de cœurs. Un balayage de paramètres passe plus de temps à faire la queue qu’à calculer.
Un environnement encrassé. Des mois de pip install expérimentaux sur l’hôte, et plus personne ne se souvient quel paquet appartenait à quelle exécution.
Un sandbox distant attaque les trois d’un coup : les fichiers restent à distance, le parallélisme vient du cluster, et l’environnement est une image jetable.
Deux outils, une seule règle de dépendance
Le plugin expose exactement deux outils, et le choix entre les deux se résume à une question : l’étape suivante a-t-elle besoin des fichiers de l’étape précédente ?
| Outil | Entrée | Exécution | À utiliser pour |
|---|---|---|---|
sandbox |
une chaîne code |
appels séquentiels dans un même sandbox persistant ; les fichiers sous /tmp survivent entre les appels |
un travail en plusieurs étapes dépendantes : nettoyer → agréger → graphique |
session |
une liste codes de 1 à 64 extraits |
chaque extrait sur son propre executor, exécuté en parallèle, sans /tmp partagé |
des candidats indépendants : balayages, comparaisons côte à côte |
Les deux prennent language (python ou shell, python par défaut) et un timeout optionnel en secondes.
La règle relève de la correction, pas du style. Les extraits d’une session peuvent atterrir sur des workers différents : « j’écris un fichier ici, je le lis dans l’extrait suivant » échoue de façon aléatoire. À l’inverse, entasser du travail indépendant dans sandbox revient à jeter le parallélisme que vous avez payé.
Installation
hermes plugins install xflops/hermes-flamepy
hermes plugins enable hermes-flamepy
hermes tools enable flamepy
Deux prérequis, tous deux obligatoires :
- un cluster Flame avec l’application
flmboxenregistrée etrunsc(gVisor) sur les executors ; flamepy0.7.0 ou plus récent installé dans l’environnement Hermes, configuré pour joindre ce cluster.
Le plugin ne planifie rien lui-même — il traduit les appels d’outils en appels au SDK Flame ; la mise en file, l’affectation des workers et le téléchargement des images appartiennent au cluster. Autrement dit, son plafond de fiabilité, c’est votre déploiement Flame, pas le plugin.
Scénario un : plusieurs étapes qui partagent des fichiers
Premier appel : sandbox en shell pour créer l’entrée.
mkdir -p /tmp/demo
printf 'region,revenue,cost\neast,120,75\nwest,80,55\n' > /tmp/demo/sales.csv
Deuxième appel : toujours sandbox, cette fois en Python pour lire le fichier et écrire un résumé.
import csv, json
from pathlib import Path

work = Path("/tmp/demo")
rows = list(csv.DictReader((work / "sales.csv").open()))
revenue = sum(int(r["revenue"]) for r in rows)
profit = revenue - sum(int(r["cost"]) for r in rows)
summary = {"rows": len(rows), "revenue": revenue, "profit": profit}
(work / "summary.json").write_text(json.dumps(summary))
print(json.dumps(summary))
Troisième appel : on le relit pour prouver que le fichier a survécu. Ce qui ne survit pas, ce sont les variables Python ou les réglages du shell — seul le système de fichiers persiste. Un sandbox vous donne la même machine, pas le même interpréteur.
Ce système de fichiers racine en lecture seule explique pourquoi le plugin positionne PIP_TARGET et PYTHONPATH sur /tmp/site-packages : seul /tmp est inscriptible, donc un simple pip install fonctionne encore et les appels suivants peuvent importer le paquet. L’image n’embarque pas uv, les métadonnées de dépendances en ligne PEP 723 ne sont donc pas disponibles.
Scénario deux : quatre candidats en un seul appel
Comparez trois politiques de remise plus une entrée invalide. Chaque programme est indépendant, donc les quatre partent dans un seul appel session :
import json

revenues = [120, 80, 150, 100]
costs = [75, 55, 90, 70]
discount = 0.1          # les autres extraits utilisent 0.0 / 0.2 / 1.2

if not 0 <= discount <= 1:
    raise ValueError("discount must be between 0 and 1")

revenue = round(sum(revenues) * (1 - discount), 2)
print(json.dumps({"discount": discount, "revenue": revenue,
                  "profit": round(revenue - sum(costs), 2)}))
Le résultat est un tableau dans l’ordre de soumission, un objet par extrait :
[
  {"exit_code": 0, "stdout": "{\"discount\": 0.0, \"revenue\": 450.0, ...}\n", "stderr": ""},
  {"exit_code": 0, "stdout": "{\"discount\": 0.1, \"revenue\": 405.0, ...}\n", "stderr": ""},
  {"exit_code": 0, "stdout": "{\"discount\": 0.2, \"revenue\": 360.0, ...}\n", "stderr": ""},
  {"exit_code": 1, "stdout": "", "stderr": "ValueError: discount must be between 0 and 1\n"}
]
Regardez la dernière entrée : un extrait en échec ne fait pas échouer les autres. Un exit_code non nul signifie que ce programme a échoué. Si un extrait n’a pas pu démarrer du tout (erreur d’infrastructure ou du SDK), exit_code vaut -1 et l’erreur se trouve dans stderr. Cette distinction compte en validation par lots : dans le premier cas c’est votre réponse, dans le second c’est un problème d’environnement.
Lire les résultats sans se raconter d’histoires
- Vérifiez
exit_codeavant la sortie.0est un succès,1relève en général de la logique du programme,-1signifie qu’il faut appeler l’exploitant du cluster, pas le débogueur. - Faites confiance à l’ordre. L’ordre d’achèvement est non déterministe ; le tableau de résultats suit toujours l’ordre d’entrée, donc le candidat 3 est toujours l’élément 3.
- Rendez les effets de bord idempotents. Sur une session périmée, le plugin relance la soumission une fois ; si la première avait partiellement abouti, des extraits antérieurs peuvent s’exécuter à nouveau. Les écritures et les appels sortants doivent tolérer un rejeu.
Six limites à connaître
- Le sandbox n’est pas isolé du réseau. L’application
flmboxintégrée démarre avec--network=host: le code atteint donc tout ce que le worker atteint, services internes compris. L’isolation est un changement de configuration du cluster, pas un défaut. - Le système de fichiers racine est en lecture seule. Seul
/tmpest inscriptible ; exportez ce dont vous avez besoin avant la fin de la session. - Ni le sandbox ni la session ne se ferment seuls. Les identifiants dérivent de l’adresse MAC de la machine (
hermes-sandbox-<mac>,hermes-session-<mac>), ils persistent donc à travers les redémarrages de Hermes — et le plugin ne les ferme jamais. Nettoyez côté cluster avecflmctl list -s,flmctl close -s <id>,flmctl delete -s <id>. Changer d’adaptateur réseau ou passer le portable en station d’accueil modifie la MAC, ce qui change le sandbox et fait perdre les anciens fichiers. - Un sandbox fermé bascule sur un nouvel identifiant. Réutiliser un identifiant fermé ouvre
...-1,...-2, et les fichiers précédents ont disparu. - Effacez les variables de proxy sur le bon processus. Les appels au SDK héritent de l’environnement du processus qui les exécute. Avec un gateway persistant, modifier le proxy dans votre CLI ne touche pas l’environnement que le gateway a déjà hérité.
- Il n’y a pas d’isolation entre locataires. C’est un outil pour votre propre cluster, pas un service multi-locataire.
Quand ne pas l’utiliser
- Les petits calculs ponctuels. Un
execute_codelocal demande moins de cérémonie qu’un aller-retour RPC. - Le travail sur GPU. Les mesures publiées portent toutes sur des workers CPU ; il n’existe pas de chemin GPU.
- Le code non fiable qui exige une vraie isolation. Le réseau en mode hôte par défaut en fait une mauvaise idée.
- Vous avez une machine et pas de cluster. Ce que vous voulez en réalité, c’est un backend de conteneurs local — voyez l’article sur le sandbox Docker ou les options du guide des plugins de terminal backend.
Comment lire les chiffres de performance
L’auteur a mesuré dans son propre cluster, avec sa propre image — prenez ces valeurs comme des points de repère, pas comme des promesses : médiane de première allocation d’un sandbox à 148 ms avec un executor et un service neufs, 79 ms avec un executor conservé ; appels à chaud autour de 26 ms pour Python et 8 ms pour shell, et environ 24 ms / 8 ms pour une session à un seul worker. Aucun chiffre d’accélération parallèle n’est fourni — l’article précise explicitement que le débit n’a pas été mesuré, ne citez donc pas ces nombres comme « plus rapide qu’en local ». L’intérêt de l’exécution distante, c’est la capacité et l’isolation, pas la latence par appel.
État actuel
hermes-flamepy en est à la version 0.2.0 et ne figure pas dans le catalogue officiel : il s’installe depuis Git avec les trois commandes ci-dessus. Il déplace l’exécution vers le cluster mais laisse le jugement — ce qui peut tourner en parallèle, ce qui doit rester séquentiel — à vous et au modèle. C’est la même répartition du travail que dans les backends de délégation enfichables : l’outil expédie le travail, l’orchestration reste votre affaire.