Un fichier laissé par votre agent dans Docker peut s'exécuter en root sur votre laptop
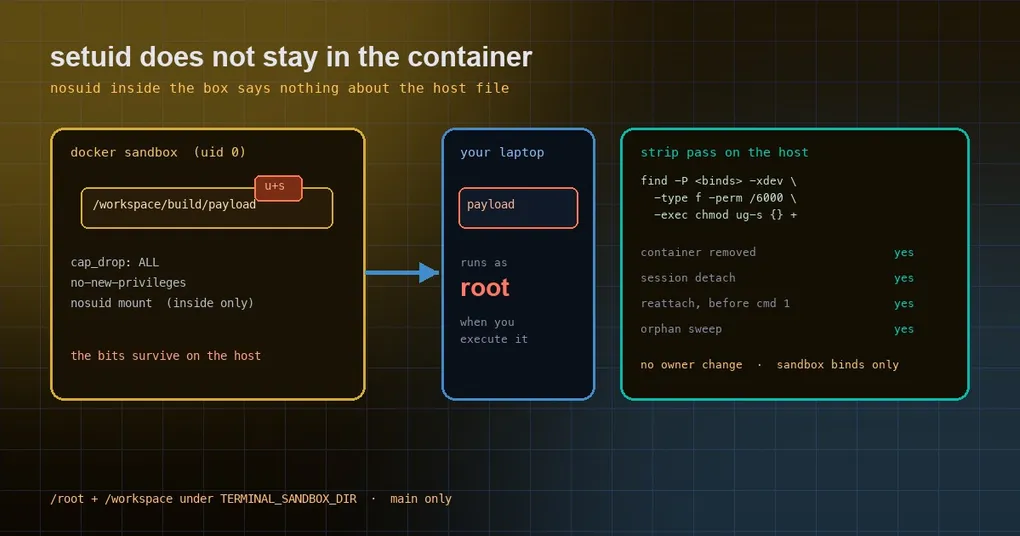
Vous demandez à l’agent de construire quelque chose dans un sandbox Docker. Il installe les dépendances, compile, empaquette, et dépose l’artefact dans /workspace/dist/ — un bind mount qui est en réalité un répertoire de votre machine. Le lendemain, vous lancez cet artefact en local et il s’exécute en root, écrivant où ça lui chante.
Le mécanisme est banal. Les conteneurs Docker tournent en root par défaut, donc les fichiers qu’ils écrivent dans un bind mount appartiennent à root sur l’hôte. Si l’un de ces fichiers porte des bits setuid/setgid ou des file capabilities, l’exécuter sur l’hôte transporte l’escalade de privilèges avec lui. Le montage nosuid du conteneur, --cap-drop ALL et no-new-privileges n’y changent rien : ils contraignent les process à l’intérieur du conteneur, pas les bits de permission d’un fichier posé sur votre système de fichiers.
Pourquoi le durcissement du conteneur ne suit pas le fichier
| Durcissement | Ce qu’il contraint | S’applique-t-il à un fichier de l’hôte ? |
|---|---|---|
--cap-drop ALL |
Les process à l’intérieur du conteneur | Non |
Montage nosuid |
La vision qu’a le conteneur de ses montages | Non |
no-new-privileges |
Les exec à l’intérieur du conteneur |
Non |
Le mode du fichier lui-même (u+s, g+s, file caps) |
Quiconque l’exécute | Oui — de l’autre côté de la frontière |
La dernière ligne dit tout. setuid est un attribut de fichier, pas un attribut de conteneur. Quand le conteneur écrit dans un bind mount, les bits partent avec le fichier ; supprimez le conteneur et les bits restent. La seule défense fiable consiste à les retirer côté hôte — chmod ug-s plus l’effacement des file capabilities — plutôt qu’à confier la tâche aux options de montage.
Ce que Hermes a changé
Le changement vit dans tools/environments/docker_ownership.py, et l’ordre est délibéré : rendre d’abord la propriété, retirer ensuite les bits.
- L’ordre. Au teardown, la restitution de propriété passe en premier — son
chownefface déjà bits et capabilities sur tout ce qui appartient à root. Une passe de strip séparée s’exécute après, et chaque étape dispose de son propre budget de 10 secondes pour qu’une arborescence énorme ne puisse pas affamer la restitution. - Comment fonctionne le strip. Un conteneur jetable durci exécute :
find -P <sandbox-binds> -xdev <prune-nested-mounts> \
  -type f -perm /6000 -exec chmod ug-s {} +
Il ne change aucun propriétaire et n’a pas besoin de stat, ce qui le rend utilisable sur des images qui n’ont jamais embarqué /bin/stat (bullseye-slim) ; testé sur GNU findutils et busybox.
- Les file capabilities.
findne sait pas tester les xattrs. Quand le conteneur a reçuSETFCAP,ALL, ou tourne en--privileged, le même conteneur jetable re-chownchaque fichier régulier vers son propre uid (uids lus une fois, un parcours par propriétaire), ce qui efface les caps sans laisser un propriétaire différent derrière lui. Les arguments de base retirentSETFCAP, donc le chemin par défaut reste sur le strip bon marché. - Les sandbox persistantes sont couvertes aussi. C’était la vraie lacune de la passe précédente (#141033) : elle ne s’exécutait que lorsqu’un conteneur était supprimé, et le sandbox persistant par défaut n’est jamais supprimé. Le strip tourne désormais également :
- quand une session se détache d’un conteneur persistant (
cleanup()en mode persist, sur le thread de teardown vidé à l’atexit) ; - avant la première commande après une ré-attache ;
- dans
reap_orphan_containers, avant la suppression d’un conteneur sorti.
- quand une session se détache d’un conteneur persistant (
- Le périmètre est serré. Les cibles du strip viennent des montages du conteneur dans
docker inspect, et ne sont retenues que sirealpath(Source)se trouve sous un root<sandbox>/dockerque l’hôte dérive lui-même — son propre répertoire de sandbox, ou celui par défaut de la racine Hermes et de chaqueprofiles/*. Cela couvre les profils qui partagent un conteneur. Les labels du conteneur et les autres métadonnées n’élargissent jamais l’ensemble, car des arguments supplémentaires et desLABELd’image peuvent les définir. - Le montage. Seuls ces répertoires de sandbox sont montés, par leur chemin résolu, avec
--mount type=bind(une source manquante est ignorée, jamais recréée avec root comme propriétaire). Pas de--volumes-from, donc un chemin remplacé en cours de parcours ne peut mener qu’à des fichiers du sandbox. - Les échecs ne sont pas silencieux. Un strip impossible (outil manquant, code de sortie non nul, timeout) écrit un WARNING avec le chemin du sandbox, une fois par sandbox.
Les parties qui n’ont pas changé comptent autant : find -P ne suit jamais les symlinks, les montages imbriqués sont élagués, l’environnement PATH/loader est réinitialisé, --cap-drop ALL avec seulement CHOWN/DAC_OVERRIDE/FOWNER, no-new-privileges, les device nodes et FIFOs intacts, le tout en best-effort. L’ensemble du mécanisme est conditionné à Linux, à Hermes non-root, à un Docker non-rootless et à l’absence d’userns-remap.
Vérifiez votre propre machine (dix minutes)
Si votre build précède le correctif, vous pouvez contrôler et nettoyer à la main. Commencez par récupérer les vrais chemins de montage :
docker ps --format '{{.ID}}  {{.Image}}  {{.Names}}'
docker inspect <container> --format '{{range .Mounts}}{{.Source}} -> {{.Destination}}{{"\n"}}{{end}}'
Cherchez ensuite les fichiers privilégiés sur l’hôte :
find -P <that Source path> -xdev -type f -perm /6000 -printUne sortie signifie une exposition réelle. Retirez les bits à la main :
find -P <that Source path> -xdev -type f -perm /6000 -exec chmod ug-s {} +Puis contrôlez les file capabilities (il faut les outils libcap ; beaucoup d’hôtes slim ne les ont pas) :
getcap -r <that Source path>
setcap -r <file path>
Ce sont des formes Linux — -perm /6000 de GNU find signifie « au moins un de ces bits est positionné ». Sur macOS avec Docker Desktop, le comportement de mapping diffère et les fichiers de l’hôte vous appartiennent normalement, donc l’exposition est plus faible ; les machines qui comptent vraiment sont les serveurs de production Linux, les runners CI et les serveurs de dev partagés.
Trois décisions que vous pouvez prendre aujourd’hui
1. Attendre la mise à jour, ou nettoyer maintenant. Le changement a été fusionné sur main le 18 octobre 2026 — après la sortie de la v0.22.2 le 15 octobre — donc la release actuelle ne l’a pas. Votre prochain hermes update le récupère automatiquement ; il n’y a aucun flag à activer, c’est le comportement par défaut.
2. À plus long terme : faire tourner le conteneur avec votre utilisateur. Si le sandbox se contente de modifier des fichiers montés plutôt que de faire des apt install, cela supprime les fichiers appartenant à root à la source :
terminal:
  backend: docker
  docker_run_as_host_user: true   # default: false
Le compromis est documenté : le conteneur ne peut plus écrire dans des chemins appartenant à root comme /root/.npm, il vous faut donc une image dont le HOME appartient à un utilisateur non-root si vous avez besoin des deux. Plus de détails dans la section Docker de la documentation de configuration.
3. N’exécutez pas les artefacts du sandbox sur l’hôte. Conseil indépendant de la version : du code auquel vous ne faites pas confiance retourne dans un conteneur ou une VM jetable. Retirer les bits évite les accidents, pas les builds malveillants.
Pas un patch isolé
#141033 puis #141086 mènent à un point plus large : une garantie d’isolation ne couvre que l’intérieur de la frontière d’isolation. À l’instant où un fichier sort du conteneur et atterrit sur le système de fichiers de l’hôte, tous les flags de durcissement cessent de s’appliquer. Tout backend qui laisse un agent écrire sur votre machine — bind mounts Docker, hôtes SSH distants, répertoires de sandbox cloud synchronisés — doit répondre à la même question : quelles permissions cet artefact transporte-t-il quand il arrive du côté de confiance ?
Si vous construisez ce genre de montage, deux briques voisines valent la lecture : partager un conteneur Docker entre sessions traite de la frontière d’isolation quand plusieurs chats partagent un conteneur, et comment les médias du sandbox sont livrés couvre le déplacement des artefacts à travers cette frontière. Vous installez Hermes pour la première fois ? Le guide d’installation indique comment activer chaque backend.
Résumé
- Symptôme : des fichiers écrits dans un bind mount arrivent sur l’hôte en portant setuid/setgid ou des file capabilities, donc les exécuter escalade les privilèges.
- Cause : ce sont des attributs de fichier ;
nosuid,cap-dropetno-new-privilegescôté conteneur ne peuvent pas atteindre l’hôte. - Correctif : une passe de strip côté hôte (
chmod ug-splus un échange de propriétaire pour les capabilities) au teardown, au détachement, à la ré-attache et lors du balayage des orphelins, limitée aux répertoires de bind mount des sandbox. - Aujourd’hui : trouvez vos montages avec
docker inspect, auto-contrôlez avecfind -perm /6000, attendez la mise à jour ; à plus long terme, utilisezdocker_run_as_host_userou gardez les artefacts non fiables hors du shell de l’hôte.