hermes update se cuelga, miente sobre estar al día o rechaza tu CA: cuatro correcciones ya disponibles
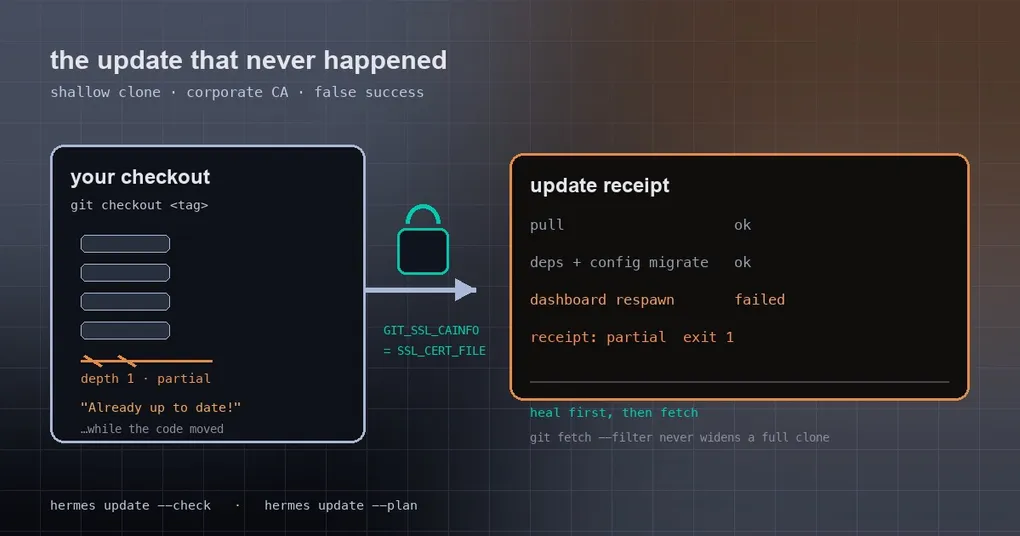
Es viernes por la tarde y escribes hermes update antes de desconectar. La pantalla se aparca en Fetching... y no se mueve en diez minutos. Haces Ctrl+C, pruebas en otra máquina y esta vez responde al instante: Already up to date!, salvo que después de reiniciar hermes --version sigue mostrando la versión antigua. La peor variante es la tercera: sí mueve el código, no informa de nada raro y tú das por hecho que estás al día.
Esas tres experiencias vienen de cuatro bugs distintos, todos fusionados en main el 2026-09-28. Ninguno afecta a tus conversaciones diarias, pero cada uno rompe justo la operación a la que recurres cuando más la necesitas. Aquí va qué los dispara, cuál era la causa raíz y qué hace ahora el actualizador.
1. Clones shallow: la actualización se cuelga en el fetch hasta agotar el timeout
El instalador clona con --depth 1 para ahorrar tiempo: solo el historial del commit más reciente. Eso va bien justo hasta que el checkout se queda lo bastante atrás.
Desde un clon de profundidad 1, un simple git fetch origin main hace que el servidor envíe toda la ascendencia de cada rama lateral fusionada más allá de la frontera shallow. Esa descarga no puede terminar dentro del límite de red de 300 segundos. Y el paso de unshallow que lo habría arreglado estaba programado después de una actualización correcta, así que nunca llegaba a ejecutarse: timeout, actualización fallida, sin unshallow y el mismo timeout la próxima vez.
Ahora ocurre al revés: antes del fetch acotado, heal_shallow_history rellena el grafo de commits (solo commits, con un presupuesto de 900 segundos, y se trae también la rama destino), de modo que el fetch con límite que viene después es realmente pequeño.
El mismo lote arregla dos fallos más sutiles:
- Crash de
index-pack --promisoren git 2.53+. Con ciertos objetos locales,pack-objectsdispara unBUG()interno. El daño es que el estado persiste en el repositorio, así que cada fetch posterior —la comprobación de versión y la actualización en sí— muere en él. La corrección es deliberadamente estrecha: ante exactamente esa firma de crash, reintentar una vez con-c remote.origin.promisor=, en cada invocación y sin tocar la configuración del repositorio. --filter=tree:0convertía clones completos en parciales sin avisar. El actualizador pasaba ese filtro en cada fetch de tags, ygit fetch --filterescriberemote.origin.promisorypartialclonefiltercomo efecto secundario, así que un clon completo y sano acababa convertido en un clon parcial y cada fetch posterior arrastraba una dependencia promisor. Los fetch de tags ahora reutilizan el filtro del propio clon: un clon parcial repite su filtro y un clon completo hace fetch sin filtro.
Dos comandos te dicen si estás en ese tipo de máquina:
git rev-parse --is-shallow-repository      # true significa shallow
git config --get remote.origin.partialclonefilter
2. Decía «Already up to date!» mientras el código acababa de cambiar
Este es más feo: crees que no ha pasado nada, cuando en realidad el pull sí ocurrió y se saltaron la sincronización de dependencias, la migración de configuración y el reinicio del gateway.
El disparador es un checkout detached, por ejemplo porque antes hiciste un rollback con git checkout <tag>. En ese estado el actualizador cambiaba HEAD a main y después contaba HEAD..origin/main. Tu main local ya apuntaba a origin/main, así que la cuenta daba cero: imprimía Already up to date! y salía, aunque el código que estabas ejecutando de verdad acababa de ser reemplazado. Ahora la cuenta parte del commit que realmente estaba en ejecución.
La ruta de rollback estaba mal de la misma forma. Si la actualización terminaba con un error de sintaxis, ejecutaba git reset --hard sobre la rama de actualización: alguien en detached acababa aparcado en main, y los commits de una rama de trabajo aparcada se escribían sobre main. Ahora se divide en dos casos:
- checkout detached:
git checkout --detach <sha>, de vuelta al commit desde el que arrancó la actualización; - rama aparcada:
git checkout <branch>, dejandomainen paz. Si otro worktree tiene esa rama, su commit se restaura en detached.
Una regla cubre los dos casos: una actualización fallida nunca deja tu instalación sobre código roto.
3. Detrás de una red corporativa, SSL_CERT_FILE nunca llega a git
Si tu CA raíz se distribuye mediante la variable de entorno SSL_CERT_FILE, tienes una doble personalidad: la comprobación de versión (Python) funciona y git fetch falla por TLS todas las veces. El motivo es aburrido: libcurl de git no lee SSL_CERT_FILE. Solo respeta GIT_SSL_CAINFO o un http.sslCAInfo configurado.
La corrección mapea SSL_CERT_FILE a GIT_SSL_CAINFO una vez por actualización o comprobación, en el entorno del proceso y no en los argumentos de un comando concreto, de modo que los fetch perezosos de promisor que hace un clon parcial también reciben la CA. Si defines GIT_SSL_CAINFO explícitamente, o tienes http.sslCAInfo en tu configuración de git, tu ajuste gana.
El mismo lote permite que hermes pm install funcione detrás de un mirror npm interno, que antes fallaba cuando no podía alcanzar la URL pública fijada en el lock file.
Tus dos comprobaciones:
echo "$SSL_CERT_FILE"
git config --get http.sslCAInfo
4. Fallos contabilizados como éxitos
Los tres primeros son «el trabajo no se hizo». Este es «no se hizo y te dijeron que sí», que es lo que de verdad te arruina la tarde.
Una escritura rechazada del .env imprimía ✓ Set igualmente. Cuando hermes config set guarda credenciales de provider pasa por la ruta de escritura del .env, y esa ruta, al detectar un conflicto de lock, antes imprimía una línea y volvía. Quien la llamaba nunca comprobaba el resultado: seguía limpiando los valores duplicados de config.yaml, imprimía ✓ Set y salía con 0, y tú creías que la credencial estaba guardada. Ahora los cuatro escritores multi-almacén llaman a require_env_writable antes de cualquier efecto secundario: el CLI sale con 1, PUT/DELETE /api/env responde 400 con el motivo y el model.disconnect del TUI comprueba cada variable de antemano.
Un dashboard que no volvía se registraba como restarted. Durante una actualización, Hermes toma el control y reinicia un dashboard que habías arrancado a mano. Replicaba tal cual el argv de /proc del proceso detenido —incluida una ruta de lanzador que la toma de control ya había reescrito a un shim de shell—, así que el hijo moría al instante con SyntaxError. Popen en sí tenía éxito, así que el actualizador imprimía ✓ restarted de todos modos. Ahora el argv se reconstruye sobre el lanzador ligado a la instalación que usa cualquier otro spawn de Hermes, un hijo que sale en menos de un segundo cuenta como reinicio fallido, y un dashboard que nunca vuelve convierte todo el recibo de actualización en partial con código de salida 1.
Mira antes de saltar: dos comandos de solo lectura
hermes update --check    # ¿hay una versión más nueva? (no cambia nada)
hermes update --plan     # plan de solo lectura: tipo de instalación, todos los procesos de Hermes en todos los profiles, cómo se reiniciará cada uno
--plan es el compañero natural de estas correcciones: imprime lo que va a tocar la actualización y no cambia nada, así que es seguro ejecutarlo en un host multi-profile en vivo. Los otros flags que conviene conocer son --no-gateway-restart (cambiar el código sin reiniciar el gateway), --keep-stash y --backup / --no-backup.
Qué tienes que hacer
Nada. Los cuatro parches están en main; tu próxima hermes update los recoge. Si tu máquina es un clon shallow o está detrás de una CA corporativa, resiste esta vez las ganas de hacer Ctrl+C: dale tiempo para rellenar el historial. Después, hermes doctor es una buena forma de confirmar que las dependencias, la versión de configuración y los procesos en ejecución están todos alineados.
Si el flujo de actualización en sí sigue sin quedarte claro, empieza por nuestra guía paso a paso de actualización y por cómo conservar las skills y la configuración de tu profile durante una actualización. Conviene saberlo: esta misma actualización es la que por fin elimina la capa de compatibilidad de plugins. Si tu plugin todavía importa una ruta antigua, lo descubrirás justo después. ¿Prefieres montarlo desde cero? La guía de instalación cubre todas las plataformas.