Solo abriste esa skill de la comunidad — y ejecutó un comando de shell
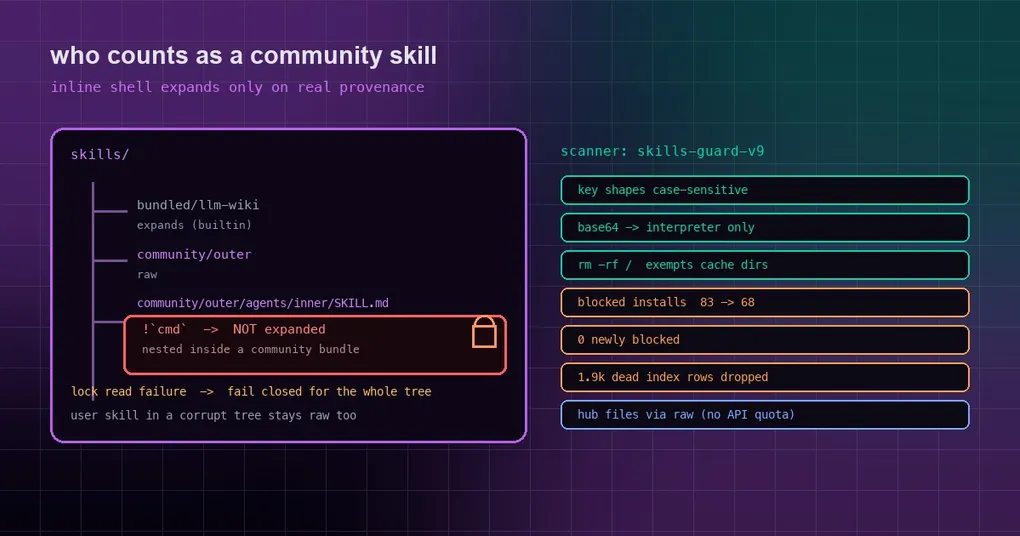
Instalas una skill desde un hub comunitario, echas un vistazo a la línea de éxito y sigues con lo tuyo. Semanas después la abres en una sesión solo para leer qué hace realmente — y esa mirada era la parte peligrosa: abrir la skill bastaba para ejecutar su fragmento de inline-shell. No ejecutaste ningún comando. El comando se ejecutó igual.
El problema nunca fue «el escáner se dejó algo». Fue que la pregunta «qué cuenta como skill comunitaria» se respondía con demasiado optimismo. Se endurecieron cuatro fronteras de confianza a la vez, y el mismo lote limpió un montón de falsos positivos más dos instalaciones que nunca podían tener éxito.
Qué es el inline shell y cuándo se ejecuta de verdad
El cuerpo de una skill de Hermes puede contener un fragmento de inline-shell: un marcador !`cmd` dentro de SKILL.md. Cuando abres o cargas esa skill, el comando se expande a través de bash -c y su salida se inyecta en el cuerpo de la skill, lo que permite que una skill lleve datos en vivo — la rama actual, un timestamp, un contador.
Está desactivado por defecto:
hermes config get skills.inline_shell # False por defectoLo activas en config.yaml:
skills:
  inline_shell: true
  inline_shell_timeout: 10   # segundos por fragmento
La trampa está en que inline_shell: true es un interruptor que arma de golpe todas las skills instaladas. Así que lo que decide si un fragmento se ejecuta de verdad no es el veredicto del escáner, sino la respuesta del runtime a «¿es esto una skill comunitaria?». Esa respuesta es lo que ha cambiado.
Los tres agujeros de la respuesta antigua
La antigua comprobación _is_community_hub_skill se apoyaba en tres suposiciones, y las tres eran optimistas:
- Solo coincidía con un directorio exactamente igual a la ruta de instalación registrada. Una skill anidada dentro de un bundle comunitario — por ejemplo
agents/inner/SKILL.md— no contaba como comunitaria en absoluto. - Solo leía el lock del hub del perfil activo. Cuando otro perfil llegaba a la misma skill a través de
skills.external_dirs, la procedencia vivía en el lock de otro y la comprobación quedaba vacía. - Un lock que no podía leer se trataba como «no comunitaria». Este era el peor: un
.hub/lock.jsontruncado o malformado convertía de nuevo todas las skills de ese árbol en confiables — un valor por defecto fail-open.
Este es el antes y el después:
| Caso | Antes | Ahora |
|---|---|---|
| Una skill anidada dentro de un bundle comunitario | Se expandía | Se queda sin expandir |
Otro perfil que llega a ella vía external_dirs |
Se expandía | Se queda sin expandir |
El .hub/lock.json del árbol, truncado o con forma incorrecta |
Se trataba como no comunitaria, se expandía | Todo el árbol falla en cerrado |
| Ningún lock en absoluto (sin instalaciones de hub en esta máquina) | No se expandía | Sin cambios |
La comprobación ahora tiene dos reglas firmes: coincide con el directorio de instalación o con cualquier directorio bajo él (sobre rutas ya resueltas), y lee el lock del perfil activo y el lock que es dueño del árbol de skills en el que vive el directorio — el ancestro más cercano llamado skills/ que lleve un .hub/lock.json. En otras palabras, quién está mirando la skill ya no cambia lo que se considera que es.
El trade-off está documentado a propósito: mientras el lock de un árbol esté corrupto, las skills que escribiste tú mismo en ese mismo árbol también dejan de expandirse. Un lock roto no puede decirnos qué directorios son instalaciones comunitarias, así que todo el árbol falla en cerrado hasta que se repare el lock.
El otro lado del escáner: skills-guard-v9 corrige falsos positivos
Un artículo anterior cubrió los puntos ciegos del escáner. Este lote arregló el fallo opuesto — bloquear demasiado.
Primero los datos. A lo largo de 14 días de clientes nuevos, scan_blocked fue la razón número uno por la que fallaban las instalaciones de skills del hub (hermes-index 39 eventos en 8 días-instalación, clawhub 19/15, skills-sh 5/4, url 6/4). Todos esos son fallos reales — la instalación fue rechazada. La causa no era contenido peligroso; era coincidencia de patrones imprecisa. En una muestra aleatoria de 89 entradas del índice, aproximadamente 10 de 13 bloqueos eran falsos positivos de patrón.
Una causa raíz es un clásico: toda la tabla de reglas se compilaba con re.IGNORECASE, así que la regla de claves de AWS AKIA[0-9A-Z]{16} coincidía con el placeholder AKIAxxxxxxxxxxxxxxxx. Del mismo modo, rm -rf /, base64 -d |, setuid y la inyección por comentarios HTML saltaban con la limpieza de caché de un Dockerfile, con | jq, con prosa normal y con comentarios de maquetación.
Tras el arreglo, en una muestra aleatoria de 421 skills reales del índice, las instalaciones bloqueadas bajan de 83 a 68 — 33 desbloqueadas, 0 bloqueadas nuevas — y todo ataque fabricado sigue bloqueándose.
En concreto, el escáner ahora:
- trata las formas de clave como sensibles a mayúsculas —
AKIA,ghp_/github_pat_,sk-,sk-ant-,glpat-,BEGIN PRIVATE KEYya no coinciden con placeholders todo en minúsculas; - exime la limpieza de caché de paquetes de la regla
rm -rf /(/var/lib/apt/lists,/var/cache/apt|apk|yum|dnf) a la vez que revisa cada operando — lo que además pillarm -rf --no-preserve-root /, que antes se escapaba; - acota los pipes de
base64 -d: solo saltan cuando los bytes decodificados llegan a un intérprete en cualquier etapa posterior (sh/bash/python/perl/node/eval/xargs/env/sudo/iex/pwsh), o se alimentan directamente a| tar(un payload embebido que el escáner nunca ve). Los consumidores de datos como| jqy| grepya no saltan; - exige fraseología de inyección para los comentarios HTML — «ignore previous instructions», system prompt, instrucciones ocultas — en lugar de saltar con cualquier comentario;
- solo trata setuid como crítico en llamadas reales (
set*id(,cap_set[ug]id,chmod u+s,g=s, octal 2xxx–7xxx); la palabra suelta pasa a ser una nota. Esto además pillachmod 4755, que la regla antigua se dejaba; - salta con
curl … | sudo -E bashcomo curl-pipe-shell, donde la regla antigua solo reconocía| bash; - sube la versión del escáner a
skills-guard-v9(yplugin-guard-v10para plugins), lo que invalida los veredictos en caché, así que todo se vuelve a escanear.
Un detalle merece repetirse: el cambio introdujo su propia regresión, arreglada al día siguiente. Cuando la regla empezó a revisar cada operando de rm, un comentario // al final se leía como una ruta con raíz en /, así que rm -rf node_modules dist // clean salía como crítico. El arreglo evita que un // suelto después del primer operando cuente como raíz, mientras que rm -rf // y rm -rf //etc siguen siendo críticos. Un reescaneo de una muestra en caché de 633 skills produjo idéntico veredicto, idéntica decisión de instalación y idéntico conjunto de hallazgos.
Las 1.900 filas del índice que nunca podían instalarse
Si alguna vez elegiste una skill del índice y la viste fallar, el fallo probablemente se parecía a stale_index — y el cliente ya se había gastado unas 40 llamadas a la API de GitHub para llegar hasta ahí.
La causa es mundana: skills.sh alberga unas 20.000 filas, y alrededor de 1.920 a 1.985 de ellas se publican sin ningún resolved_github_id — ninguna ubicación descargable. El constructor del índice trataba como una sola cosa tres situaciones realmente distintas: un repositorio 404, un árbol que se leía bien pero no contenía ninguna skill coincidente, y un árbol truncado. Las tres se publicaban tal cual. Su coincidencia difusa además eliminaba - pero no _, y nunca manejaba el formato de skill única, donde el único SKILL.md de un repo está en la raíz — aunque el cliente sí instala esos.
El constructor ahora distingue ok / truncated / gone (repo 404) / error; normaliza ambos lados con [-_] (así pdb-database coincide con pdb_database); y resuelve repos cuyo único SKILL.md está en la raíz o en un directorio genérico skills/, .agents/skills/ o .claude/skills/. Las filas de un repo desaparecido, y las filas sin coincidencia en un árbol completo, se descartan. Para árboles truncados (posthog/posthog tiene 58k entradas) sondea rutas candidatas, con un tope de 10 filas por repo. Un error — 5xx, timeout, auth — deja sus filas sin resolver, así que un fallo transitorio nunca borra nada. El log de build ahora imprime una línea que vale la pena buscar con grep: Resolved N/M paths, dropped D uninstallable (G repo gone, R not in repo).
Una muestra de 75 filas lo hace concreto: el constructor antiguo publicaba 75 (27 de ellas sin resolver); el nuevo publica 57, con 0 sin resolver y 18 descartadas (3 repos desaparecidos, 15 donde la skill no está en el repo).
Dos instalaciones que nunca podían tener éxito, ya arregladas
Las restauraciones de built-ins fallaban para siempre. Si borrabas una skill pero quedaban archivos en su directorio, o una copia anterior murió a medias, te quedabas con un directorio sin SKILL.md — y cada reintento devolvía [Errno 17] File exists. Un segundo formato también lo rompía: cuando el directorio de categoría es un symlink, el cargador sigue el symlink y la skill funciona, pero el rglob de la restauración no desciende por él, así que la guarda de contención reportaba Unsafe install path. Ahora un SKILL.md canónico cuenta como presente y la copia usa dirs_exist_ok, rellenando alrededor de los restos en lugar de fallar. Una restauración fallida también se registra como source=bundled en vez de recurrir a source=hub.
Presupuesto de API anónima. Instalar una skill del hub gastaba una llamada a la Contents API por cada archivo de la carpeta de la skill. Con 60 llamadas anónimas por hora, una skill con unos 58 archivos o más nunca podía instalarse (hermes-index rate_limited: 26 eventos en 9 días-instalación en 14 días). Ahora los archivos se leen primero desde raw.githubusercontent.com/<repo>/<sha>/<path> — los mismos bytes inmutables, y no cuentan contra el límite de la API — y solo se recurre a la Contents API cuando la lectura raw falla (repo privado, caída de raw).
Qué hacer ahora
- Revisa el interruptor de inline-shell:
hermes config get skills.inline_shell. Déjalo desactivado a menos que lo necesites — es la línea defensiva más barata que tienes. - Recuerda que los veredictos en caché se invalidaron: la versión del escáner cambió, así que las skills se vuelven a escanear en el siguiente acceso. Todo lo que se bloqueó por error merece un reintento.
- En despliegues compartidos, asegúrate de que el
.hub/lock.jsonde cada perfil se parsea bien. Un solo lock corrupto ahora deshabilita el inline shell para todo su árbol hasta que se repare. - No recurras al bypass por reflejo.
hermes skills install --forceignora un veredicto bloqueado, y existe para el caso en que hayas revisado el contenido tú mismo — no para «el escáner otra vez está pesado».
La versión corta
El hilo que recorre este lote es que la confianza pasó de una suposición estática a una decisión de procedencia: de dónde vino una skill, qué lock registra su instalación y quién la está mirando importan más que si el directorio resulta parecerse a una instalación comunitaria. Cuando la respuesta no está clara, todo falla en cerrado — incluida la consecuencia algo molesta de que un lock corrupto deshabilita temporalmente el inline shell para todo un árbol de skills hasta que lo arregles.
Para el contexto, empieza por nuestro artículo sobre los tres puntos ciegos del escáner y luego por la referencia del comando hermes skills. Si instalas skills de terceros, otros dos merecen tu tiempo: aislamiento de plugins y fronteras del host y la puerta de confianza para plugins portables y MCP. Y si prefieres elegir entre fuentes que ya se han revisado, lee cómo lo gestiona el catálogo de plugins.