全网都在聊 Jev,它到底能改变 Hermes 里的什么
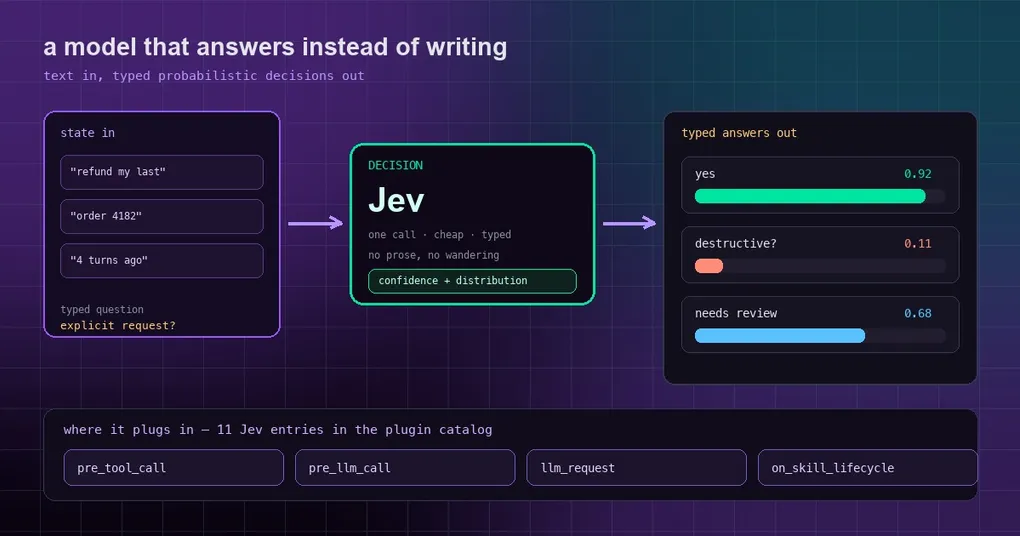
过去一周只要打开 Hacker News 或者任何一份 AI 通讯,你都会看到几十次“Jev”。它是一个不写文章的模型——它返回带置信度的决策——评价分成两派:一派说这是 LLM 的一种全新形态,另一派说这只是一个营销做得好的分类器。而你自己真正关心的问题比这两派都窄:这事跟我现在跑的这个 agent 有关系吗?
对 Hermes 用户来说,答案是肯定的,而且比你预期的更快。插件目录里已经有 11 个 Jev 条目,其中大部分是最近一周合进去的。
Jev 到底是什么
Jev 出自 TypeSafe AI,他们把这一类别叫做“System One models”;Simon Willison 的评述用了更朴素的说法——decision models(决策模型),这个说法更准确。机制本身很好讲:
- 你发过去一段文本,或者一个小而结构化的 state:一个字符串、一组字符串,或者描述一张工单、一个客户、一份 diff 的名值对。
- 你提一个类型化的问题:是/否、评分,或者在你给的一组选项里选一个。
- 它回给你数字。选择题返回的是在你给的选项上的一整个概率分布,外加一个置信度,而不是一句自然语言。
这就是全部机关,也是它对 agent 工作有意思的原因。agent 每时每刻都在做又小又枯燥的判断——这条命令危险吗、我手上四十个技能里哪个适合这一轮、这份 diff 需要第二双眼睛吗——而现在每做一次这样的判断,都要付一次完整的文本模型调用,连带着一堆你根本用不上的推理 token。
决策模型用一次便宜的调用回答,而且不会跑偏成一整段闲聊。Willison 有个说法值得记住:这个模型便宜到跑几百上千次实验性提问只要几美分,于是“试一下、量一下”这个循环才真正转得起来。同一篇评述也点出了当前的短板——数字、日期和对抗性内容都是弱项(出自 TypeSafe 自己的模型说明),所以诚实的画像是“问题要窄,答案很快,凡涉及数字都得复核”。
十一个条目,各管一件不同的事
到这里就实用了。在目录里搜一下,你会发现 Jev 散落在整个回合生命周期的各个位置上,而不是只有一个“Jev 插件”:
| 目录条目 | 维护者 | 它决定什么 | 挂在哪个钩子 |
|---|---|---|---|
jev |
ourines | 显式决策助手。给你一个 jev_evaluate 工具,只做建议,不自动拦截任何工具。 |
工具 |
jev-judge |
DoGMaTiiC | 对 terminal、write_file、patch 调用判断“破坏性 / 数据外泄 / 影响范围”,默认 shadow 模式只记录,enforce 才升级为拦截。 |
pre_tool_call |
jev-skill-router |
DoGMaTiiC | 在调用模型之前,从你当前技能名册里点出这一轮最合适的那一个技能。 | pre_llm_call |
jev-effort-router |
AlphaPerseii3000 | 逐轮同时决定模型和推理强度,并直接改写发出的请求本身。仅限 Ollama:Cloud。 | llm_request 中间件 |
jev-typesafe |
Anders Jensen-Waud | 把原子化的是/否判断、路由、评分量表等四类能力做成四个工具。 | 工具 |
jev-curator |
anpicasso | 分析完整技能包之间的关系,产出失败即关闭的合并方案。 | on_skill_lifecycle、pre_tool_call |
jev-approvals |
anpicasso | 只把 Jev 当智能审批的评审者用——其他任何任务它都拒答,出错时默认升级为 ESCALATE。 | 审批通道 |
jev-model-router、jev-mcp-router、jev-memory-selector、jev-agent-router |
Pinutss | 分别路由到模型、MCP 服务器、记忆后端和 agent,每个都打包成一个技能加一个用 uv run 启动的 stdio MCP 服务器。 |
MCP |
nerve |
keeltrace | 监督层:上下文治理、token 预算轨迹控制、看板监督、远程 SSH worker,后端可在 Jev / Laya / OpenJev 之间切换。 | 九个钩子 |
nerve 值得单独说一句:它以前叫 Hermes-Jev,上周发 v0.2.2 时改名成 Nerve。如果你记得有个名字不一样的 Jev 条目,那就是同一个项目。
装一个试试
hermes plugins search jev
hermes plugins install jev-judge
比直接 git clone 更安全的地方有两点:
- 目录名会解析到条目仓库的一个固定的 40 位 commit SHA,安装器把这段来源记录进自己的
.install-metadata.json。固定版本不会在你背后滑动;要升级必须显式用--force --ref <sha>,这也就意味着更新由你决定什么时候做。 hermes plugins search会匹配条目名、描述和声明的工具,装到磁盘上之前你就能看到这个插件自称能干什么。目录在仓库里策展,每 6 小时从线上仓库刷新一次缓存,离线时回退到内置副本。
装之前的两条规矩
进了目录不等于被审计过。 入目录审的是条目本身——元数据、披露说明、声明出来的能力——不是插件的代码。把目录安装理解成“有人认真读过它的清单”,而不是“这东西安全”。
认真读披露那一行,因为这些东西会把你的数据发出去。 每个条目都明确写了什么会离开本机,而且差别很大:
jev-judge会把每次被判断调用的工具名和脱敏后的参数(每条最多 600 字符,最多 12 个参数)发给 TypeSafe 或你配置的网关,用的是你的 key。shadow 模式下只写日志。jev-skill-router会发送你的消息(最多 4,000 字符),外加本地技能名册里的技能名和简短的SKILL.md摘录。jev-effort-router每经过一次被路由的回合,就把当前消息和最多 4 轮历史发给 OpenRouter 的 Decisions API,费用记在你的 OpenRouter key 上。nerve默认后端是托管的 Jev,会发送每轮提示(最多 12,000 字符)以及脱敏后的工具与结果预览;Laya 和 OpenJev 可以配成本地或自托管后端。
出错时的行为同样重要。jev-judge 在所有错误路径上都是失败即放行——Jev 挂掉不会挡住你的工具。jev-approvals 则是失败即关闭,宁可升级给人处理,也不放过它判断不了的命令。两种都合理,但针对你的风险模型选错了就不合理。
先装哪一个
从默认 shadow 模式的 jev-judge 开始。它每做一次判断写一行 JSONL 日志,不拦截任何东西;正常用一周,你就有真实数据知道它本来会升级多少次——在给它任何权限之前,你先把日志读一遍。
然后,忍住别堆路由。jev-skill-router、jev-effort-router、jev-model-router、jev-agent-router 都想决定“这个回合接下来干什么”;装三个就等于三个模型对同一个请求投票,最后账都算不清。只挑那个真正在花钱的路由决策。
现在的状态
这 11 个条目都是社区级插件,各自声明了最低 Hermes 版本——从 0.19 一直到 jev-effort-router 要求的 0.21.4——都是在 v0.21.4 打标签之后进的 main,所以插件目录就是它们的分发渠道,而不是某个正式版本。
Jev 还不是第一方提供商,而开放的请求说明大家希望它是:issue #113008 要求为 agent 的有界决策加一个类型化概率决策运行时,issue #113837 要求 Hermes 支持 Jev,另有一个把 TypeSafe Jev 加进模型提供商列表的 PR 还开着。在这些落地之前,插件目录就是 Jev 进入你 agent 的通道——考虑到目录会锁定 commit、会打印披露说明,作为试验起点并不差。
如果表格里那些钩子对你来说还很陌生,插件目录指南讲了条目是怎么被收录和安装的,MCP 目录安全指南则是同一主题下关于“能否信任第三方服务器”的姊妹篇。这些插件最常碰的两个开关,见推理强度指南和无人值守审批指南。