Convidados do plano gratuito deixam de receber o browser challenge para connectors: o guest token com escopo
Você deixou um job agendado em um servidor que lê o seu calendário, checa algumas listas e chama algumas managed tools no plano gratuito. Ele falhou de novo na noite passada. Não há stack trace no log — apenas um link impresso, e então o job termina em silêncio. Você clicou no link uma vez e tudo voltou ao normal, mas na semana que vem ele pode falhar às 3 da manhã outra vez.
Esse link é o browser challenge do plano gratuito. Já cobrimos por que ele aparece e como o Hermes o transformou em um fluxo não bloqueante de “imprime o link e faz polling do estado”. Isso resolveu apenas metade do problema: um convidado que não usa nada além de connectors nunca deveria ter sido obrigado a provar que é humano.
Uma mudança mesclada na janela da v0.21.7 fecha essa outra metade. Connectors e managed tools agora usam um token dedicado que nunca entra no fluxo de challenge.
Um convidado na verdade tem dois tipos de permissão
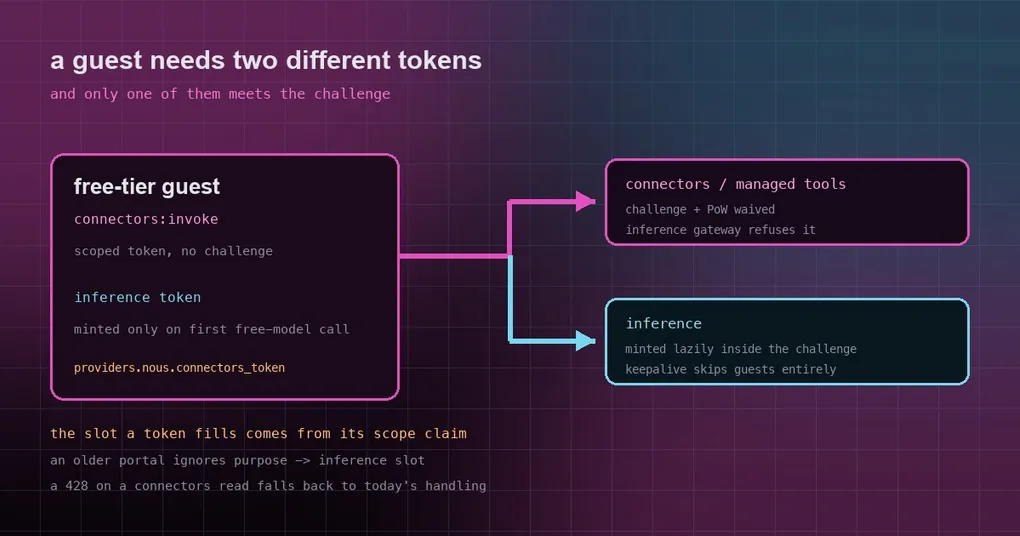
Comece pelo porquê de existirem dois tokens. No plano gratuito, um convidado pode fazer duas coisas bem diferentes:
- Chamar inferência — fazer um modelo gratuito gerar algo. Isso gasta computação.
- Chamar connectors e managed tools — ler a conta, bater no tool gateway, passar por connectors. É basicamente encaminhamento, e não gasta cota de inferência.
O challenge, incluindo o portão de proof-of-work, existe para proteger a computação de abusos, então ele pertence apenas ao lado da inferência. Na implementação antiga, um convidado que tocasse em um conector ainda era arrastado por um exchange de token de inferência — e, portanto, por um challenge que ninguém precisava.
O servidor agora entende a diferença: o exchange de token anônimo aceita um parâmetro purpose, e purpose: "connectors" emite um JWT cujo único escopo é connectors:invoke. O gateway dispensa os portões de challenge e PoW para ele e recusa usá-lo para inferência.
A claim de escopo escolhe o slot, não o mint que o produziu
Este é o detalhe de design que vale lembrar: qual slot um token ocupa vem da sua própria claim scope no JWT, e não de qual mint o produziu.
- O token de connectors vive em
providers.nous.connectors_token(access_token+expires_at), logo ao lado do slot de inferência já existente. - O mint de inferência não muda: continua lazy, continua na primeira chamada real a um modelo gratuito, continua envolto no fluxo de challenge.
- Quem chama connectors agora reutiliza o token que já estiver ativo — um token de inferência também cobre connectors, então nada extra é emitido.
Ler o escopo em vez da origem mantém a compatibilidade limpa. Um portal mais antigo ignora purpose e devolve um token de inferência, que portanto cai no slot de inferência. E se esse servidor mais antigo responder a uma requisição de connectors com 428, a chamada de connectors cai no tratamento de challenge atual em vez de falhar.
Três caminhos em background que costumavam emitir inferência por acidente
Esta é a parte que deixa o debugging confuso — nenhum deles é iniciado pelo usuário:
- Auth keepalive. Ele costumava renovar o token de inferência a cada tick para qualquer convidado, e o messaging gateway e o backend do desktop o iniciam incondicionalmente. Sob enforcement, isso significava um 428 por tick para um convidado que só usa connectors, além de um challenge oculto no desktop. Agora ele pula um convidado por completo, seguindo a mesma guarda que a função de start já tinha: os tokens de um convidado são emitidos sob demanda.
- O catálogo de modelos e o pricing da Nous.
_nous_catalog(alcançado porprovider_model_ids("nous")) e_resolve_nous_pricing_credentialsrodavam em primeiro plano, então listar modelos da Nous como convidado pela CLI podia abrir um browser challenge. Ambos agora rodam como chamadores em background e caem na lista curada e no pricing público, exatamente como já faziam em uma falha de credencial. - Leituras de conta. Estas ficam do lado dos connectors, então pegam o token de connectors.
O efeito combinado: um challenge agora só aparece no momento em que você realmente chama um modelo gratuito.
O que não mudou
- Contas logadas, o caminho de inferência e o formato persistido do convidado não foram tocados.
- Um 403 (
signin_required/access_denied) em um mint de connectors aparece com o mesmo código e o mesmo texto de antes — nenhum texto novo voltado ao usuário. - Nada é compartilhado entre os dois mints, então nenhum lock por purpose nem memo com chave foi adicionado: o memo de falha do mint cobre a criação de identidade (que não tem purpose), o memo de token de 5 segundos existe apenas no resolvedor de connectors, e o estado de challenge (work lock, cooldown de desistência) só é alcançado por um mint que recebe 428 — que, em um servidor atual, é o mint de inferência.
Sabendo qual caminho uma chamada seguiu
O que você quer saber ao depurar é a quem a chamada realmente foi. Alguns lugares onde olhar:
# exchange de token anônimo e estado do challenge (identidade de convidado)
hermes logs --follow | grep -i -E "anon|challenge|connectors"

# status do lado da conta
hermes account status

# onde os slots de auth ficam (sob o home do host)
ls -l "$HERMES_HOME/auth.json"
Se você vê um link de challenge enquanto a sua carga toca apenas connectors ou managed tools, você está em um build mais antigo: a partir da v0.21.7, esse caminho não passa mais por um challenge. Se você realmente chama um modelo gratuito, um challenge é esperado — aquele post anterior é sobre impedir que ele bloqueie execuções sem supervisão.
Ressalvas
- O token dedicado não serve para inferência — o gateway o recusa. Copiar o valor de
connectors_tokenpara uma config de inferência só te dá uma falha de autenticação. - O padrão de imagem do pool gratuito não seguiu a mudança de “assinantes usam Krea por padrão”; pools de recursos ainda são decididos de forma independente.
- Em uma implantação self-hosted ou privada mais antiga, o comportamento depende daquele servidor: um servidor antigo ignora
purposee tudo fica como estava, e um 428 cai no tratamento antigo em vez de quebrar.
A conclusão
O valor aqui não é uma nova API — são permissões mais granulares. O lado que precisa que você prove que é humano (inferência) mantém o challenge; o lado de puro encaminhamento (connectors, managed tools) passa com um token de escopo limitado. Para jobs agendados sem supervisão, isso remove uma falha antes intermitente e difícil de reproduzir — não contornando-a, mas removendo o motivo de ela existir.