Um clique em Regenerar e 107 mensagens desapareceram
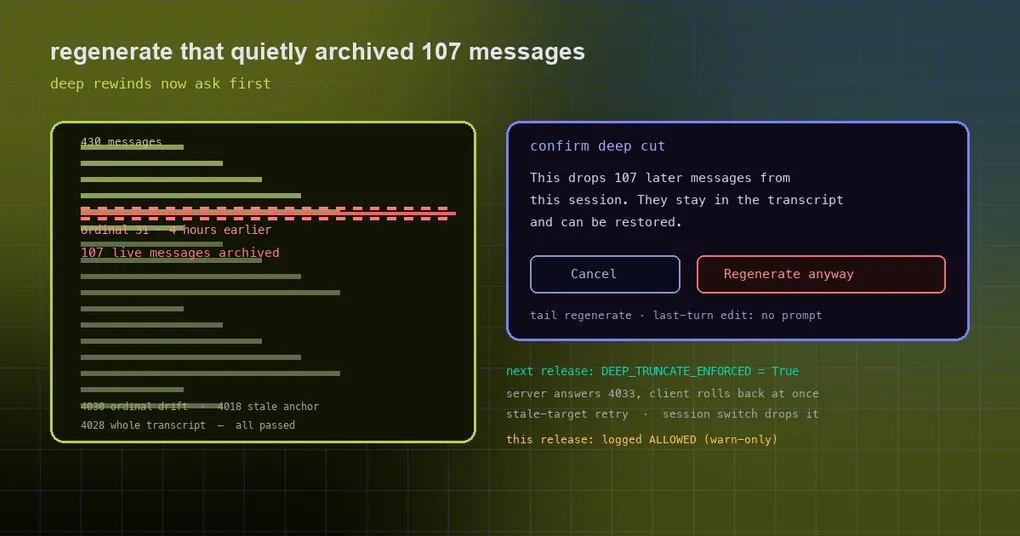
A última resposta não ficou bem certa, então você clica em Regenerar. A interface atualiza, tudo parece normal — até você rolar para cima e ver que a conversa de quatro horas atrás sumiu, junto com tudo entre aquele momento e agora. Você não apagou nada. Nunca clicou em nada escrito “clear”.
Esse caso foi reportado de verdade: um único regenerate transformou uma sessão de 430 mensagens em 323. 107 mensagens ativas foram arquivadas em silêncio, incluindo tudo o que vinha depois de um turn de quatro horas antes.
430 virou 323
O bug está na pergunta “para qual linha este regenerate está rebobinando?”.
No Desktop, regenerate e edit primeiro montam um plano de truncamento: a linha a refazer, e tudo depois dela contado como histórico. O servidor validava esse plano no envio, mas só rejeitava três casos:
- âncoras obsoletas (erro 4018);
- deriva de ordinal (4030);
- cortes de todo o transcript (4028).
O que passava pelos três: uma âncora row-id válida que apontava para uma linha muito antiga. E o caminho de regenerate do cliente confiava no próprio parentId sem perguntar. Juntos, um regenerate clicado na mensagem final podia legitimamente reproduzir o turn no ordinal 31 e arquivar as mais de cem mensagens seguintes.
Reproduzido no main, uma sessão de 430 mensagens foi reduzida a 310 no ordinal 31 sem nada no caminho. Vale dizer com clareza: a causa raiz do lado do cliente não foi reproduzida, e nenhum commit culpado específico foi identificado. Em outras palavras, mais de um caminho pode disparar esse tipo de falha — por isso a correção entrou na saída, e não em uma entrada específica.
Agora ele pergunta antes
A abordagem não é “adivinhar melhor qual turn você quis dizer”. É mostrar a consequência antes de a ação rodar.
- Regenerate (
planConfirmedReload) e edit (planConfirmedEdit) agora compartilham uma única checagem de corte profundo (confirmIfDeepCut); - Qualquer rewind que descartaria um turn de usuário visível posterior abre o diálogo de confirmação destrutiva já existente (
deepCutConfirmRequest, reaproveitando o texto do restore, então nenhuma nova string de interface foi adicionada); - O que permanece ininterrupto também está definido explicitamente: um regenerate da cauda, um edit do último turn e um edit de um turn com falha não perguntam;
- Se você recusar, nada é enviado. O restore mantém seu próprio diálogo separado.
Um diálogo pode ficar aberto por muito tempo — você saiu para tomar um café —, então mudanças nessa janela são tratadas:
- Regenerate descarta o plano se a sessão ficou busy ou seu transcript mudou;
- Edit mira de novo no transcript atual com
revalidateEditPlan, de modo que uma resposta em streaming que cresce é considerada; ele para com um aviso se o turn editado se moveu ou se chegou um novo turn de usuário posterior; - Ambos descartam a ação se você trocou de sessão.
O servidor também conta
O aviso do cliente é uma camada. O servidor agora conta de fato o que um corte descartaria: _archived_user_turns mede o corte em linhas de usuário duráveis, e cada detalhe pende para o conservador:
- Um carrier reparado conta cada linha do seu run user;user mesclado, lido das linhas físicas;
- Marcadores de display absorvidos não contam;
- Ids desconhecidos e o próprio turn de um carrier sem selo contam — fail closed em vez de contar a menos;
- Num corte de carrier durável, as linhas anteriores ao alvo sobrevivem.
Se o cliente e o servidor contarem os turns de formas diferentes, o servidor responde 4033. Quando o cliente vê 4033:
- Ele reverte imediatamente o estado otimista, já que o envio recusado não escreveu nada;
- Depois pergunta a você. Se você aceitar, regenerate ou edit roda de novo do início através dos privados
runReload/runEdit, relendo a sessão e checando-a outra vez; - O corte profundo forçado cobre só o transcript para o qual você respondeu. Qualquer mudança durante ele pergunta de novo.
A tentativa já existente de edit para alvo obsoleto (4018) também foi apertada: ela carrega a confirmação de corte profundo só quando o transcript atualizado tem o mesmo número de turns de usuário posteriores.
Esta versão apenas avisa
Uma coisa precisa ficar clara: esta versão ainda não bloqueia cortes profundos. Ela os registra.
Quando o servidor vê um corte não confirmado de mais de um turn de usuário, ele registra ALLOWED (warn-only release) e ainda assim o executa. O interruptor de aplicação é DEEP_TRUNCATE_ENFORCED; assim que a próxima versão o ativar, o mesmo corte será recusado com 4033 e o cliente seguirá o caminho de “reverter, perguntar, rodar de novo” descrito acima.
A sequência é deliberada: uma versão de dados reais sobre a frequência com que isso falha, e depois a barreira rígida — em vez de entregar a aplicação imediatamente e bloquear rewinds profundos legítimos.
Status e atualização
Essa correção (PR #133748, que fecha a issue #133716, marcada como P0) foi mesclada no main em 2026-10-11. A tag atual, v0.21.6 de 8 de outubro, não a contém; a próxima versão conterá.
Depois de atualizar, você vai notar duas coisas: muito menos cortes acidentais e uma confirmação extra de vez em quando. Esse diálogo é justamente o ponto da mudança — quando ele aparece, significa que você estava prestes a perder uma conversa que ainda não tinha lido.
Para fechar
Regenerate é o botão que as pessoas tratam como “desfazer o último passo”, quando na verdade ele significa “refazer a partir de uma certa linha, e tudo depois vira histórico”. Confundir os dois permite que um único clique perdido engula toda uma leva de trabalho. A nova regra é direta: se conversa posterior for se perder, pergunte antes. O custo de proteger uma sessão é um clique; o custo de perder 107 mensagens é você nunca descobrir o que elas diziam.
Leituras relacionadas: retomar e continuar uma sessão aborda como voltar a uma conversa, o guia de limites de sessão explica o que conta como limite de usuário, e o isolamento do embed do Desktop trata do que acontece dentro da interface e do que é dito a você sobre isso.