Une URL, deux hôtes : colmater l'écart de parser dans le garde-fou SSRF de Hermes
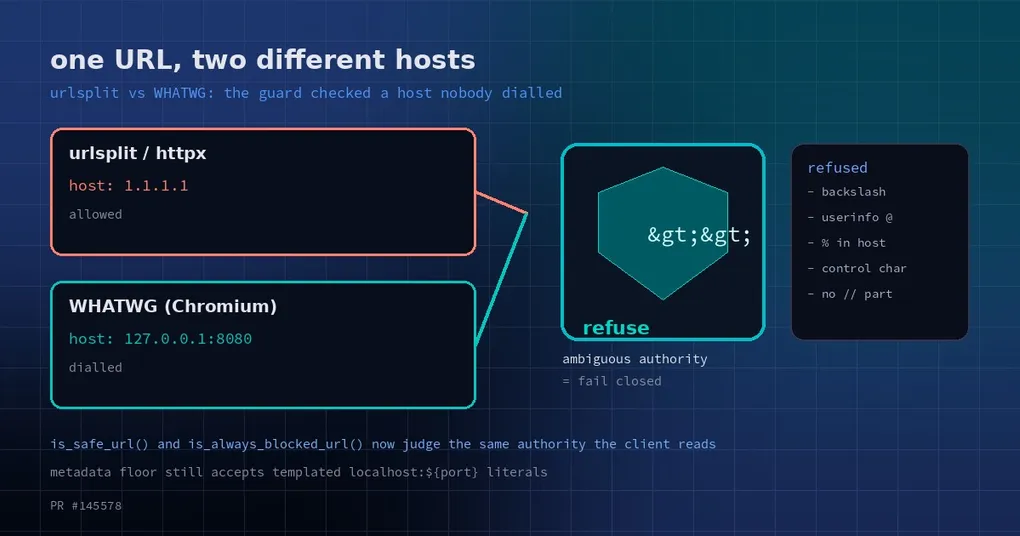
Quelqu’un dépose un lien dans vos DM et vous le passez à votre agent : récupère ça, survole, dis-moi si c’est important. Ça marche, le résumé arrive, rien ne semble bizarre. Derrière ce succès anodin, deux morceaux de code n’étaient pas d’accord sur ce que le lien désignait — le contrôle qui décide « cette adresse est-elle autorisée » et le client qui a réellement ouvert un socket. Le contrôle croyait voir une IP publique. Le navigateur lisait les mêmes caractères comme un port sur votre propre machine. La PR #145578, fusionnée le 27 octobre, comble cet écart : quand une URL admet deux lectures plausibles, Hermes la refuse désormais au lieu d’en choisir une.
Le contrôle et la connexion ne lisaient pas la même chaîne
Avant de récupérer quoi que ce soit, Hermes filtre la destination : loopback, plages privées et endpoints de métadonnées cloud sont censés être hors limites. Cette logique vit dans tools/url_safety.py, avec is_safe_url() comme décideur principal et is_always_blocked_url() comme filet de sécurité plus brutal.
Le code de filtrage parse l’URL avec urllib.parse de Python — plus précisément urlsplit. Ce qui ouvre finalement la connexion, souvent, ne le fait pas. L’outil navigateur repose sur Chromium. Les backends fetch à base de Node (un Firecrawl auto-hébergé, par exemple) et urllib3 suivent chacun leurs propres conventions. Les navigateurs suivent le standard URL du WHATWG. Donnez la même chaîne aux deux piles et vous pouvez obtenir deux hôtes différents — et l’hôte est la seule chose que le contrôle de sécurité regarde.
Quatre URL, deux réponses
La PR livre quatre cas que vous pouvez vérifier directement :
| URL | Hôte selon urlsplit / httpx | Hôte selon WHATWG | Résultat sur main |
|---|---|---|---|
http://127.0.0.1:8080\@1.1.1.1 |
1.1.1.1 |
127.0.0.1:8080 |
is_safe_url renvoie True |
http://%31%32%37.0.0.1/ |
%31%32%37.0.0.1 |
127.0.0.1 |
dépend du DNS (True derrière un proxy quand le DNS échoue) |
http://***@1.1.1.1/ |
1.1.1.1 |
169.254.169.254 |
is_always_blocked_url renvoie False |
http:\\169.254.169.254\ |
aucune | 169.254.169.254 |
is_always_blocked_url renvoie False |
La première ligne est l’illustration la plus claire. urlsplit voit le @, décide que tout ce qui précède est une paire d’identifiants, et annonce l’hôte 1.1.1.1 — public, parfait, allez-y. Chromium termine l’autorité au backslash et se connecte allègrement à 127.0.0.1:8080. Une adresse validée comme « sur internet » atterrit sur un port loopback.
La deuxième ligne est un hôte encodé en pourcentage. Le contrôle voit le texte littéral %31%32%37.0.0.1 ; le navigateur le décode en 127.0.0.1. Sur main, le verdict dépend même du DNS : avec un proxy configuré et une résolution qui échoue, la fonction renvoie True.
Les lignes trois et quatre prennent un autre chemin. is_always_blocked_url() ne bloquait ni l’une ni l’autre — et c’est la fonction sur laquelle s’appuient les chemins qui sautent is_safe_url() : le backend Chromium local et le sidecar hybride. La dernière ligne de défense pour les adresses de métadonnées avait le même trou.
Où les deux lectures divergent
Le WHATWG fait trois choses que urlsplit ne fait pas :
- Le backslash est une barre oblique. Pour les schémas spéciaux comme http, un backslash équivaut à
/, et l’autorité s’arrête au premier. Donc l’autorité dehttp://127.0.0.1:8080\@1.1.1.1n’est que127.0.0.1:8080. - L’hôte est décodé en pourcentage.
%31%32%37, c’est127. - Les barres obliques manquantes sont réparées.
http:\\hostethttp:///hostse normalisent tous deux enhttp://host.
urlsplit ne fait rien de tout ça. Il ne traite pas le backslash différemment, ne décode pas l’hôte, et considère un // manquant comme « il n’y a aucune autorité ici ». Autrement dit, « cette URL pointe-t-elle à l’intérieur de mon réseau ? » n’a pas de réponse unique — elle dépend à qui vous demandez. Le contrôle de sécurité interrogeait une pile ; le client en utilisait une autre. L’espace entre les deux, c’est le bypass.
Le correctif : refuser l’ambiguïté plutôt que la résoudre
Plutôt que d’apprendre à un parser à imiter l’autre, le patch prend la route inverse : si deux piles peuvent lire des hôtes différents dans la même chaîne, on la traite comme unsafe. Le terme consacré est fail closed — rejeter une adresse qui aurait pu être correcte, plutôt que deviner quelle lecture le client fera.
Ça vit dans un nouveau helper, _authority_ambiguity(), à la ligne 253 de tools/url_safety.py. Pour les URL http(s), il retire les espaces ordinaires de début et de fin (espace, tabulation, CR, LF, VT, FF) puis rejette l’URL si l’une des conditions suivantes est vraie :
- Un caractère de contrôle C0 ou DEL apparaît n’importe où — y compris à la fin, comme dans
http://169.254.169.254\x01, parce queurlsplitsupprime silencieusement les tabulations, CR et LF : les mêmes octets peuvent donc signifier des choses différentes des deux côtés. - L’autorité
//est absente :http:\\host,http:///host,http:host. - Un backslash apparaît n’importe où dans l’autorité.
- L’autorité contient
@(userinfo, queis_safe_url()rejetait déjà purement et simplement). - L’hôte contient
%ou un espace. - Le port est invalide — non numérique ou hors plage.
is_safe_url() l’appelle juste après le contrôle du schéma. En cas de rejet, le log n’enregistre que la raison, jamais l’URL — une URL peut porter des identifiants, et un fichier de log n’est qu’un endroit de plus où les fuiter.
Pourquoi le contrôle de secours est devenu plus permissif, pas plus strict
is_always_blocked_url() (ligne 342) sert les backends qui n’appellent jamais is_safe_url() : Chromium local et le sidecar hybride. Il ne rejette que ce qui peut faire atteindre un autre hôte à un client : caractères de contrôle, autorité // absente, backslash dans l’autorité. Les hôtes encodés en pourcentage sont jugés après décodage, donc http://%31%36%39.254.169.254/ est attrapé.
Les ports invalides, les espaces dans l’hôte et l’userinfo ne changent pas l’hôte auquel le client parle au final : le contrôle de secours les ignore délibérément. La raison est concrète : browser_exec construit ses propres URL à partir de template literals — f"http://localhost:{port}/", "http://localhost:%d/", et un `http://localhost:${port}/api` en JS — et un secours strict casserait tout ça sur le backend navigateur local. La sévérité reste là où elle doit être, dans is_safe_url() ; le secours protège la seule propriété qui compte, à savoir que l’hôte ne peut pas se lire de deux façons.
Un dernier détail, facile à manquer : les deux fonctions prennent l’hôte dans la même chaîne déjà nettoyée que celle utilisée pour le contrôle des caractères de contrôle, puis comparent l’hôte encodé IDNA à l’adresse de métadonnées après avoir ramené U+3002, U+FF0E et U+FF61 à .. L’effet pratique : http://169.254.169.254。/, les formes construites avec des points pleine chasse ou demi-chasse, et les chiffres pleine chasse se résolvent tous en 169.254.169.254 pour ce contrôle — même quand le DNS échoue et qu’un proxy est configuré.
Les URL non http(s) comme about: et data: ne sont pas touchées par le changement.
Deux notions à avoir claires
SSRF — server-side request forgery. Vous demandez à un serveur de récupérer une URL à votre place ; un attaquant fabrique cette URL pour que le serveur atteigne quelque chose qu’il ne peut pas atteindre lui-même : un port loopback, un panneau d’admin interne, une API de métadonnées cloud. Votre service devient son proxy et son point d’appui dans le réseau. Ce qui rend la chose pénible, c’est que la requête part vraiment de l’intérieur : les règles de périmètre n’ont rien à y redire — l’appelant est, par définition, « des nôtres ».
169.254.169.254 est l’adresse link-local que les fournisseurs cloud exposent sur chaque instance comme service de métadonnées. Elle ne donne pas seulement le hostname et la région ; typiquement, elle distribue aussi des identifiants temporaires au niveau de l’instance. Quiconque arrive à faire requêter cette adresse par un serveur peut repartir avec l’identité cloud de la machine, et ce que cette identité peut faire dépend du rôle attaché à l’instance. C’est pourquoi elle est traitée comme une classe d’adresses à part, jamais autorisée, plutôt que fondue dans le contrôle général des plages privées.
Empilez les deux et vous avez ce bug : une URL qui convainc le vérificateur qu’elle pointe vers l’internet public, et un hôte que le client lit comme loopback ou comme métadonnées.
Qu’en faire
- Restez à jour.
hermes update. Le changement est arrivé surmainle 27 octobre, et la PR note explicitement qu’aucune issue n’y est associée : c’est un durcissement proactif, pas un patch pour un exploit connu dans la nature. - Attendez-vous à la nouvelle sémantique : ambigu veut dire rejeté. Si votre automatisation construit volontairement des URL astucieuses de cette forme, elles seront désormais refusées. C’est l’intention, pas une régression ; les URL ordinaires ne sont pas affectées.
- Le schéma se généralise. Le correctif précédent, qui a établi que la loopback n’est pas une frontière de confiance pour le port A2A, repose sur la même idée : une décision de sécurité ne vaut que par son accord avec le composant qui exécute réellement l’action.
- Si les surfaces par lesquelles un agent peut sortir vers l’extérieur vous intéressent, lisez les recommandations de sécurité du catalogue MCP en parallèle de la surface de contrôle de l’extension navigateur — la première concerne ce que vous installez, la seconde l’autorité que détient le côté navigateur. Ce bug se situait précisément à leur intersection.
La leçon, si vous n’en voulez qu’une ligne : l’hôte que lit votre validateur doit être l’hôte que votre client contacte. Quand ce n’est pas garantissable, le fail closed est la seule réponse honnête.