Vous changez la clé, le processus garde l'ancienne : comment Hermes a corrigé un bug de cache au même tick d'horloge
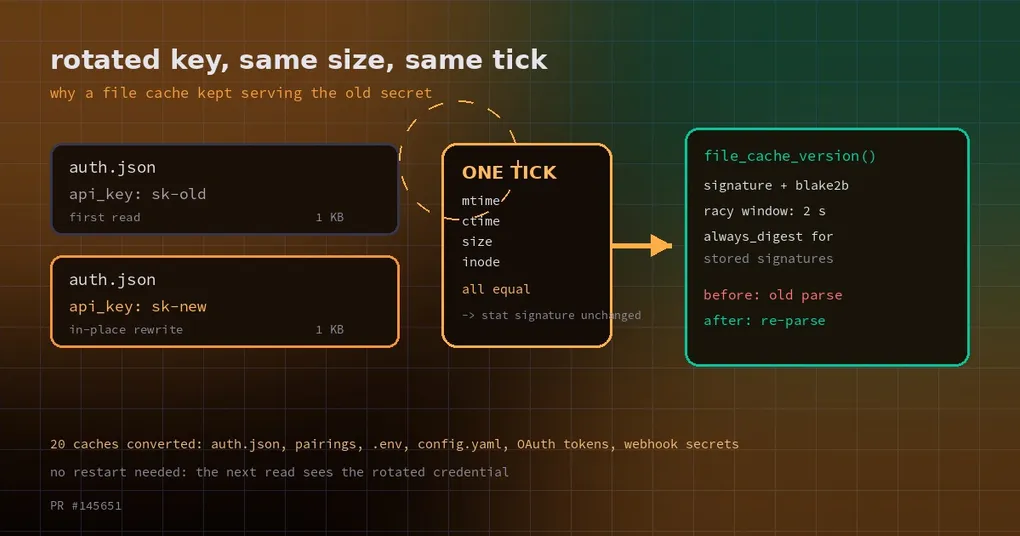
Il est 1 h du matin et vous changez votre clé OpenRouter, parce que l’ancienne a fuité et doit mourir maintenant. Vous modifiez la ligne dans config.yaml, la copie dans .env, et vous retirez de la liste d’appairage un utilisateur Telegram qui ne doit plus pouvoir parler à votre agent. Vous ne redémarrez rien — Hermes recharge les changements à chaud, et vous comptez là-dessus depuis des mois. Au matin, un profile utilise tranquillement la nouvelle clé pendant qu’une session follow-profile continue d’envoyer des requêtes avec l’ancienne et remplit le log de 401. L’utilisateur révoqué ? Il passe toujours.
Ce n’est pas un oubli d’enregistrement. La réponse apportée par la PR #145651, fusionnée le 27 octobre, est un peu contre-intuitive : votre modification a bien atteint le fichier, mais le processus a cru que le fichier n’avait pas changé. Et il l’a cru parce qu’il surveillait une empreinte qui ne bouge pas quand la lecture et l’écriture tombent dans le même tick d’horloge.
Ce qu’un cache surveille vraiment
Hermes entretient de petits caches un peu partout. Lire auth.json une fois et mémoriser le parsing ; lire la liste d’appairage une fois et retenir qui est approuvé ; lire config.yaml une fois et retenir les routes des providers. Pour éviter des re-parsings inutiles, chaque cache regarde d’abord une « empreinte » de fichier. Les quatre valeurs habituelles :
mtime— date de dernière modificationctime— date de changement de l’inodesize— nombre d’octetsinode— le numéro du fichier
Même empreinte, on réutilise le parsing. Empreinte différente, on relit. C’est juste presque toujours. Ça se casse quand deux détails s’alignent.
Détail un : même longueur, écrasement sur place. Passer de api_key: sk-old à api_key: sk-new laisse le nombre d’octets identique, et une réécriture sur place — par un éditeur ou par un script — laisse aussi l’inode. Deux des quatre valeurs sont désormais forcément égales.
Détail deux : la résolution des horodatages. Sur beaucoup de kernels (notamment les runners de CI et certains hôtes plus anciens sans multigrain timestamps), mtime et ctime viennent d’une horloge assez grossière. Si la lecture et l’écriture tombent dans le même tick, les deux écritures portent exactement le même (mtime_ns, size, ino, ctime_ns). Le cache voit une empreinte inchangée et conclut : rien à faire, on garde l’ancien parsing.
C’est comme ça que la CI l’a attrapé. Un test écrit config.yaml avec le port 3, le lit, puis le réécrit sur place avec le port 5 — même longueur, même inode. L’échec d’assertion est presque comiquement limpide :
E At index 1 diff: 'http://127.0.0.1:3/v1' != 'http://127.0.0.1:5/v1'Les ports 3 et 5 tiennent chacun sur un caractère : le fichier fait exactement la même taille, octet pour octet. Le test était censé prouver qu’une clé changée atteint les sessions follow-profile ; il a prouvé que le cache servait l’ancienne route.
Pourquoi un redémarrage « corrige » et le rechargement à chaud non
C’est la partie qui rend les gens fous : le bug n’existe que tant que le processus est vivant.
Après un redémarrage, chaque cache démarre vide, la première lecture doit parser, et vous voyez la nouvelle valeur. C’est aussi pour ça que le symptôme est éternellement mal diagnostiqué : « la config ne s’applique pas », « le live reload est cassé », « ce profile est bloqué ». Toutes les explications pointent le système de configuration, alors que le vrai coupable est la conception de la clé de cache.
Le rayon d’impact dépasse un seul cache. Certaines clés utilisaient le tuple complet à quatre valeurs, d’autres mtime seul, d’autres mtime + size. Contournez-en une et un autre composant peut encore vous servir la valeur de la veille.
Un seul helper au lieu de vingt correctifs
Le correctif ne patche pas chaque site. Il ajoute un helper unique dans le utils.py à la racine du dépôt :
def file_cache_version(path, st=None, *, always_digest=False):
    ...
Il renvoie deux choses : la signature du fichier, plus un digest du contenu.
- La signature reste le tuple de
statbon marché. - Le digest suit par défaut une politique de « fenêtre de course » : si la plus récente de
mtimeetctimea moins de deux secondes (RACY_MTIME_WINDOW_NS), les octets du fichier sont hachés en blake2b ; une fois le fichier stabilisé, le digest devient une chaîne vide.
En clair : un fichier qui vient d’être écrit est jugé sur son contenu, un fichier stabilisé est jugé sur sa signature stat. Le seul coût est un parsing supplémentaire pour une entrée mise en cache pendant que le fichier était encore en course, une fois qu’il se stabilise. Pour un cache revérifié à chaque lecture, c’est rien.
always_digest=True existe pour une autre forme d’appelant : une signature stockée maintenant et comparée bien plus tard. Pour ceux-là, un digest qui bascule vers une chaîne vide ressemblerait à un changement, donc ils hachent à chaque appel. La PR les nomme :
- la signature du profile servi (un faux changement reconnecte ses adapters)
- l’enregistrement d’échec de parsing (un faux changement effacerait l’erreur alors que le fichier est toujours cassé)
- le consentement des shell-hooks
- l’estampille d’inventaire du free-tier
- l’estampille d’échéance de l’onboarding
- le manifeste des skills, écrit sur disque et comparé par le processus suivant
Il y a une exception volontairement étroite : un worker lié à un snapshot de config gelé ne hache jamais config.yaml. Le contrôle se trouve à l’intérieur du helper, donc aucun appelant ne peut faire ouvrir le fichier de profile à un worker sûr. Les autres fichiers — auth.json, .env, listes d’appairage — gardent le digest à l’intérieur des workers.
Et il ne lève jamais d’exception. Avec le stat précédent fourni par l’appelant, un fichier qui a disparu ou est devenu illisible reçoit le nom de l’erreur comme digest, qu’aucune version lisible ne peut égaler. Le cache s’invalide au lieu de planter.
Vingt caches, dont n’importe lequel pouvait servir un vieux secret
La PR liste ensuite chaque site où une lecture périmée pouvait servir un secret, un token, une allowlist, une route ou de la config, et convertit les vingt. Quelques-uns qui correspondent à l’usage quotidien :
| Site | Ce qu’il met en cache | Clé avant |
|---|---|---|
hermes_cli/auth.py global auth store |
le auth.json partagé — vos identifiants |
file_signature |
hermes_cli/auth.py Nous login status |
si vous êtes connecté | st_mtime seul, plus un TTL de 15 s |
gateway/pairing.py approved list |
l’allowlist des DM | le tuple à quatre valeurs |
gateway/platforms/webhook.py dynamic routes |
secrets HMAC par route | (mtime_ns, size, ino) |
plugins/platforms/feishu/feishu_comment_rules.py |
allowlist et règles d’appairage des commentaires Feishu | st_mtime seul |
tools/mcp_oauth_manager.py |
rechargement des tokens MCP OAuth | st_mtime_ns seul |
providers/__init__.py named custom provider |
quelle route prend une requête | file_signature |
agent/prompt_builder.py skills manifest |
le snapshot des skills dans le prompt | file_signature |
Regardez ce que cette liste touche : identifiants, allowlists, routes, et le prompt lui-même. Les deux allowlists sont celles qui devraient vous faire dresser l’oreille — une révocation d’accès est censée prendre effet immédiatement, pas au redémarrage suivant.
Concrètement, après le correctif :
- une
api_keychangée (k-old→k-new) atteint les sessions follow-profile sans redémarrage ; - un appairage révoqué n’a plus d’accès dès le contrôle suivant ;
- une modification de port de même longueur (
:3→:5) change la route tout de suite ; - un token rafraîchi, ou une correction de config de même taille, n’est jamais masqué par le parsing précédent.
Ce que vous devriez faire
Il n’y a pas grand-chose à faire, mais trois points valent la peine d’être connus.
D’abord, mettez à jour. Un correctif comme celui-ci arrive dans votre installation avec le prochain tag ; côté CLI, passez par hermes update. Si vous voulez les mises en garde de ce chemin, nous les avons détaillées dans notre guide de mise à jour.
Ensuite, cessez d’utiliser le redémarrage comme moyen de faire appliquer la config. Si vous avez pris l’habitude de relancer le gateway après chaque édition de config parce que « sinon ça ne prend pas, parfois », vous tombiez probablement sur ce bug. Après la mise à jour, le rechargement à chaud se comporte comme vous le supposiez.
Troisième, vérifiez les révocations. Si vous contrôlez qui peut parler à un bot via l’allowlist d’appairage (le mécanisme est décrit dans notre article sur l’allowlist de profile), envoyez un message après la révocation et confirmez qu’il est refusé, plutôt que de supposer que c’est passé. Avant ce correctif, « je croyais l’avoir révoqué » était un vrai trou.
Il vaut aussi la peine de stocker les secrets correctement. Nous avons détaillé la différence entre auth.json et .env, et le chiffrement via le keychain système, dans le guide des secrets et du chiffrement.
À retenir
Ce qui rend ce bug pénible n’est pas sa difficulté. C’est qu’il ouvre un écart invisible entre « je l’ai changé » et « le système utilise la nouvelle valeur ». Vous avez modifié un fichier ; le système a fait confiance à une empreinte ; et l’empreinte ne bouge pas quand les deux actions tombent dans le même tick d’horloge. Le correctif suit une bonne intuition : plutôt que de deviner quel parser un client utilisera, rendre détectable le fait que « ces deux-là peuvent diverger » — hacher le contenu quand c’est possible, le hacher à chaque fois quand ça ne l’est pas. Un cache est censé être une optimisation de performance, pas une copie du monde de la semaine dernière.