Le modèle a envoyé un tableau sous forme de chaîne — alors pourquoi seuls certains outils se plaignent ?
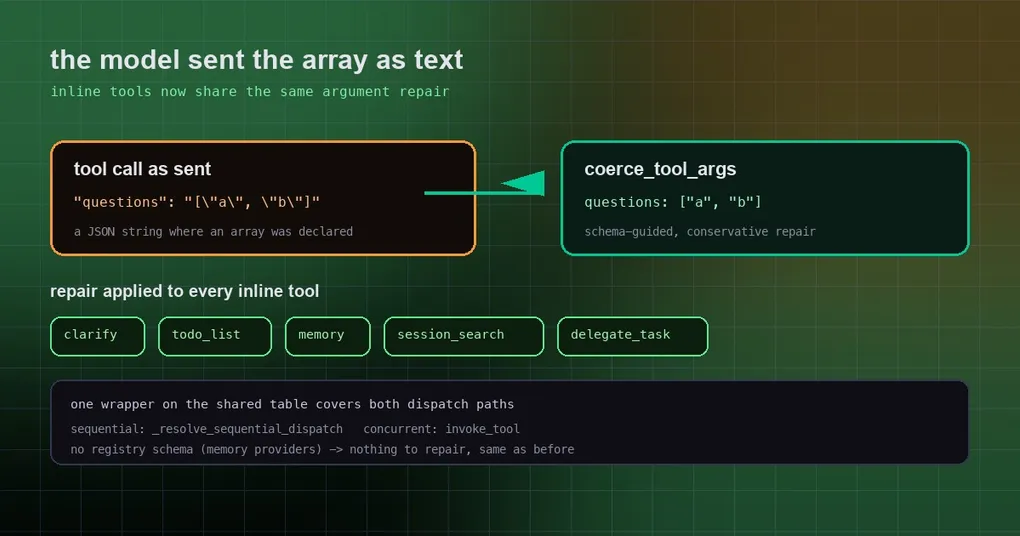
Vous demandez à l’agent d’utiliser clarify pour poser cinq questions d’un coup. Il appelle l’outil avec entrain et revient avec une erreur de type. Vous réessayez avec un autre modèle, vous reformulez légèrement, et ça fonctionne. Pire encore : passez à un autre outil, reproduisez exactement la même erreur — un tableau envoyé sous forme de chaîne JSON — et rien ne casse jamais.
Cette impression de ça marche parfois ne vient généralement pas du modèle. Elle vient du fait qu’il existe deux points d’entrée différents pour les appels d’outils, l’un réparant discrètement les arguments et l’autre pas. Un patch fusionné le 2026-09-29 (PR #127781) les a alignés. Voici ce qui n’allait pas, ce qui a changé, et ce qui se comporte encore comme avant.
Le point d’entrée partagé réparait déjà vos arguments
Chaque appel d’outil du registre dans Hermes passe par un seul endroit :
# model_tools.handle_function_call
args = coerce_tool_args(tool_name, args)
La logique de tools/arg_coercion.py est le seul endroit du code qui répare les types d’arguments. Elle s’appuie sur le JSON Schema propre à l’outil et corrige :
"42"en42(chaîne vers nombre)"true"entrue(chaîne vers booléen)- une chaîne encodée en JSON en tableau ou en objet, y compris lorsqu’elle est imbriquée dans un conteneur
- une valeur unique en liste d’un élément, lorsque le schéma attend un tableau
Elle est délibérément conservatrice : elle ne modifie une valeur que lorsqu’il existe une seule réponse claire, et conserve l’originale quand la correction est ambiguë. C’est aussi pour cela que vous ne la remarquez jamais — personne ne parle d’une réparation qui a fonctionné, seulement d’un appel qui a échoué.
Le problème : les outils inline ne passent jamais par là
Une catégorie d’outils est dite inline : ils sont implémentés par l’agent lui-même et enregistrés dans la table INLINE_TOOL_EXECUTORS de agent/inline_tool_executors.py. On y trouve clarify, todo_list, memory, session_search, read_terminal, drive_preview, delegate_task, et d’autres encore.
Le hic, c’est que les deux chemins de distribution consultent cette table directement, sans passer par handle_function_call :
- chemin séquentiel :
_resolve_sequential_dispatchdansagent/tool_executor.py - chemin concurrent :
invoke_tooldansagent/agent_runtime_helpers.py
Ces outils reçoivent donc des arguments bruts, jamais réparés :
clarifyrejetait un tableauquestionsarrivé sous forme de chaîne JSON ;todo_listrencontrait la même erreur et y survivait grâce à son propre blocjson.loads;memoryetsession_searchne faisaient absolument rien.
Un outil corrigé par la couche partagée, un autre par un correctif écrit à la main, les autres par rien du tout — voilà la réponse à la question pourquoi seuls certains outils signalent des erreurs d’arguments.
model tool call
  ├─ registry tool → handle_function_call → coerce_tool_args → tool
  └─ inline tool   → INLINE_TOOL_EXECUTORS → tool gets raw args   ← the gap
Le correctif : envelopper l’unique table lue par les deux chemins
Le patch reste mesuré — il ne touche à aucun des deux chemins de distribution. Il enveloppe la table que tous deux consultent :
# agent/inline_tool_executors.py
def _coerced(name: str, executor: InlineToolExecutor) -> InlineToolExecutor:
    def _exec(agent, args: dict, ctx: InlineToolContext) -> Any:
        return executor(agent, coerce_tool_args(name, args), ctx)
    return _exec

INLINE_TOOL_EXECUTORS: Dict[str, InlineToolExecutor] = {
    name: _coerced(name, executor) for name, executor in _RAW_INLINE_TOOL_EXECUTORS.items()
}
Comme les deux chemins de distribution lisent cette même table, un seul wrapper couvre aussi bien l’exécution séquentielle que concurrente. tools/todo_tool.py a ensuite abandonné son json.loads artisanal : son schéma déclare déjà todos comme un tableau, la réparation partagée le couvre donc — et conserver une seconde implémentation ne faisait qu’ajouter une seconde source de vérité.
Il vaut la peine de préciser ce que le correctif ne couvre pas : les outils de memory-provider sur le chemin concurrent n’ont pas de schéma de registre, donc coerce_tool_args n’a aucune information de type sur laquelle agir. C’est inchangé par rapport à avant — ce n’est pas une régression. Le patch a seulement cessé de laisser les outils dotés d’un schéma vivre selon deux règles différentes.
Un détail facile à manquer : les noms de champs doivent d’abord correspondre
La première chose que fait réellement coerce_tool_args, c’est remapper les noms d’arguments vers les noms de transport du registre :
from tools.schema_sanitizer import unrename_tool_args
args = unrename_tool_args(schema.get("parameters"), args)
Le schéma que voit le modèle est assaini : les clés de propriétés qu’un provider refuse sont renommées. Les noms de clés du modèle et ceux, internes, du registre ne sont donc pas tout à fait identiques. La réparation doit restaurer les noms à l’aide du schéma propre au registre avant de convertir quoi que ce soit par clé — inversez l’ordre et vous réparez un champ qui n’existe pas.
Comment vérifier que ça fonctionne
Le patch fournit une commande de vérification (nécessite une copie locale du dépôt) :
scripts/run_tests.sh tests/tools/test_todo_tool_type_coercion.py tests/agent/ tests/tools/test_clarify_tool.pyAu quotidien, la différence observable est que la même formulation se comporte désormais de la même façon d’un outil à l’autre. Auparavant, seuls les outils du registre toléraient une chaîne JSON là où un tableau était déclaré ; désormais clarify, todo_list, memory et session_search le font aussi. Le plus simple pour le reproduire vous-même est de faire poser plusieurs questions d’un coup par une session via clarify — exactement le scénario qui a mis la faille au jour.
Trois enseignements pratiques :
- Cessez de lire les erreurs de type comme un problème de capacité du modèle. Quand un outil signale un mauvais type d’argument, vérifiez s’il a reçu un tableau sous forme de chaîne JSON ; après ce patch, ce type de bruit devrait nettement diminuer.
- Quand vous écrivez des skills ou des prompts personnalisés, décrivez les paramètres comme le fait le schéma. La réparation est un filet de sécurité, pas l’objectif de conception — dire au modèle que
questionsest un tableau de chaînes est plus stable que d’espérer qu’il tombe juste à chaque fois. - Continuez à déclarer des schémas sur les outils que vous écrivez vous-même. La réparation dépend entièrement du schéma ; les paramètres qui n’en ont pas (comme les outils de memory-provider ci-dessus) ne seront jamais réparés automatiquement.
Cela prolonge une série de deux articles précédents : l’article sur clarify par lots montre combien de va-et-vient on économise en posant plusieurs questions d’un coup, et le régime du schéma d’outil explique comment réduire les schémas pour économiser des tokens. Ce patch est la troisième brique : rendre la réparation des arguments cohérente avant qu’un outil ne voie jamais les arguments. Pour tout ce qui touche aux todos, voyez l’article sur les sous-tâches imbriquées.
En résumé
- La réparation des arguments n’a lieu que dans
handle_function_call→coerce_tool_args; les outils inline sont résolus directement par deux chemins de distribution et ne passent jamais par elle. - La même erreur — un tableau envoyé sous forme de chaîne JSON — faisait donc échouer
clarify, masquer le problème àtodo_listviajson.loads, et ne rien faire du tout àmemoryetsession_search. - Désormais, toute la table
INLINE_TOOL_EXECUTORSest enveloppée une seule fois, ce qui couvre les chemins séquentiel et concurrent ; l’analyse artisanale detodo_lista disparu. - La réparation nécessite un schéma et doit d’abord remapper les noms de champs assainis vers les noms du registre ; les outils de provider sans schéma conservent leur comportement précédent.
- Traitez les erreurs de type comme un problème de mécanisme, décrivez les paramètres selon le schéma dans vos prompts, et continuez à déclarer des schémas sur vos propres outils.
Pour aller plus loin : la documentation sur les outils et toolsets, et hermes config sur ce site.