Más de la mitad de ese state.db eran copias de mensajes que ya habías eliminado con el prune
El ventilador del portátil ha empezado a encenderse mientras haces cosas ligeras. Las copias de seguridad tardan un poco más cada semana. hermes sessions stats dice que la base de datos ocupa varios gigabytes, pero tu lista de sesiones no parece de varios gigabytes: la mayoría de las conversaciones son de una docena de turnos y su historial se comprimió hace mucho. ¿Dónde se ha ido el espacio?
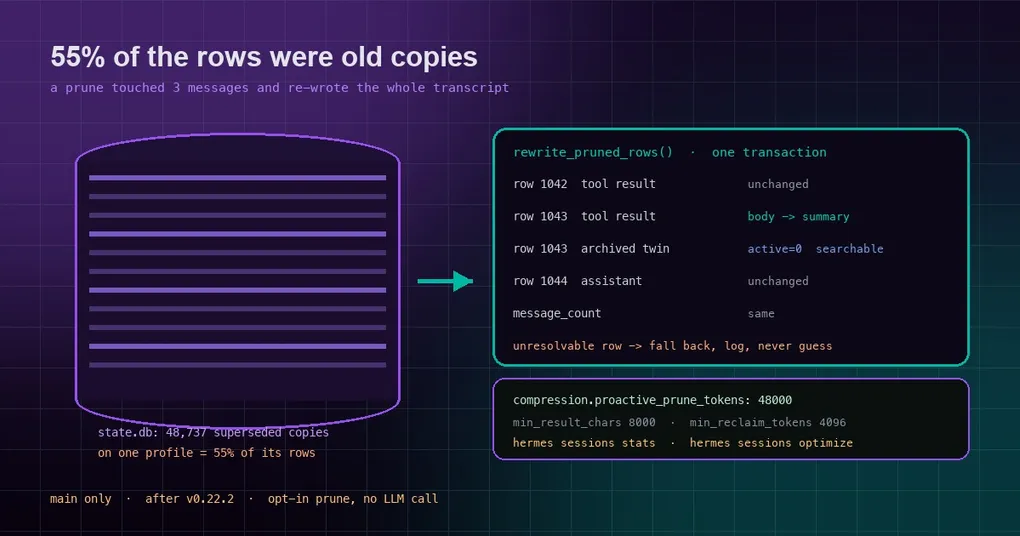
La respuesta es un poco contraintuitiva: se fue a los mensajes antiguos que ya habías eliminado. Sus cuerpos completos se copiaron en gemelos “archivados”, una y otra vez. En una instalación con el prune opcional activado, un solo profile acumuló 31.930 de esas copias; otro tenía 48.737, el 55% de todas sus filas.
Qué hace realmente el prune
Hermes tiene una función opcional llamada prune proactivo (compression.proactive_prune_tokens, desactivada por defecto). Es deliberadamente modesta: cuando el historial reenviado supera tu umbral de tokens, sustituye resultados de tools antiguos y voluminosos —volcados de terminal, lecturas de archivos, extracts web— por resúmenes cortos. Sin ninguna llamada al modelo de por medio.
Lo importante: un prune edita el cuerpo de unos pocos mensajes que ya existen. Nunca añade un mensaje, ni quita uno, ni los reordena. Desde el punto de vista de los datos, es una edición local.
La ruta de commit antigua no estaba de acuerdo. Cada commit pasaba por el escritor completo de archivar y compactar: archivar todas las filas activas y reinsertar la lista entera.
Cambias tres mensajes; la base de datos gana una copia del transcript completo.
Una o dos veces no es nada. Pero el prune se dispara repetidamente en una sesión larga, y las copias se apilan: cada una es “el historial completo tal como estaba entonces”, y buena parte de ese contenido se convierte en material de origen de la siguiente copia. Por eso el archivo crece mucho más rápido que tus conversaciones.
Los números medidos
No son estimaciones: salen del issue de seguimiento.
| Observación | Valor |
|---|---|
| Copias caducadas, primer profile | 31.930 filas |
| Copias caducadas, segundo profile | 48.737 filas |
| Proporción de filas de ese profile | 55% |
| Disparador | prune proactivo activado (config de ejemplo proactive_prune_tokens: 12000) |
Media base de datos no hacía nada salvo ralentizar lecturas, escrituras, backups y el índice de texto completo.
Qué ha cambiado: reescribir in situ
La nueva primitiva de commit es SessionDB.rewrite_pruned_rows(session_id, changes, model_config_patch=...), y corre en una sola transacción:
- Nombrar la fila. Se resuelve primero por
_row_id; si no, portool_call_id(resultados de tools) o por la lista de ids de tool calls que lleva un turno del assistant —única dentro de una sesión—; y si no, solo por la única fila activa con el mismo rol y el mismo contenido almacenado. - Demostrar que sigue siendo la original. Mismo rol, mismo tool call id, mismos call ids y, en las filas de tools, el mismo cuerpo almacenado. Cualquier discrepancia aborta la ruta in situ.
- Dejar un gemelo archivado de su versión previa al prune (
active=0, compacted=1), para que el cuerpo completo degradado siga siendo buscable exactamente igual que antes. Compactar sigue sin significar perder datos. - Tomar las columnas cambiadas bajo su propio id y fusionar el patch de rearme en
model_config.
Las filas sin cambios, el orden del modelo, los row ids y las filas añadidas en paralelo no se tocan nunca. Los triggers existentes messages_fts_update y messages_display_identity_update mantienen coherentes los índices de texto completo y de visualización, y message_count no cambia porque ninguna fila entra o sale del conjunto vivo.
Un detalle que invita a confiar: cuando la fila no se puede nombrar exactamente —_absorbed_row_ids fusionados, cero o varias coincidencias, una fila inactiva, una fila de usuario, un cuerpo que ya cambió— no adivina. Lanza PruneRowUnresolvedError antes de escribir nada, lo registra a nivel INFO y cae a la ruta antigua de archivar y compactar. Más lenta, pero correcta.
Cómo usarlo y cómo revisar tu propio almacén
1. Averigua si el prune está activado.
hermes config get compression.proactive_prune_tokens0 (o “Config key not set”) significa desactivado, y entonces este mecanismo no es lo que ha hecho crecer tu base de datos. Para activarlo, las tres claves viven bajo compression::
compression:
  proactive_prune_tokens: 48000        # 0 = off; 48000 is a reasonable start
  proactive_prune_min_result_chars: 8000   # results smaller than this are left alone
  proactive_prune_min_reclaim_tokens: 4096 # do not commit unless it reclaims this much
2. Mide el almacén.
hermes sessions stats
du -sh ~/.hermes/state.db
(Los profiles no por defecto guardan sus datos en su propio directorio de profile.)
3. Recupera espacio: son dos operaciones distintas, no las confundas.
hermes sessions optimize          # merge FTS5 segments + VACUUM; no session data changes
hermes sessions optimize-storage  # migrate the full-text index to the compact v23 layout
optimize recupera páginas libres; optimize-storage cambia el layout del índice y puede recuperar una fracción importante en bases de datos grandes. Ninguna de las dos borra copias antiguas por ti: qué archivar o eliminar sigue siendo tu decisión de retención. El arreglo impide que se creen copias nuevas; no limpia las que ya están. Las filas existentes se quedan hasta que archives o elimines sesiones según tu propio calendario.
Una nota sobre el estado: el cambio se fusionó a main el 18 de octubre de 2026, después de que la v0.22.2 saliera el 15 de octubre, así que la versión actual no lo incluye. Los prune nuevos empezarán a usar la ruta in situ después de tu próximo hermes update.
Por qué este tipo de crecimiento pasa desapercibido
Se juntan tres razones.
- Es el efecto secundario de algo correcto. Archivar y reinsertar garantizaba que cada commit fuera una instantánea completa y consistente. No había ningún bug de lógica: el coste simplemente se cargaba al disco.
- Las métricas no lo muestran. El número de sesiones no cambia, el de mensajes tampoco, la UI va bien. Solo el tamaño del archivo y el I/O se degradan poco a poco.
- Escala con el uso. Cuantas más sesiones largas y más salidas grandes de tools ejecutes, más rápido crece, y los usuarios intensivos son los que menos probabilidades tienen de notarlo, porque sus máquinas ya están ocupadas de por sí.
Esto no es corrupción de la base de datos, y conviene no mezclar las dos cosas: un esquema roto o una sesión que desaparece tienen su propia ruta de reparación, cubierta en recuperar un state.db dañado. Aquí los datos estaban perfectamente sanos: simplemente había demasiados.
La lección general
“Actualizar in situ” y “reescribirlo todo” son funcionalmente equivalentes y completamente distintos en coste. Muchos sistemas eligen la reescritura porque es simple y no puede dejar un estado a medio escribir; el precio es copiar todos los datos en cada edición pequeña. Pon eso en una ruta caliente —cada pocos turnos— y el precio se acumula más rápido de lo que esperas.
El test es directo: si has cambiado una fila, ¿deberías estar escribiendo N? Si la respuesta es no, esa ruta acaba convirtiéndose en un problema de capacidad. El arreglo rara vez necesita un motor de almacenamiento nuevo; normalmente solo necesita que quien llama reconozca una actualización in situ: aquí, nombrar la fila exacta por su identidad de tool call y comprobar que nada más se ha movido.
Para controlar el contexto y el tamaño del historial con más intención, hay dos posts relacionados que profundizan: la estrategia de compresión lean-tail cubre qué sobrevive a una compactación, y reconstruir el prompt después de compactar cubre lo que ve el modelo después. Si gestionas sesiones desde una shell, la referencia de hermes sessions lista cada subcomando y cada filtro.
Resumen
- Síntoma: un
state.dbmucho más grande que tu volumen de conversaciones; backups lentos, I/O pesado, recuentos de filas raros enhermes sessions stats. - Causa: cada commit del prune proactivo archivaba todas las filas activas y reinsertaba la lista entera — 48.737 copias obsoletas en un profile, el 55% de sus filas.
- Arreglo:
rewrite_pruned_rows()actualiza solo las columnas cambiadas, mantiene un gemelo archivado y buscable y cae a la ruta segura cuando una fila no se puede nombrar exactamente. - Hoy: comprueba el interruptor con
hermes config get compression.proactive_prune_tokens, mide el almacén conhermes sessions stats, recupera espacio conhermes sessions optimizey actualiza para tener la nueva ruta de commit.