El parche que reescribió bytes que nadie le pidió tocar
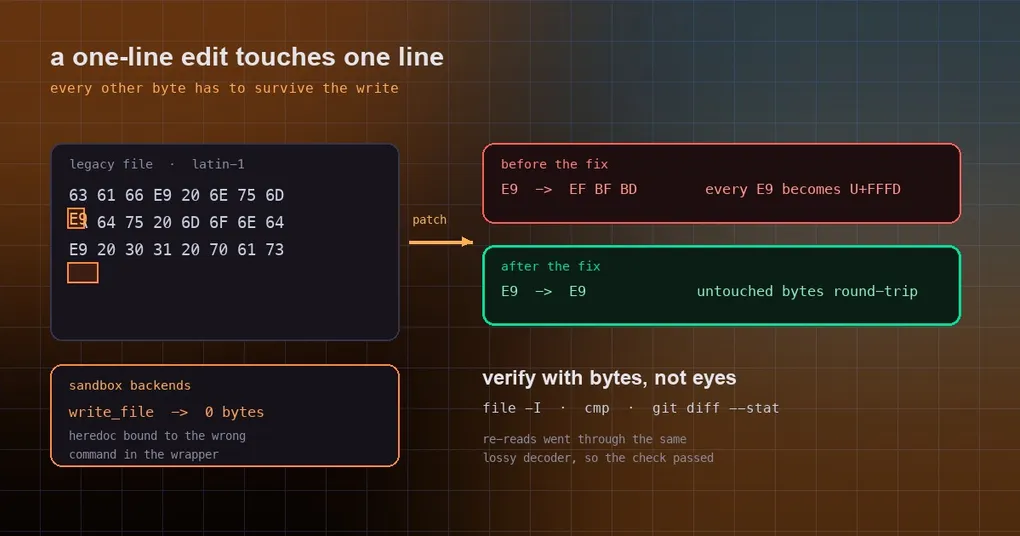
La petición es diminuta a propósito: renombrar una variable en un archivo de parser que arrastra codificación ISO-8859-1 desde antes de que tú entraras en el equipo. El agente informa de éxito, el diff parece un solo hunk y abres el archivo. Tu editor muestra é donde antes había é, en líneas que tu petición ni mencionaba. git diff --stat dice que han cambiado muchas más líneas de las que pediste. Nada dio error, nada avisó, y la verificación de la propia tool dijo que el parche había persistido. Esta es la historia de dos rutas de escritura que podían perder bytes que ni siquiera estaban tocando — y de por qué la red de seguridad les dio la razón.
Una ruta de escritura es tan exacta como su lectura
Hay algo que se escapa fácil cuando piensas en tools de archivos: para parchear un archivo, la tool tiene que leerlo primero, y lo que esa lectura le haga a los bytes es lo que luego se vuelve a escribir. Dos lecturas en estas rutas tenían pérdida.
El modo patch por defecto pasaba por el transporte de texto. mode="replace" — el modo por defecto — y el modo de edición V4A, para cualquier byte más allá de la primera muestra binaria de 1.000 bytes, decodificaban el contenido con errors="replace". Ese es el decodificador amable que quieres para mostrar por pantalla: cualquier byte que UTF-8 no pueda decodificar se convierte en U+FFFD, el carácter de reemplazo. Para una persona leyendo un log, eso es un favor. Para una lectura que alimenta una escritura, es una mutación silenciosa: cada byte indescifrable de líneas que tu edición no tocaba salía de vuelta como EF BF BD. Un parche de una línea en ese parser Latin-1 reescribía cada 0xE9 del archivo.
La lectura V4A ejecutaba una limpieza que ya no hacía falta. La ruta de lectura cruda hacía pasar el archivo entero por la limpieza de fugas de fences del terminal, que elimina secuencias de escape OSC y bytes BEL, y descarta cualquier línea que contenga el literal __HERMES_FENCE_. Ese envoltorio era un workaround para una capa de backend que desde entonces se ha sustituido; ya nada lo emite, lo que significa que la limpieza solo podía llegar a eliminar bytes que pertenecían a tu archivo: caracteres de control en un fixture, una captura, un archivo de protocolo heredado.
Por qué nada lo detectó
La tool tiene un paso de verificación. Y el diff que te mostraron también. Los dos releían el archivo a través del mismo transporte con pérdida que acababa de corromperlo. Los bytes corruptos se decodifican a los mismos caracteres de reemplazo a la vuelta, la comparación coincide y la tool informa de un parche limpio y persistido.
Esa combinación — mutar al leer y luego verificar con la misma lectura — es el patrón que merece la pena recordar más allá de este proyecto. Una verificación que comparte la transformación que causó el daño no puede detectarlo; solo puede confirmar que el daño es estable. Por eso el síntoma reportado nunca fue un mensaje de error. Fue un post-mortem: un revisor detectando mojibake en git diff, o el CI fallando en un archivo cuya codificación había cambiado en silencio por debajo.
Qué hace el arreglo
PR #120515 hace que los dos modos de patch lean exactamente los bytes que vuelven a escribir. Las lecturas son nativas en un host POSIX local para archivos regulares (un FIFO sigue yendo por la ruta del shell, con su timeout) y base64 por el cable para backends remotos. El contenido cruza después la capa de texto con surrogateescape, el códec que hace round-trip de cualquier byte indescifrable sin pérdida: es el inverso exacto del encode que write_file ya usaba para este fin, fijado por un test de ida y vuelta.
Un detalle explica por qué no se limitaron a convertir «no es UTF-8 válido» en un error de lectura: las operaciones V4A Add File, Delete File y los dos extremos de Move File usan el fallo de lectura como su comprobación de existencia. Convertir un archivo con codificación rara en un error de lectura habría hecho que la tool informara de que un archivo que existe claramente no existe. surrogateescape mantiene esos archivos legibles y exactos byte a byte.
El bug hermano: escrituras que dejaban el archivo vacío
El segundo arreglo, PR #122012, es peor de la forma más directa. En los backends de heredoc por stdin — Modal, Daytona y Vercel — write_file y patch no corrompían el destino. Lo reemplazaban por un archivo vacío.
El mecanismo es un detalle de shell: el heredoc estaba enlazado solo al último comando del script envoltorio (trap - EXIT), así que el cat > "$tmp" que debía recibir el contenido no leía nada, y el archivo temporal vacío se movía a su sitio. El arreglo redirige el heredoc al comando compuesto completo y añade la mitad que faltaba para que el cuerpo llegue exacto byte a byte — sin el salto de línea final que añade el heredoc, de modo que las escrituras verifiquen.
El commit de seguimiento es una pequeña clase magistral de portabilidad de shell: el payload se reemite usando solo builtins del shell, evitando a propósito base64/head, porque un binario ausente volvería a entregar stdin vacío al comando en silencio; y hace falta || : porque, con set -e heredado, el estado de fin de archivo de read mataba al lector y producía stdin vacío, medido en bash 3.2 y 5.2. Un bug que vaciaba archivos a distancia se arregló sin añadir una sola dependencia externa a la ruta crítica.
Qué hacer al respecto
- Conoce la codificación antes de parchear.
file -I path/to/filetarda un segundo y te dice si estás en UTF-8 o en una codificación heredada de un solo byte. Todo lo que no sea UTF-8 merece las comprobaciones de abajo. - Verifica con bytes, no con la tool.
git diff --stat(cuenta líneas, no «parece que está bien»),cmpcontra una copia que sabes que es buena, o un hash de la región que no tocaste. Para archivos cercanos a lo binario — fixtures, capturas, blobs de proveedor — un hash es la única comprobación honesta. - Trata la verificación posterior a la edición como sospechosa cuando venga de la misma tool. Si la tool que escribió el archivo también te dice que el archivo está bien, eso es una afirmación sobre su propia ruta de lectura, no sobre tus bytes.
- Revisa cualquier cosa escrita a un backend sandbox en las últimas semanas. Un archivo de cero bytes se reporta como archivo; si un config, un lockfile o un fixture ha estado misteriosamente vacío, esta es una explicación candidata. Vacío es más fácil de ver que corrupto, pero solo si miras.
- Los dos arreglos están solo en
main. Se mergearon el 2026-09-25, un día después del tag v0.21.5, así que no están en ese tag (mira la página de la release v0.21.5 para ver qué sí incluye). Llegan con la siguiente release o con unhermes updateque sigamain. Si hoy estás en las rutas hosted o sandbox, coge el hábito de comprobar los tamaños de archivo después de una escritura.
La codificación es un tema recurrente en los arreglos recientes de este proyecto: el artículo sobre el arreglo de locales en Windows cubre la otra mitad del asunto, donde el crash venía de decodificar en lugar de escribir. Y la pregunta general «¿están mis datos intactos de verdad?» tiene un tratamiento más largo en las notas sobre la corrupción de la base de datos de estado: la misma regla, otra capa de almacenamiento.
Qué llevarte
El fallo interesante aquí no es que un archivo se corrompiera. Es que la verificación compartía el defecto. Una comprobación que pasa por la misma transformación, códec o transporte que la operación que está comprobando solo puede confirmar consistencia, nunca corrección. Cuando montes un pipeline que lee, transforma y escribe datos que tú no has escrito, mantén al menos una comprobación independiente que no toque la transformación: un recuento de bytes, un hash, un tamaño, una copia hecha antes de escribir. En este caso esa comprobación independiente es justo lo que el arreglo volvió a hacer posible, y es la razón por la que la próxima corrupción silenciosa de este tipo aparecerá como un diff en lugar de como una sorpresa.