Revertido tras 11 horas: por qué los prompts de aprobación de Hermes conservan un plazo
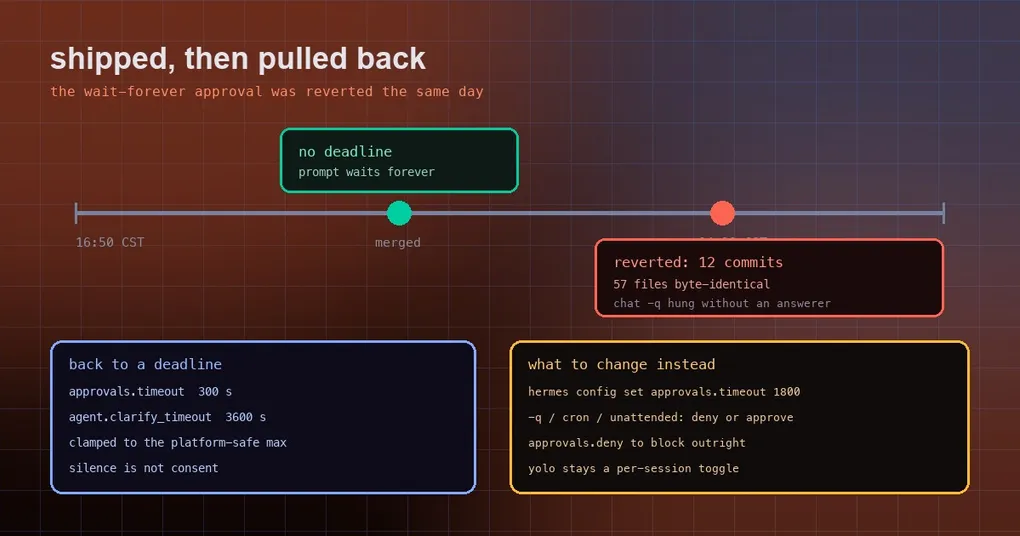
Si ayer leíste que los prompts de aprobación de Hermes ahora te esperan para siempre, quizá te hayas dado cuenta de que volvieron a hacer la cuenta atrás y a denegar cuando se acaba el tiempo. Parece un maintainer cambiando de opinión, pero en realidad es una línea de diseño trazada a toda prisa: el cambio resolvía una molestia real y creaba un deadlock justo en el único sitio donde nadie puede responder. Se revirtió 11 horas y 32 minutos después de fusionarse.
Este post no toma partido. Expone la cronología, los motivos y —lo más importante— el comportamiento que realmente aplica ahora, porque eso decide cómo deberías configurar approvals.
Cuál es el comportamiento hoy
Fijemos primero la conclusión, porque determina si necesitas tocar tu configuración o no. A 3 de octubre de 2026:
| Superficie | Cuánto vive el prompt |
|---|---|
| CLI interactiva, TUI, app de escritorio | Hace la cuenta atrás hasta approvals.timeout (por defecto 300 s), luego lo trata como no aprobado y bloquea el comando |
| Telegram / Discord / Slack y otras plataformas de mensajería | También usa approvals.timeout; una notificación push puede quedarse sin ver durante minutos |
Preguntas de aclaración (agent.clarify_timeout) |
Por defecto 3600 s (1 hora); al expirar, la espera se desbloquea con «el usuario no respondió en Xm» |
El contrato central no cambia y es importante: un timeout no es una aprobación. No es «nadie respondió, así que adelante», sino «nadie respondió, así que no lo ejecutes». El texto upstream para un prompt cancelado lo dice en una línea: el silencio no es consentimiento. Un plazo es el valor por defecto seguro, y el precio es que puedes perder una operación en silencio.
Qué hacía el cambio revertido
A las 16:50 CST del 1 de octubre, se fusionó el PR #130167. Su premisa era dividir las superficies según si hay un humano delante de la pantalla:
Los prompts de aprobación y de aclaración en la CLI, la TUI y la app de escritorio dejarían de expirar. Se quedaban hasta que se respondieran, hasta que se interrumpiera el turno o hasta que se cerrara la sesión. Las plataformas de mensajería, los editores ACP y los plugins de transporte de aprobaciones conservaban approvals.timeout y agent.clarify_timeout, porque una notificación push sí puede quedarse sin ver y los botones de plataforma caducan.
Mecánicamente era un par de ContextVar por turno —set_prompts_wait_for_answer() / reset_prompts_wait_for_answer()— más un resolver, approval_wait_seconds(), que devolvía el máximo seguro para la plataforma cuando el interruptor estaba activado y approvals.timeout en caso contrario. El prompt de la CLI, el bucle de sondeo de aprobaciones del gateway de la TUI/escritorio y el techo de espera humana leían todos ese único punto de entrada.
Como instinto de producto, resulta atractivo: te levantas a por agua, vuelves, el prompt sigue ahí y no pierdes la operación.
Por qué se revirtió esa noche
A las 04:23 CST del 2 de octubre, el PR #130826 revirtió todo. El cuerpo del revert da tres razones, dos de ellas bloqueadores duros.
Primero, la dirección ya se había rechazado antes de fusionarse. La primera línea del revert es contundente: «los prompts de espera infinita fueron rechazados como dirección antes de que se fusionara #130167». Eso es un fallo de proceso, no técnico.
Segundo, rompió hermes chat -q. Esta es la que de verdad importaba. El modo de consulta única no tiene supervisión: no hay nadie sentado ahí para responder. Quitar el plazo a un prompt de aprobación significa que la sesión espera indefinidamente una respuesta que nunca va a llegar: simplemente se colgaba. Upstream tuvo que publicar un parche de seguimiento (82c63c505a9) para devolver a chat -q su plazo, y este revert se lleva ese parche consigo, porque parchear el cuelgue era su única razón de existir.
Tercero, un test end-to-end empezó a fallar en cada ejecución. tests/e2e/core/providers/test_native_codex_app_server_faults.py fallaba en cada ejecución e2e sobre main hasta que ese mismo parche de seguimiento arregló la única superficie que tocaba.
La escala del rollback: 11 commits más el seguimiento dependiente, cubriendo 57 archivos, todos idénticos byte a byte a su estado previo a #130167 (5 archivos llevan commits posteriores no relacionados que se mantienen intactos). Lo que volvió es el comportamiento que ves hoy: los paneles de aprobación de la CLI y de la TUI/escritorio hacen la cuenta atrás y deniegan en el timeout configurado, las peticiones de aclaración vuelven a llevar su plazo, un turno de grupo en Bot Mode bloqueado esperando a un usuario conserva su tope duro de 3 horas, y los docs, el texto de ajustes y los strings de locale se restauraron.
Un detalle que merece la pena guardar: el cambio nunca llegó a una release. El tag más reciente por aquel entonces era v2026.9.24 (versión v0.21.5, publicada el 24 de septiembre) y #130167 se fusionó el 1 de octubre. Solo las instalaciones que seguían main llegaron a ver el prompt de espera infinita; los usuarios de release nunca.
Qué enseñan realmente esas 11 horas
Quita la mecánica de en medio y quedan tres reglas útiles.
Un plazo es un mecanismo de seguridad, no un estorbo de UX. La cuenta atrás conlleva una responsabilidad: cuando nadie confirma, el sistema tiene que poder detenerse por su cuenta. Quítalo y «sin supervisión» pasa a ser «colgado para siempre», que es peor que una denegación: una denegación empuja al agente a buscar otra ruta, mientras que un cuelgue solo se acumula. Si los prompts te molestan, los botones correctos son la duración del timeout y el modo de aprobación, no la ausencia de timeout.
«¿Hay alguien que pueda responder?» va en la intención, no en la duración de la espera. Una sesión -q, un cron job y un trigger de webhook son radicalmente distintos de ti sentado ante una terminal. Hermes da a cada uno un interruptor explícito: approvals.single_query_mode, approvals.cron_mode y approvals.unattended_mode, cada uno deny o approve, cada uno por defecto deny, porque en esas superficies bloquear al instante y dejar que el agente rodee el bloqueo es mejor que agotar un timeout entero y fallar en cerrado.
No intentes resolverlo subiendo el timeout a lo bruto. El tope en el código no es decorativo: approvals.timeout se limita al máximo seguro para la plataforma (agent.deadline.MAX_SAFE_TIMEOUT_S, 365 días fuera de Windows) porque un valor mayor desborda time_t dentro de Thread.join / Lock.acquire y hacía caer todos los batches de herramientas en paralelo en macOS en pruebas en vivo. El texto del aviso también está formateado para humanos —300 s se muestra como «5 minutes», 90 s como «90 seconds»—, así que la CLI, el resultado de la herramienta y la tarjeta del gateway dicen lo mismo.
Qué hacer en su lugar
Lee los valores actuales en lugar de adivinar:
hermes config get approvals.timeout
hermes config get approvals.mode
Si 300 s se te queda corto para tus plataformas de mensajería, súbelo, no lo desactives:
hermes config set approvals.timeout 1800Enruta las superficies sin supervisión según la intención, para que decidan de inmediato en lugar de agotar una ventana que nadie va a rellenar:
hermes config set approvals.single_query_mode approve   # confías en tus ejecuciones -q
hermes config set approvals.unattended_mode deny        # los webhooks / API deberían bloquear
Bloquea los comandos que nunca deberían ejecutarse, con una deny list: es una lista glob fnmatch que no distingue mayúsculas, y una coincidencia se bloquea incluso en modo yolo:
approvals:
  deny:
    - "rm -rf *"
    - "DROP DATABASE *"
Para la semántica completa y una forma de probar tus reglas en dry-run, consulta nuestra guía de aprobaciones sin supervisión y el walkthrough de dry-run de aprobaciones. Si usas el modo smart por defecto, approvals.smart_policy añade tus propias reglas al system prompt del revisor.
La conclusión
En una línea: este revert no es una regresión, es un problema correcto entregado al mecanismo equivocado. Un timeout de aprobación es una válvula de seguridad. Si los prompts te molestan, ajusta la duración y el modo; no quites la válvula.
Una corrección nuestra: el post de ayer, prompts de aprobación que esperan hasta ser respondidos, describía el comportamiento de #130167 en aquel momento. Le hemos añadido una nota de actualización. Que upstream diera marcha atrás en cuestión de un día es el desenlace que ese post debió prever y no previó, que es exactamente por lo que procuramos no tratar «recién fusionado» como «decisión final».